
 LinkMeshObservability Data Collection Management
Collector-Flottenmanagement
Einen Collector zu betreiben ist einfach. Eine Flotte ist eine Disziplin.
 Philippe Braxmeier← Zurück zum Blog
Einen einzelnen OpenTelemetry Collector zu betreiben ist ein gelöstes Problem: eine
config.yaml schreiben, den Prozess starten, ihn auf ein Backend richten. Fünfzig über
Produktion, Staging und drei Regionen hinweg zu betreiben ist eine ganz andere Aufgabe.
Jeder Collector ist ein Prozess auf einem Host mit eigener Config, eigener Version und einer
eigenen stillen Art, aus der Reihe zu tanzen — und standardmässig haben Sie keinen zentralen
Ort, das zu sehen, geschweige denn zu ändern.
Collector-Flottenmanagement ist die Disziplin, viele OpenTelemetry Collectors als ein System zu betreiben: sie anzumelden, ihren Zustand zu sehen, Konfiguration zu verteilen, Änderungen sicher auszurollen und die gesamte Flotte aktuell zu halten. Dieser Leitfaden geht durch, was das tatsächlich umfasst, und verweist auf tiefere Beiträge zu jedem Teil.
Was “Flottenmanagement” tatsächlich bedeutet
In kleinem Massstab verwalten Sie Collectors wie jeden Prozess: per SSH rein, die Datei bearbeiten, neu starten. Dieser Ansatz hat eine Obergrenze, und Sie stossen schnell daran. Sobald aus einer Handvoll Collectors eine Flotte wird, tauchen fünf Probleme auf einmal auf:
- Config-Drift. Ein um 3 Uhr nachts auf einem Host angewendeter Hotfix schafft es nie zurück ins Template. Sechs Monate später sind keine zwei Collectors ganz gleich, und niemand weiss, welche Config massgeblich ist. (Mehr dazu, das früh abzufangen: Collector-Config-Drift erkennen.)
- Version-Skew. Collectors werden auf der Version installiert, die in jener Woche aktuell war. Manche tragen ungepatchte CVEs; manchen fehlt ein Receiver, den eine neuere Pipeline braucht. Sie von Hand aligned zu halten skaliert nicht — wie man eine Flotte aktuell hält.
- Keine Sichtbarkeit. Sie können nicht beantworten “ist jeder Collector gesund, und was führt jeder aus?”, ohne sich auf jedem Host einzuloggen.
- Blinde Änderungen. Eine Pipeline vor Ort zu bearbeiten, ohne Vorschau und ohne Diff, ist der Weg, wie ein zu gieriger Filter in die Produktion gelangt und still die Daten verwirft, die Sie brauchten.
- SSH-getriebener Betrieb. Jede Änderung ist manuell, pro Host und unauditiert — das Gegenteil davon, wie Sie den Rest Ihrer Infrastruktur betreiben.
Flottenmanagement ersetzt alle fünf durch eine Control Plane: eine einzige Stelle, die jeden Collector sieht, die massgebliche Konfiguration hält und Änderungen konsistent anwendet.
Die Control Plane: OpAMP und remotecfg
Der Mechanismus unter dem Flottenmanagement ist ein Management-Protokoll. Der Collector öffnet eine ausgehende Verbindung zu einer Control Plane; die Control Plane verteilt Konfiguration hinab und empfängt Status hinauf. Zwei offene Protokolle tun das heute:
- OpAMP (Open Agent Management Protocol) — der OpenTelemetry-Standard zur Fernverwaltung
von Agents. Status hoch, Config runter, Package-Updates. Das Upstream-
otelcol-contribspricht es über den OpAMP-Supervisor. Wir haben einen vollständigen Erklärtext geschrieben: OpAMP erklärt. - remotecfg — Grafana Alloys natives Remote-Konfigurationsprotokoll, polling-basiert statt push. Wenn Ihre Flotte Alloy ist, ist das der Weg. Siehe Grafana Alloy vs. der OpenTelemetry Collector dafür, wie die beiden Collectors sich vergleichen.
Beide sind offen und standarddefiniert, und beide lassen die Daten-Ebene unberührt — Telemetrie fliesst weiterhin direkt vom Collector zu Ihren Backends. Die Management-Verbindung trägt Konfiguration und Health, nicht Ihre Logs und Traces. Ein guter Flottenmanager unterstützt den Collector, den Sie bereits betreiben, statt einen Fork oder einen proprietären Agent zu erzwingen.
Konfiguration als Source of Truth
Sobald eine Control Plane die Konfiguration jedes Collectors hält, sollte diese Konfiguration irgendwo leben, wo Sie sie reviewen, diffen und zurückrollen können — nicht in einer Datenbank, der Sie blind vertrauen müssen. Das stärkste Muster ist GitOps: Jede Pipeline-, Routen- und Processor-Änderung landet als Commit mit Autor, Zeitstempel und Diff.
Das gibt Ihnen drei Dinge, die Flottenbetrieb sonst fehlen: einen Audit-Trail, wer was geändert hat, die Fähigkeit, auf jeden früheren Stand zurückzurollen, und Code-Review für Telemetrie-Änderungen auf dieselbe Weise, wie Sie Anwendungscode reviewen. Wir behandeln das Muster in GitOps für Collector-Konfiguration, und die Sicherheitsmechanik — gestufter Rollout, Health-Gating und das Zurücknehmen einer schlechten Änderung — in Collector-Config-Rollout und -Rollback.
Die verwandte Disziplin ist, nicht blind auszuliefern. Bevor ein Filter oder Transform die Flotte erreicht, wollen Sie sehen, wie ein echter Record auf der einen Seite des Processors hineingeht und auf der anderen herauskommt — die Pipeline vorschauen, bevor Sie sie ausliefern.
Was Sie mit der Flotte tun, sobald Sie sie verwalten können
Zentrale Verwaltung ist nicht das Ziel an sich — sie ist das, was die nützliche Arbeit erst möglich macht:
- An der Quelle verfeinern. Health-Check-Rauschen verwerfen, sampeln und aggregieren auf dem Collector, bevor Telemetrie je ein berechnetes Backend erreicht — Observability-Kosten senken und Sampling-Governance im grossen Massstab.
- Sensible Daten schützen. Kreditkarten, E-Mails und eigene Felder auf dem Host maskieren, vor dem Egress — PII in Logs maskieren, bevor sie Ihr Netz verlassen.
- Nach Team und Tenant routen. Die richtigen Daten aus einer Pipeline-Definition an das richtige Backend senden — die Grundlage einer Multi-Tenant-Collector-Architektur.
- Policy durchsetzen. Standards über die gesamte Flotte anwenden, statt zu hoffen, dass jedes Team es richtig macht — OpenTelemetry-Governance und -Durchsetzung.
Wissen, wann ein Collector keine Daten mehr trägt
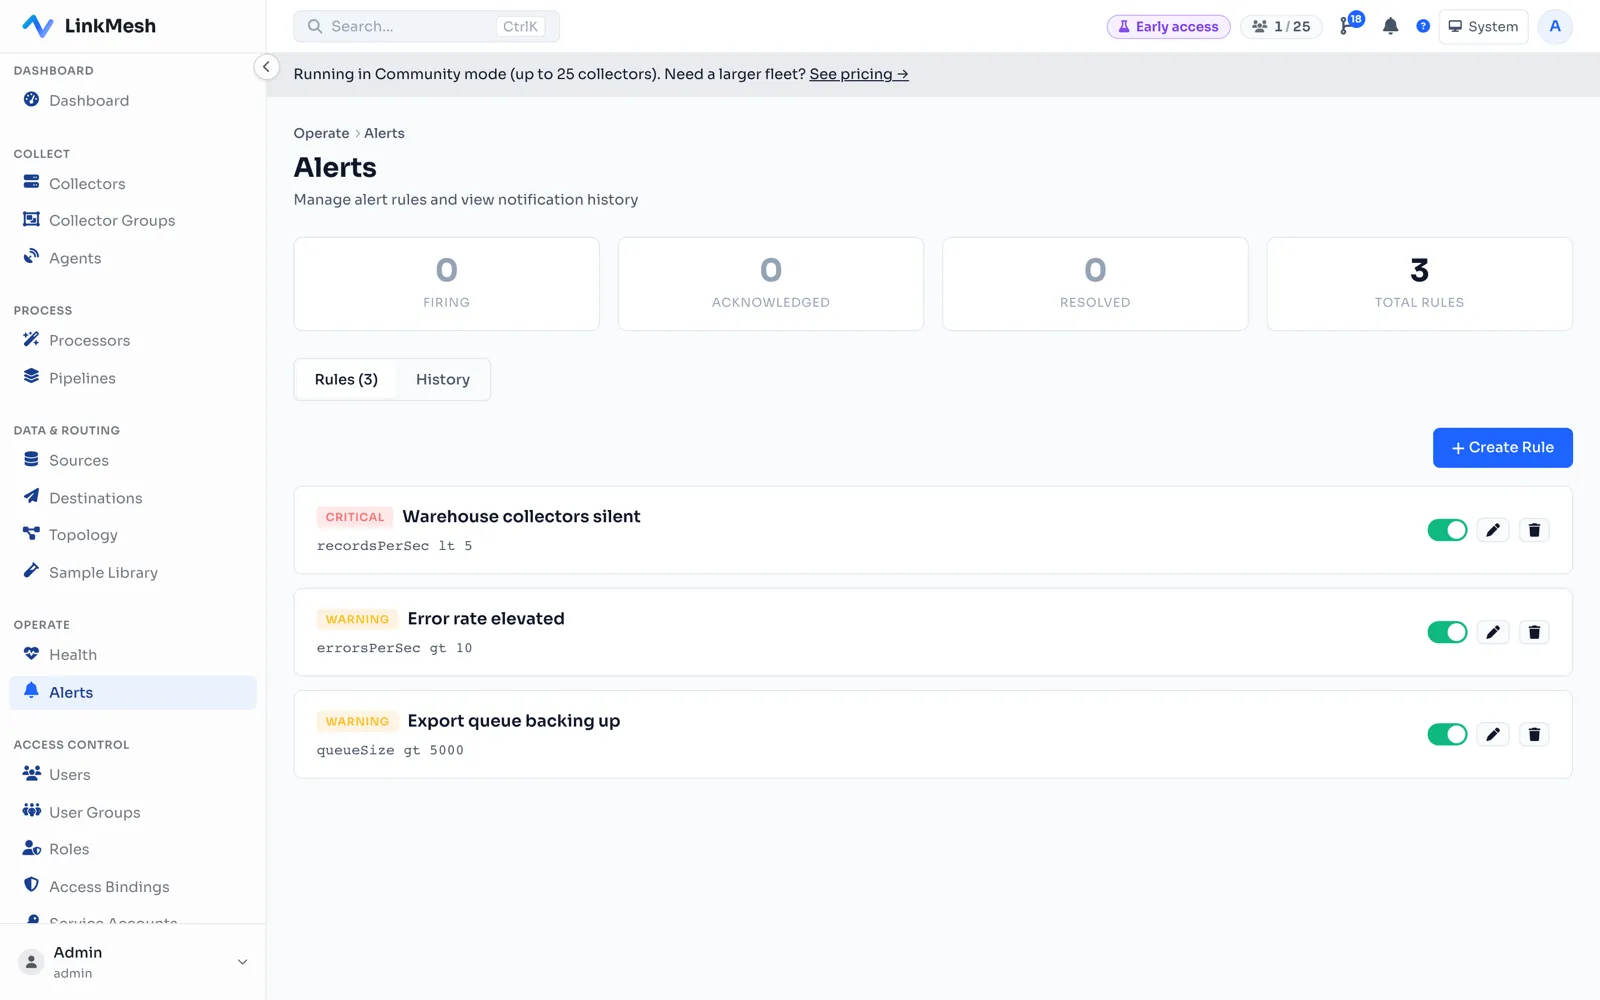
Eine Flotte zentral zu verwalten heisst auch, benachrichtigt zu werden, wenn ein Teil davon verstummt. Ein Collector, der abstürzt, ist offensichtlich. Der schwierigere Fehler ist der, der weiterläuft, sich weiterhin als gesund meldet und einfach nichts mehr empfängt — eine Log-Quelle, die wegrotiert ist, eine geänderte Firewall-Regel, eine Anwendung, die aufgehört hat zu senden. Nichts wirft einen Fehler. Die Daten sind schlicht nicht da.
Das ist ein Schwellenwert auf den Durchsatz, kein Health-Check: Regeln beobachten die Rate der Datensätze, die durch jeden Collector fliessen, und feuern, wenn sie eine Linie überschreitet, die Sie gesetzt haben.
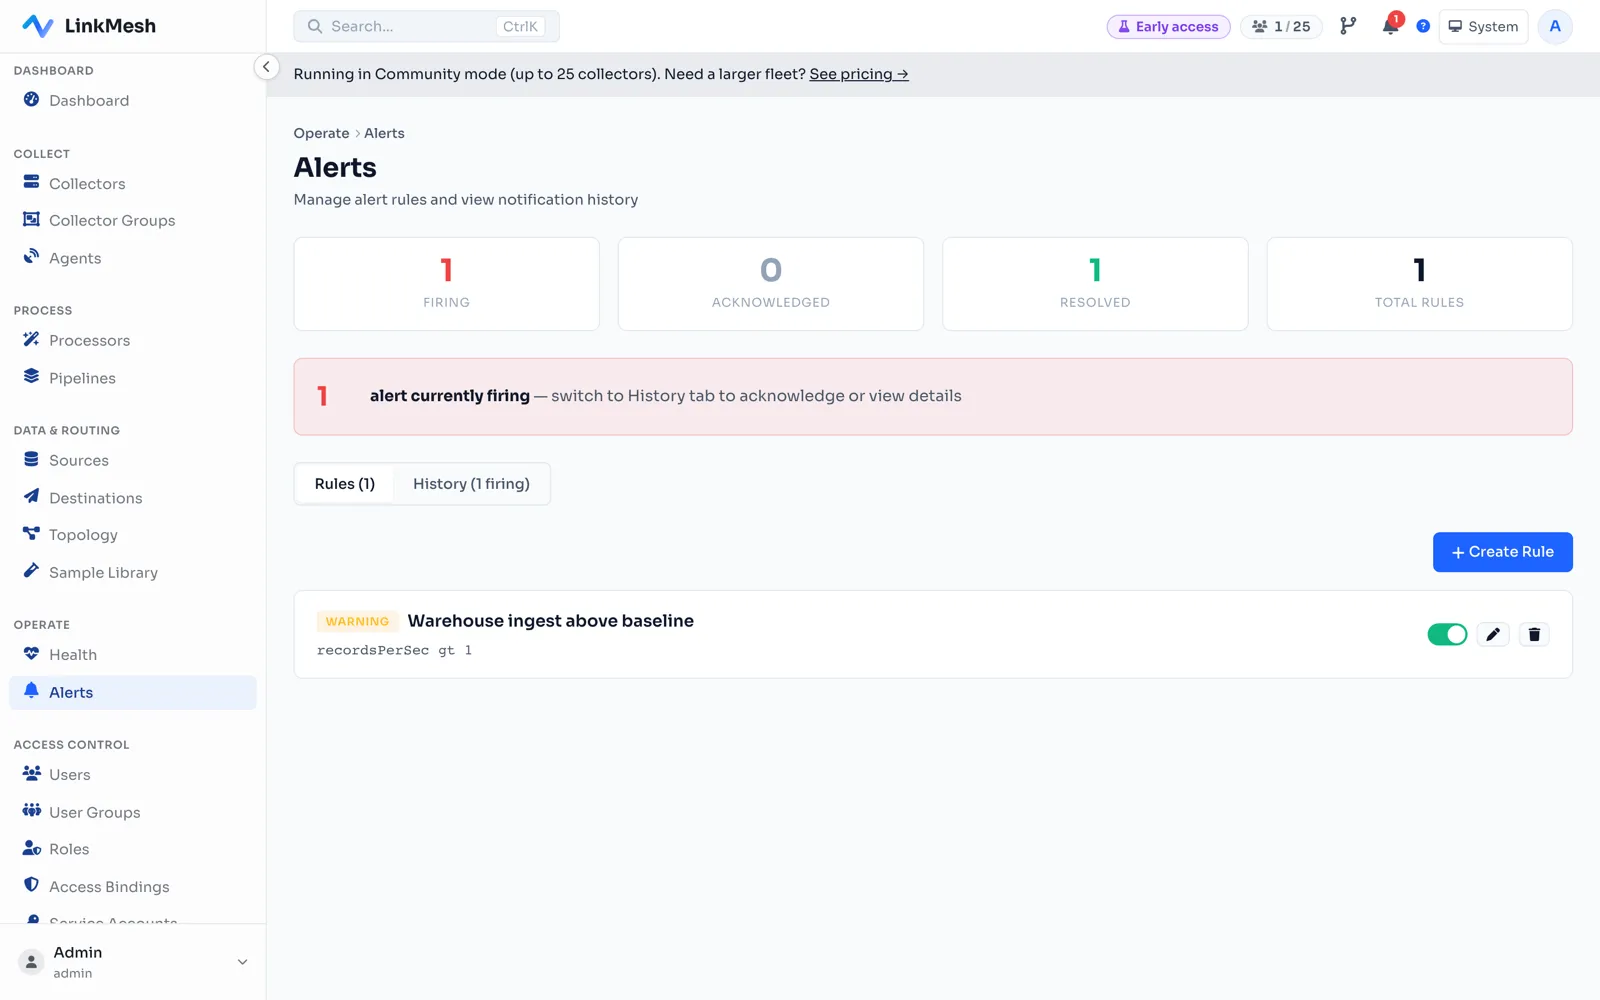
Weil die Rate aus den eigenen Metriken des Collectors gemessen und nicht aus einem Backend erschlossen wird, deckt derselbe Mechanismus beide Richtungen ab — zu viele ankommende Daten, und gar keine.
Die Flotte skalieren
Wächst die Flotte, werden zwei weitere Anliegen erstklassig. Die Control Plane selbst sollte kein Single Point of Failure sein, und die Collectors, die Ihre Telemetrie tragen, ebenso wenig — siehe OpenTelemetry-Collector-High-Availability. Und sobald mehrere Teams die Plattform teilen, hören Isolation und Pro-Tenant-Routing auf, optional zu sein; der Multi-Tenant-Architektur-Leitfaden behandelt, wie man Tenants getrennt hält, ohne für jeden eine eigene Flotte zu betreiben.
Build oder Buy
OpAMP ist ein offenes Protokoll, Sie können also mit Bibliotheken wie opamp-go Ihre eigene
Control Plane bauen. Für ein Team mit der Engineering-Kapazität und ungewöhnlichen
Anforderungen ist das ein legitimer Weg. Der Haken ist alles rund um das Protokoll: ein
Config-Store, ein Flotten-UI, Authentifizierung, Pipeline-Editing, Masking, Routing, ein
Audit-Trail, Durchsatz-Metering — und die laufende Wartung von all dem. Genau dieser Abstand
zwischen dem rohen Protokoll und einem funktionierenden Produkt ist die
Control-Plane-Lücke, die OpAMP bewusst offenlässt — und genau das
zu füllen, dafür existiert ein Flottenmanager.
Wo LinkMesh passt
LinkMesh ist ein Flottenmanager, gebaut genau um diesen Workflow. Collectors melden sich über
eine einzige Verbindung an — otelcol-contrib via OpAMP oder Grafana Alloy via remotecfg,
kein Fork — und das Flotten-UI zeigt Status, Version, Durchsatz und Config-Zustand für jeden
Node. Konfiguration ist GitOps-auditiert; Pipelines werden vor dem Ausliefern vorgeschaut; PII
wird an der Quelle maskiert; und Routing sendet die richtigen Daten an das richtige Backend.
Es läuft auf Ihrer eigenen Infrastruktur und ist pro verwaltetem Collector berechnet statt nach
Datenvolumen.
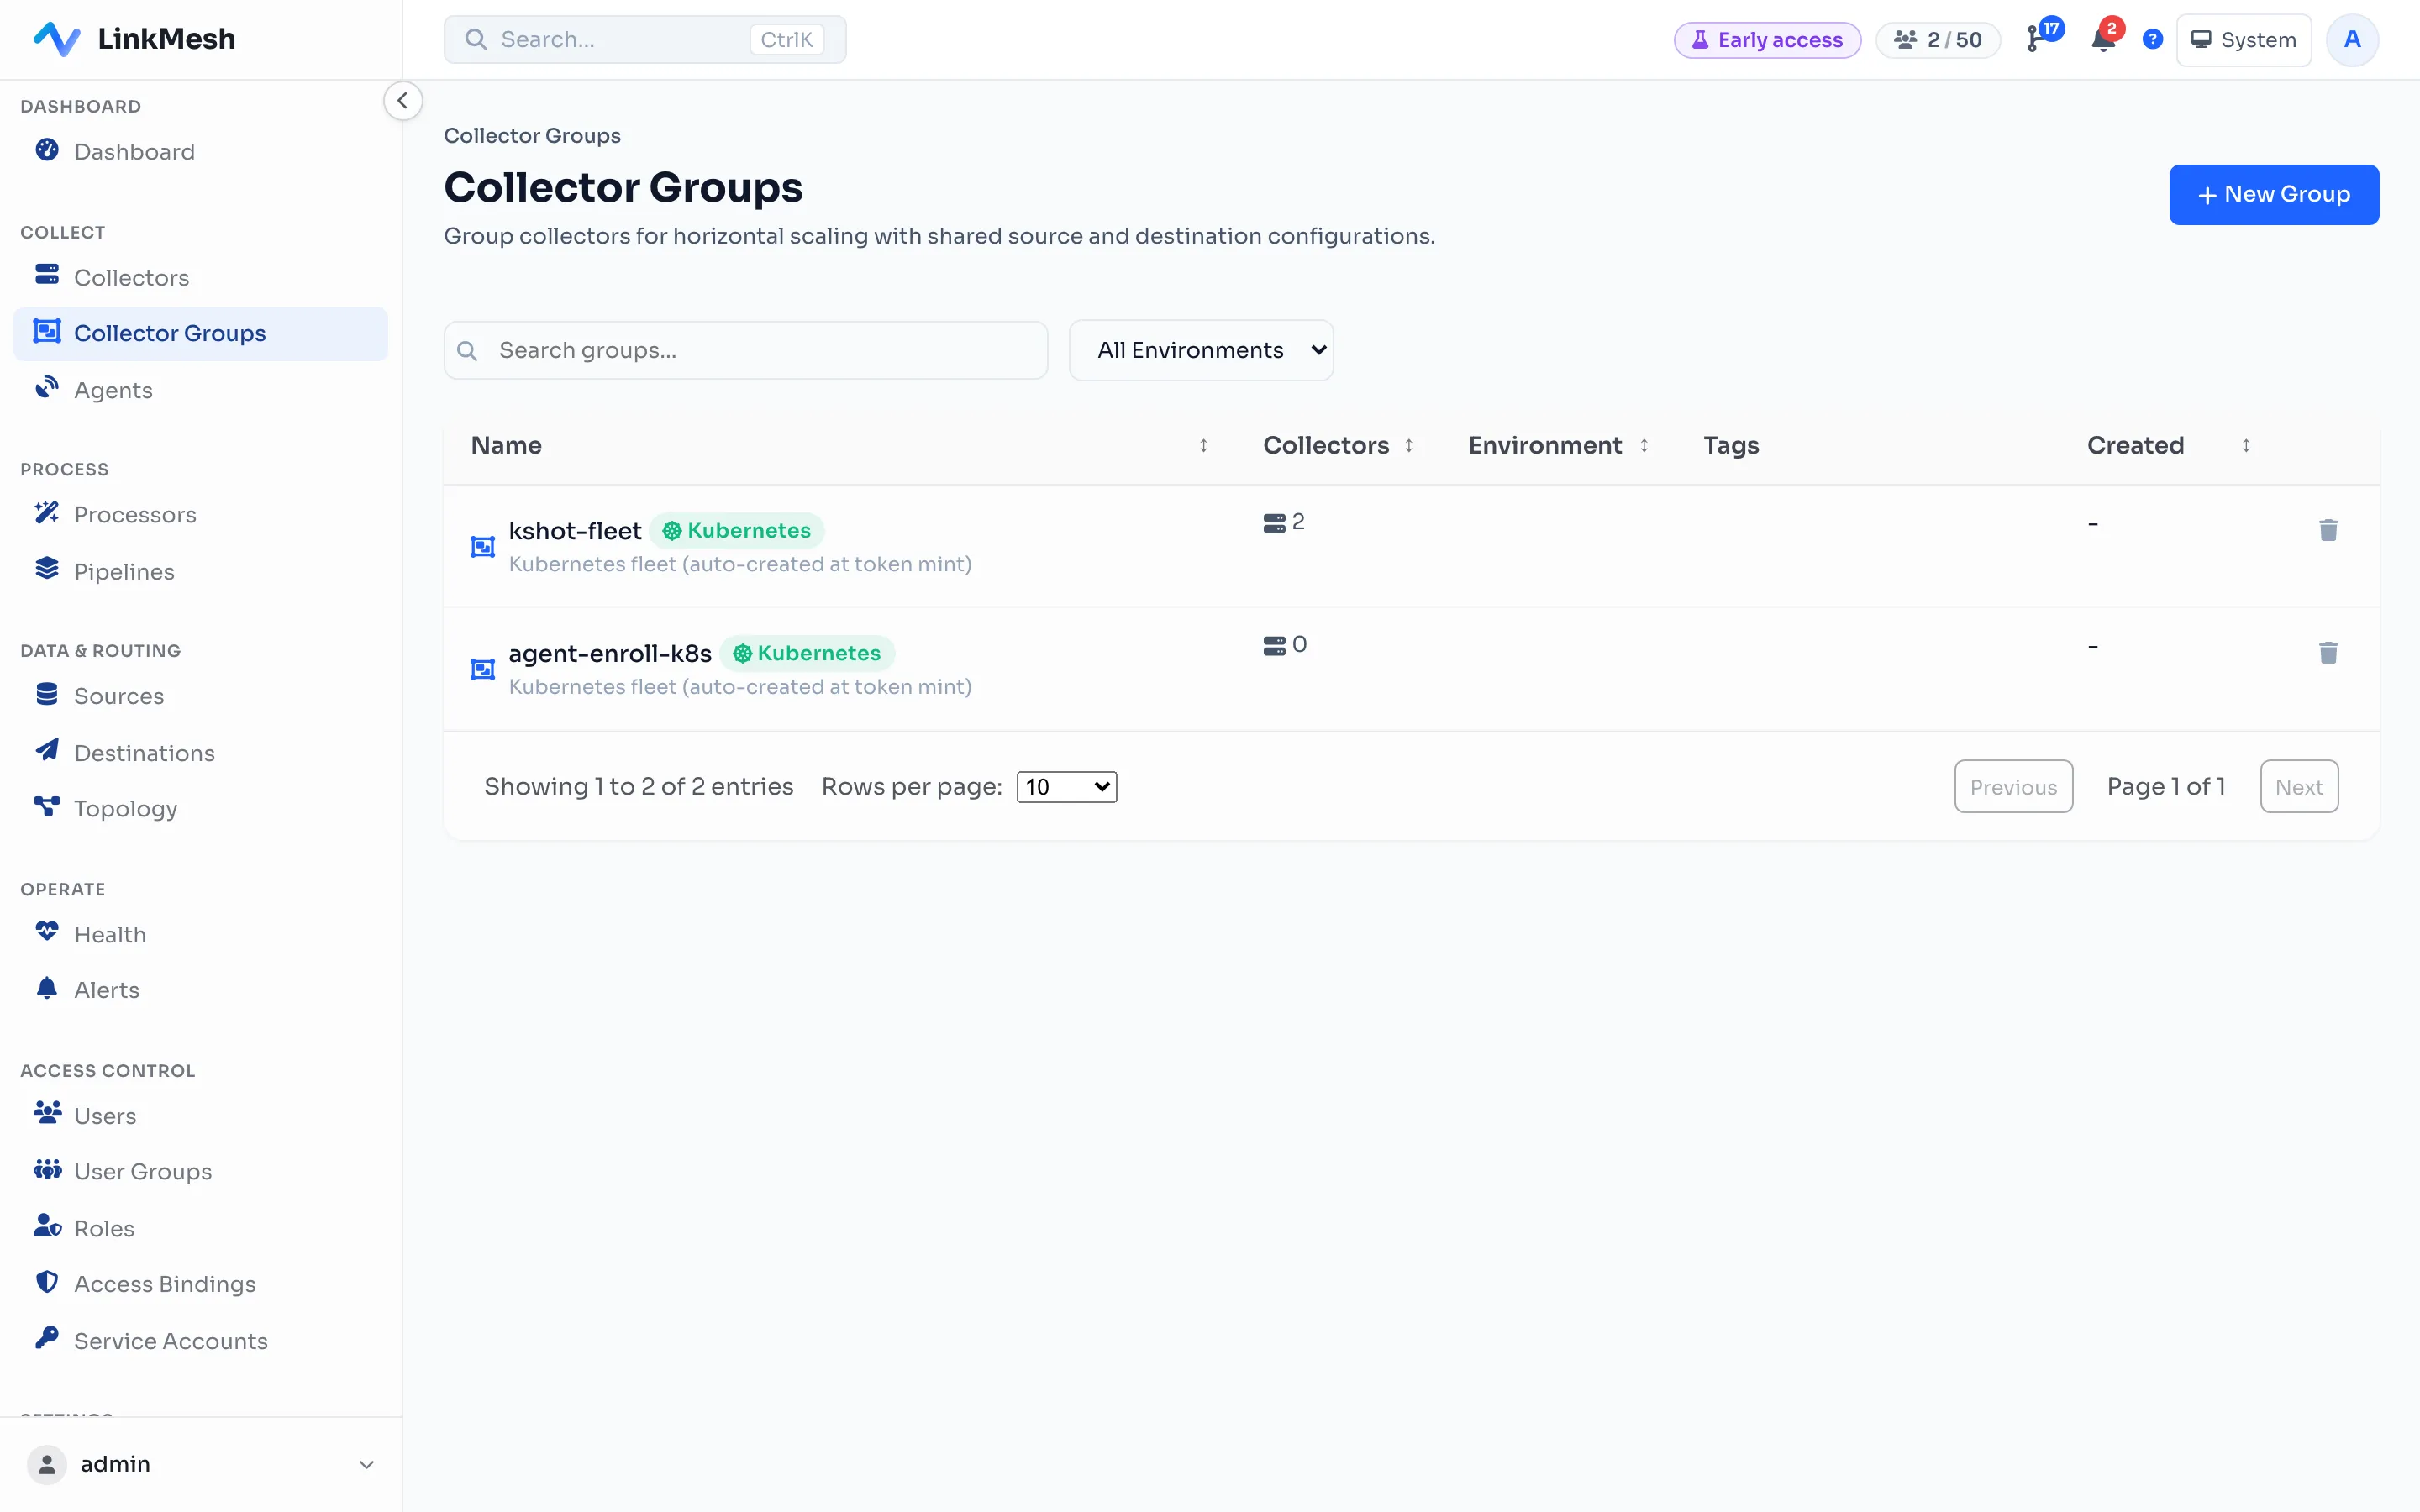
Collectors organisieren sich in typisierte Gruppen — eine Kubernetes-Cluster-Flotte ist anders getaggt als eine VM-Host-Gruppe, und jede trägt ihre eigene geteilte Config —, sodass selbst ein grosser Bestand auf einen Blick lesbar bleibt:
Sehen Sie, was LinkMesh kann, die Details zu On-Prem und Datenverarbeitung und Preise pro Collector — die ersten 25 Collectors sind nach kostenloser Registrierung im OpenSight Customer Portal gratis (5 ohne Registrierung). Wenn Sie so weit sind, installieren Sie es und melden Sie Ihren ersten Collector in etwa zehn Minuten an.