
 LinkMeshObservability Data Collection Management
Sampling-Governance
Konsistentes, sicheres, kosteneffizientes Sampling über die gesamte Flotte.
 Roman Hüsler← Zurück zum Blog
Sampling ist der stärkste Kostenhebel in einer Telemetrie-Pipeline – und der, der einem am ehesten um die Ohren fliegt. Verwerfen Sie 90 % Ihrer Traces, und Ihre Rechnung sinkt um fast ebenso viel – aber verwerfen Sie die falschen 90 %, und Sie haben sich genau für die Vorfälle blind gemacht, für deren Aufklärung Sie Telemetrie überhaupt vorhalten. Der Hebel ist real; die Gefahr besteht darin, dass er meist von demjenigen gezogen wird, der in einem bestimmten Quartal Kostendruck verspürte, in demjenigen Service, den er zufällig verantwortete, ohne jede Abstimmung mit dem Rest der Flotte.
Das ist der Unterschied zwischen Sampling betreiben und Sampling governen. In diesem Leitfaden geht es um das Zweite: Sampling über eine ganze Collector-Flotte hinweg konsistent zu machen, standardmässig sicher und zentral gesetzt, sodass niemand still die Genauigkeit verändert, auf die sich alle anderen verlassen. Wir behandeln Tail- gegenüber Head-Sampling, die goldene Regel, die verhindert, dass Sampling Ihre Vorfälle verdeckt, warum Konsistenz über Services hinweg nicht verhandelbar ist, und wie man die Raten governt, statt sie dem Zufall zu überlassen.
Platform-Leads, SREs und Observability-Verantwortliche, die für Telemetrie über viele Services und Teams hinweg zuständig sind – alle, die eine Trace-Rechnung gegen die Angst abwägen, ausgerechnet den Trace zu verpassen, der den nächsten Ausfall erklärt. Voraussetzungen: eine Flotte von OpenTelemetry Collectors und die Befugnis, zu standardisieren, wie Sampling darüber konfiguriert wird.
Head- vs. Tail-Sampling: der zentrale Kompromiss
Es gibt zwei Momente, in denen Sie entscheiden können, ob Sie einen Trace behalten, und sie verhalten sich sehr unterschiedlich.
Head-Sampling entscheidet beim Ingest, bevor der Trace vollständig ist, meist auf Basis
einer festen Wahrscheinlichkeit. Der probabilistic_sampler des Collectors ist das
Arbeitspferd:
processors:
  probabilistic_sampler:
    sampling_percentage: 15
Das behält 15 % des Flusses und verwirft den Rest, günstig und zustandslos – kein Puffern, keine Erinnerung an den Trace. Der Haken: Weil es entscheidet, bevor es weiss, wie der Trace ausgegangen ist, kann es die interessanten nicht bevorzugt behalten. Ein Fehler-Trace hat dieselbe 15-%-Überlebenschance wie ein langweiliger Erfolg. Es ist schnell und vorhersagbar, aber blind für den Ausgang.
Tail-Sampling wartet, bis der Trace (weitgehend) vollständig ist, und entscheidet dann
auf Basis dessen, was tatsächlich passiert ist – behalten Sie ihn, wenn irgendein Span fehlschlug,
wenn die Latenz einen Schwellenwert überschritt, wenn er einen sensiblen Service berührte. Der
tail_sampling-Processor hält Spans im Speicher, bis er den gesamten Trace beurteilen kann:
processors:
  tail_sampling:
    decision_wait: 10s
    policies:
      - name: keep-errors
        type: status_code
        status_code: { status_codes: [ERROR] }
      - name: keep-slow
        type: latency
        latency: { threshold_ms: 1000 }
      - name: sample-the-rest
        type: probabilistic
        probabilistic: { sampling_percentage: 10 }
Tail-Sampling ist weitaus intelligenter, aber teurer im Betrieb: Es puffert Spans für das
decision_wait-Fenster, benötigt Speicher proportional zu den laufenden Traces und – ganz
entscheidend – erfordert, dass alle Spans eines Trace dieselbe Collector-Instanz
erreichen, was einschränkt, wie Sie deployen (typischerweise eine Tail-Sampling-Ebene mit
Trace-ID-bewusstem Load Balancing davor). Head-Sampling hat keine dieser Anforderungen. Die
meisten ausgereiften Flotten nutzen beides: günstiges Head-Sampling, um offensichtliche Masse
abzuwerfen, und eine Tail-Sampling-Ebene, um die klugen Keep-/Drop-Entscheidungen über den
Rest zu treffen.
Die goldene Regel: sample niemals Ihre Fehler weg
Welchen Mechanismus Sie auch nutzen, eine Regel bestimmt alles davon: Behalten Sie 100 % der Traces, die Sie wirklich brauchen, und samplen Sie nur den langweiligen Happy Path. Konkret, behalten Sie immer:
- Fehler – alles mit einem Nicht-OK-Status. Das sind die Traces, die Sie während eines Vorfalls öffnen; sie zu samplen bedeutet, Ihr Debugging wegzusamplen.
- Langsame Traces – alles jenseits eines Latenzschwellwerts, denn in der Tail-Latenz wohnen die interessanten Probleme.
- Sicherheits- und compliance-relevante Traces – Auth-Flows, Zahlungspfade, alles, was Sie für ein Audit oder eine Untersuchung womöglich rekonstruieren müssen.
Erst nachdem diese bedingungslos behalten werden, samplen Sie die volumenstarke, erfolgreiche, unauffällige Mehrheit – die ohnehin fast Ihr gesamtes Volumen ausmacht. Genau das kodiert die Tail-Sampling-Policy oben: zuerst explizite Keep-Regeln für Fehler und langsame Traces, dann eine probabilistische Policy für alles, was durchfällt. Samplen Sie das auf die falsche Weise über, und Sie verlieren nicht nur Daten, Sie verlieren sie genau dann, wenn es zählt – das ist der Fehlermodus, der Menschen dazu bringt, Sampling gänzlich zu misstrauen.
Konsistenz: ein halb behaltener Trace ist ein verlorener Trace
Hier ist das subtile Versagen, das verteiltes Sampling beisst. Ein einzelner Trace durchquert viele Services. Wenn jeder Service unabhängig mit 15 % eine Münze wirft, ist die Wahrscheinlichkeit, dass jeder Hop seinen Span behält, verschwindend gering – Sie landen bei Traces, die in Service A vorhanden, in Service B fehlend, in C wieder vorhanden sind. Ein teilweise gesampelter Trace ist oft schlimmer als gar kein Trace: Er sieht vollständig aus, aber die Lücke liegt genau dort, wo Sie hinschauen mussten.
Die Lösung ist konsistentes, deterministisches Sampling, das auf der Trace-ID basiert.
Statt eines unabhängigen Münzwurfs pro Service hasht jeder Collector die Trace-ID und wendet
denselben Schwellenwert an, sodass ein bestimmter Trace entweder überall behalten oder überall
verworfen wird. Der probabilistic_sampler tut dies, wenn er für Trace-ID-basiertes
konsistentes Sampling konfiguriert ist, und das Ökosystem standardisiert sich auf konsistentes
Probability-Sampling (der W3C-Trace-Context tracestate trägt den Sampling-Schwellenwert,
sodass nachgelagerte Sampler übereinstimmen). Die praktische Anforderung: jeder Collector im
Pfad muss denselben Hash und dieselbe Rate verwenden. Zwei Services, die mit
unterschiedlichen Prozentsätzen oder mit unterschiedlichen Salts samplen, führen die Löcher
wieder ein, die Sie schliessen wollten. Konsistenz über die Flotte hinweg ist keine
Annehmlichkeit – sie ist das, was einen gesampelten Trace überhaupt erst brauchbar macht.
Governe die Rate zentral, nicht pro Team
Bringe nun diese beiden Fakten zusammen – Sampling muss Fehler behalten, und es muss über jeden Service hinweg konsistent sein – und die betriebsmodellbezogene Schlussfolgerung ist unausweichlich: Sampling-Raten können keine Pro-Team-Einstellung sein. Wenn Team A seinen Service mit 5 % und Team B mit 50 % sampelt, sind Traces, die beide durchqueren, konstruktionsbedingt inkonsistent, und niemand hat einen flottenweiten Überblick darüber, welche Genauigkeit tatsächlich überlebt. Schlimmer noch: Ein Team, das seine Rate leise herunterdreht, um eigene Kosten zu senken, verschlechtert still alle, deren Traces durch seinen Service laufen – eine Entscheidung mit flottenweitem Wirkungsradius, getroffen in der Config eines einzigen Repos.
Zentrale Governance bedeutet, dass die Sampling-Policy – die Keep-Errors-Regeln, die Basisrate, das Trace-ID-Keying – einmal definiert und einheitlich angewendet wird, sodass:
- Genauigkeit eine bekannte Grösse ist. Sie können „welchen Anteil erfolgreicher Traces behalten wir, überall?“ mit einer Zahl beantworten, nicht mit einem Achselzucken.
- Keine stillen Genauigkeitsänderungen. Niemand senkt die Rate auf einem kritischen Pfad, ohne dass die Änderung sichtbar, reviewt und versioniert ist.
- Kosten und Sicherheit gemeinsam abgestimmt werden. Die Rate ist der Kostenhebel und der Sichtbarkeitshebel; sie zentral zu besitzen ist der einzige Weg, sie bewusst statt reaktiv auszubalancieren.
Das ist dasselbe Argument wie bei Governance-Durchsetzung im Allgemeinen: Eine Policy, die davon abhängt, dass jedes Team daran denkt, sie gleich zu konfigurieren, ist nicht governt, sondern erhofft. Sampling macht die Einsätze nur ungewöhnlich greifbar.
Vorschau, bevor Sie schneiden
Sampling-Änderungen sind gerade deshalb beängstigend, weil das, was Sie entfernen, unsichtbar ist, bis Sie es brauchen. Zwei Sicherungen helfen. Für filterbasierte Drop-Regeln – die expliziten „Debug-Logs verwerfen“-, „Health-Checks verwerfen“-Regeln – zeigen Sie die Wirkung der Regel an einem erfassten Sample in der Vorschau, bevor sie ausgerollt wird, und sieh genau, welche Datensätze überleben. Für die Sampling-Policy selbst ist die Sicherung ein Prozess: zentral zusammenstellen, validieren, versionieren und als eine einzige reviewte Änderung ausrollen statt als Pro-Team-Edit.
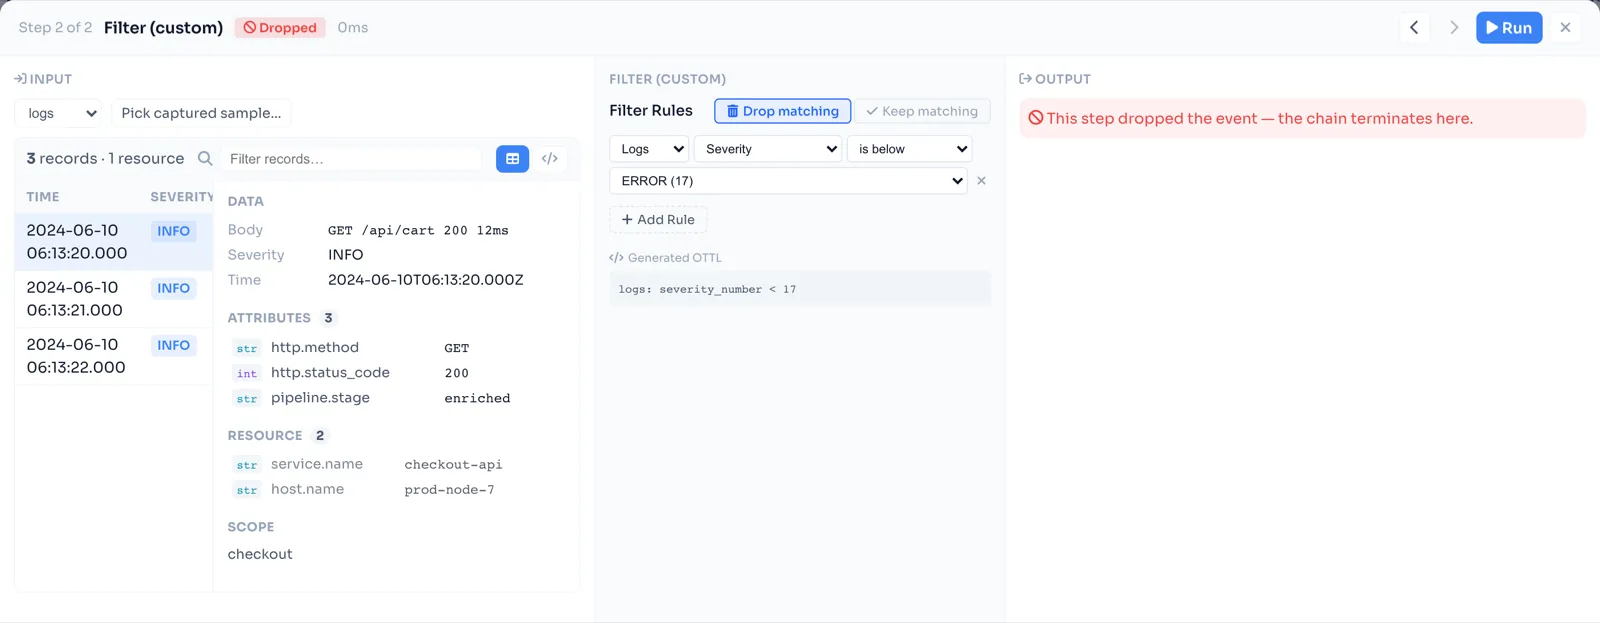
Das ist das Modell, für das LinkMesh gebaut ist: Sie stellen die Sampling-Policy einmal zusammen, zeigen Ihre Filter-Drop-Regeln an echten erfassten Datensätzen in der Vorschau und liefern die Config an die Flotte aus, sodass jeder Collector dieselbe Rate und dieselben Keep-Regeln anwendet – konstruktionsbedingt konsistent, versioniert und auditierbar. Weil die Rate in einer governten Config statt in einem Dutzend Team-Repos lebt, ist eine Änderung der Genauigkeit ein bewusster, sichtbarer Akt, und die Kosteneinsparungen treten ein, ohne dass jemand still erblindet. (Wo Sampling zwischen Filtern und Routing sitzt, siehe was eine Telemetrie-Pipeline ist.)
Wo anfangen
- Setzen Sie zuerst die goldene Regel. Bevor Sie irgendeine Rate anfassen, fügen Sie explizite Keep-Policies für Fehler, langsame Traces und sicherheitsrelevante Pfade hinzu, sodass nichts Wichtiges je für ein Verwerfen infrage kommt.
- Head-sample die offensichtliche Masse. Wenden Sie konsistentes, Trace-ID-basiertes probabilistisches Sampling auf Ihren volumenstärksten, wertärmsten erfolgreichen Verkehr an.
- Fügen Sie eine Tail-Sampling-Ebene hinzu, wenn Sie ausgangsbewusste Entscheidungen brauchen, und akzeptieren Sie die Puffer- und Trace-Affinitäts-Einschränkungen, die sie mitbringt.
- Verlagern Sie die Rate in die zentrale Config, sodass sie eine einzige governte Zahl ist, einheitlich angewendet, sichtbar geändert – niemals ein Pro-Team-Regler.
Beiläufig betriebenes Sampling ist, wie Teams entweder überzahlen oder erblinden. Governtes Sampling – Fehler stets behalten, Konsistenz garantiert, Raten zentral besessen – ist, wie Sie die Kostensenkung erzielen und den Trace behalten, der den Ausfall erklärt. Die Mechanismen stecken im Collector; die Disziplin liegt darin, wer die Rate ändern darf.
Mit LinkMesh stellen Sie eine einzige Sampling-Policy zusammen – Fehler stets behalten, konsistentes Trace-ID-Keying, eine einzige governte Rate – zeigen Ihre Filter-Drop-Regeln an echten Datensätzen in der Vorschau und liefern sie an die Flotte (OpAMP-Push oder remotecfg-Pull), sodass jeder Collector übereinstimmt. Versioniert, auditiert, pro Collector bepreist. Richten Sie eines ein in Minuten, oder sehen Sie sich an, was es kann.