
 LinkMeshObservability Data Collection Management
Ein Agent für alles
Forwarder, OneAgent und Beats abbauen. Einen Collector behalten.
 Roman Hüsler← Zurück zum Blog
Melden Sie sich auf einem produktiven Host in einem gewachsenen Bestand an und zählen Sie die
Monitoring-Prozesse. Ein Splunk Universal Forwarder, der /var/log liest. Ein Datadog Agent,
der dieselben Dateien plus /proc abgreift. Ein Dynatrace OneAgent, der in die JVM injiziert
ist. Vielleicht ein Node Exporter, weil jemand Prometheus wollte. Vier Agents, vier
Konfigurationsmechanismen, vier Upgrade-Zyklen, vier Sätze ausgehender Zugangsdaten — und alle
lesen im Wesentlichen dieselben Daten von derselben Platte.
Das hat niemand so entworfen. Es ist gewachsen, eine Beschaffungsentscheidung nach der anderen, und jede Schicht davon ist für sich genommen begründbar. Der Grund, es jetzt anzusehen: Mit OpenTelemetry wird die Erfassungsschicht endlich zu etwas, das Sie unabhängig von den Backends besitzen können — ein Agent auf dem Host, mehrere Ziele dahinter. Dieser Beitrag behandelt gezielt die Agent-Seite dieses Schritts: wie Sie Monitoring-Agents auf einen einzigen OpenTelemetry Collector konsolidieren, in welcher Reihenfolge, und was die Konsolidierung tatsächlich nicht übersteht.
Plattform-, SRE- und Observability-Teams, die einen Agent-Bestand verantworten — mehrere Hersteller-Agents pro Host, mehrere Verlängerungstermine und Druck auf Kosten oder auf den Change-Aufwand, sie alle zu patchen. Voraussetzungen: Sie können einen Collector ausrollen (systemd, Container oder DaemonSet) und wissen grob, welcher Agent welches Backend speist.
Was „ein Agent für alles” wirklich bedeutet
Die Formulierung verspricht in einem Punkt zu viel, und diesen Punkt vorab präzise zu benennen ist es, was das Projekt im dritten Monat nicht ins Stocken bringt.
Ein einzelner OpenTelemetry Collector ersetzt die Funktion Erfassen und Weiterleiten bei jedem Hersteller-Agent, den Sie betreiben: Dateien lesen, Host-Metriken erheben, Syslog empfangen, Windows-Ereignisprotokolle abholen, OTLP von instrumentierten Anwendungen annehmen und alles davon weiterschicken. Diese Funktion ist echte Standardware, und sie in vier Implementierungen zu betreiben ist reine Doppelarbeit.
Was ein Collector nicht ersetzt, ist die herstellerspezifische Tiefe, die manche dieser Agents mitbringen — die Bytecode-Injektion und PurePath von Dynatrace, die Live-Processes-Ansicht von Datadog, die Ingest-Pipeline-Bibliothek von Elastic. Das sind Produkte, nicht Erfassung. Die ehrliche Einordnung lautet deshalb nicht „ein Agent ersetzt vier”, sondern „ein Agent ersetzt vier Collectoren, und Sie entscheiden bewusst, wie Sie mit den zwei oder drei Fähigkeiten umgehen, die mit ihnen gebündelt waren”. Was OpenTelemetry ersetzen kann und was nicht ist die ausführliche Fassung dieses Satzes.
Warum vier Agents pro Host der Normalfall sind
Agent-Wildwuchs ist eine Folge davon, wie Erfassung verkauft wurde, nicht der Unachtsamkeit einzelner:
- Jeder Agent war an ein Backend geschweisst. Ein Universal Forwarder speist Splunk. Ein Datadog Agent speist Datadog. Ein Backend zu wählen bedeutete, seinen Agent zu akzeptieren — und damit wurde jede Backend-Entscheidung zu einem flottenweiten Rollout.
- Niemand verantwortet den Host als Ganzes. Das SOC besitzt den Forwarder, das Applikationsteam den APM-Agent, das Plattformteam den Exporter. Jede Entscheidung ist lokal vernünftig, und für die Summe ist niemand zuständig.
- Einen Agent zu entfernen ist riskanter, als einen hinzuzufügen. Hinzufügen bricht nichts Sichtbares. Entfernen beendet möglicherweise still eine Detection, auf die sich jemand verlässt — also ist es immer der sichere Weg, ihn laufen zu lassen.
- Verlängerungen sind zeitversetzt. Wenn ein Vertrag ansteht, laufen die anderen drei mitten in der Laufzeit; „alles konsolidieren” passt nie zu einem Budgetzyklus.
Die Kosten sind genauso konkret: Sie bezahlen zwei oder drei Anbieter dafür, dieselbe Logzeile aufzunehmen, Plattformen mit Abrechnung pro überwachtem Host können eine Maschine doppelt zählen, der Ressourcen-Fussabdruck vervielfacht sich auf Maschinen, die für die Last und nicht für das Monitoring dimensioniert wurden, und jeder Agent hat seine eigene Vorstellung davon, wie der Host heisst — Korrelation über Backends hinweg heisst also, drei Namensschemata abzugleichen. Der Beitrag zu mehreren Backends behandelt die Auffächerung; hier ist die Prozessanzahl selbst das Ziel.
Die Konsolidierungs-Landkarte
Fast alles davon ist ein Tausch Komponente gegen Komponente. Zu den Eingängen jedes verbreiteten Hersteller-Agents gibt es ein OpenTelemetry-Gegenstück:
| Hersteller-Agent | OpenTelemetry-Ersatz | Backend behalten? |
|---|---|---|
| Splunk Universal Forwarder | filelog-, windowseventlog-, journald-Receiver |
Ja — splunk_hec-Exporter |
| Splunk Heavy Forwarder (Routing) | routing-Connector + mehrere Exporter |
Ja |
| Datadog Agent (Infra-Checks) | hostmetrics- + prometheus-Receiver |
Ja — datadog-Exporter |
Datadog Trace Agent / dd-trace |
otlp-Receiver + OTel SDKs |
Ja |
| Dynatrace OneAgent (Host + Logs) | hostmetrics- + filelog-Receiver |
Ja — OTLP-Ingest-Endpunkt |
| Elastic Agent / Beats | filelog-, hostmetrics-, windowseventlog-Receiver |
Ja — elasticsearch-Exporter |
| Azure Monitor Agent (DCR-basiert) | filelog + windowseventlog, weiterexportiert |
Ja — über einen Sentinel-Pfad |
| Prometheus Node Exporter | hostmetrics-Receiver (oder ihn scrapen) |
Ja — prometheusremotewrite |
| Fluentd / Fluent Bit | filelog-Receiver + OTTL-Prozessoren |
Ja |
| Parsing auf der Ingest-Seite | transform-, filter-, attributes-Prozessoren (OTTL) |
Teilweise — manches bleibt indexseitig |
Die wichtigste Spalte ist die dritte. Agents zu konsolidieren erfordert keine einzige Backend-Änderung. Zu jedem dieser Ziele gibt es einen unterstützten Exporter oder einen OTLP-Endpunkt, und damit ist die erste Phase dieser Arbeit für jedes Dashboard, jeden Alarm und jede gespeicherte Suche unsichtbar. Genau das macht sie genehmigungsfähig: keine für Anwender sichtbare Änderung. Die herstellerspezifischen Details stehen in den eigenen Leitfäden — Splunk, Datadog, Dynatrace und Elastic.
Wie ein Collector auf dem Host aussieht
Die vier Agents fallen zu einem Prozess mit einer Konfiguration zusammen. Receiver links, die gemeinsame Arbeit in der Mitte, die alten Ziele rechts:
receivers:
  filelog:
    include: [/var/log/*.log, /var/log/app/*.json]
    start_at: end
  journald:
  hostmetrics:
    collection_interval: 30s
    scrapers: { cpu: , memory: , disk: , filesystem: , network: , load: }
  otlp:
    protocols:
      grpc:
        endpoint: 127.0.0.1:4317

processors:
  resourcedetection:
    detectors: [env, system]
  transform/redact:
    log_statements:
      - context: log
        statements:
          - replace_pattern(body, "\\b\\d{13,16}\\b", "[REDACTED]")
  batch:

exporters:
  splunk_hec:
    endpoint: "https://hec.internal:8088/services/collector"
    index: "main"
  otlphttp/apm:
    endpoint: "https://apm.internal:4318"
  prometheusremotewrite:
    endpoint: "https://prom.internal/api/v1/write"

service:
  pipelines:
    logs:
      receivers: [filelog, journald]
      processors: [resourcedetection, transform/redact, batch]
      exporters: [splunk_hec]
    metrics:
      receivers: [hostmetrics]
      processors: [resourcedetection, batch]
      exporters: [prometheusremotewrite]
    traces:
      receivers: [otlp]
      processors: [resourcedetection, batch]
      exporters: [otlphttp/apm]
Zwei Eigenschaften dieser Datei sind der Sinn der ganzen Übung. Der Host wird einmal gelesen, Sie bezahlen also nicht länger mehrere Anbieter dafür, dieselben Bytes aufzunehmen. Und die Maskierungsregel steht an einer Stelle — sie kann damit nicht auf dem Weg zu einem Backend korrekt greifen und auf dem Weg zu einem anderen vergessen werden. Genau dieses Fehlerbild macht Maskierungsregeln pro Agent unglaubwürdig. PII-Maskierung in Logs behandelt das im Detail.
Was Sie tatsächlich verlieren
Jeder Konsolidierungsbeitrag, der diesen Abschnitt auslässt, verkauft etwas. Vier Dinge kommen nicht mit, und jedes davon braucht eine Entscheidung statt eines Schulterzuckens:
- Tiefe Auto-Injektion. OTel-Auto-Instrumentierung ist gut und wird besser, aber sie ist nicht so unsichtbar wie die Bytecode-Injektion des OneAgent, und manche Laufzeiten brauchen mehr Einrichtung. Testen Sie die relevanten Sprachen an einem echten Service, bevor Sie sich auf ein Datum festlegen.
- Herstellerspezifische Analytik und Ansichten. Davis-Root-Cause, Live Processes, Smartscape, RUM und Synthetics sind Backend-Produkte. Behalten Sie das Backend, behalten Sie sie — sie erwarten aber möglicherweise den Agent dieses Anbieters, prüfen Sie also, was ohne ihn schlechter wird.
- Kuratierte Inhalte. Hersteller-Agents bringen Integrationskataloge sowie fertige Parser, Dashboards und Detections mit. OTel gibt Ihnen Receiver und OTTL; die Inhalte sind Arbeit, die Sie übernehmen. Unordentliche Logs onboarden zeigt realistisch, was das bedeutet.
- Die eigene Steuerebene des Agents. Das ist der Punkt, der weh tut, und er bekommt unten seinen eigenen Abschnitt.
Es gibt noch eine Kategorie, die gar kein Verlust ist und die genannt werden sollte: die Support-Aussage des Herstellers. Splunk, Elastic, Dynatrace, Datadog und Grafana liefern oder unterstützen heute alle OTel-Collector-Pfade. Die Konsolidierung auf OTel ist bei jedem von ihnen eine unterstützte Richtung, kein Workaround ohne Support.
Ein Agent braucht weiterhin eine Steuerebene
Hier liegt die Falle bei „ein Agent für alles”: Die Agents, die Sie abbauen, brachten zentrale Verwaltung mit. Fleet bei Elastic. Deployment-Gruppen bei Splunk. Dynatrace verteilt OneAgent-Konfiguration und Upgrades selbst. Ersetzen Sie vier verwaltete Agents durch einen unverwalteten, dann haben Sie die Prozessanzahl verbessert und die Verwaltbarkeit verschlechtert — jetzt ist es handverteiltes YAML auf jedem Knoten, und nichts sagt Ihnen, wenn ein Host abdriftet.
Gehen Sie diesen Tausch nicht ein; er ist nicht zwangsläufig. Agent-Verwaltung ist OpAMP, ein offenes Protokoll, und es ist das Stück, das aus dem konsolidierten Agent eine Verbesserung statt einer Seitwärtsbewegung macht: zentrale Konfiguration, Versionen und die Möglichkeit zu sehen, welche Knoten was tatsächlich angewendet haben.
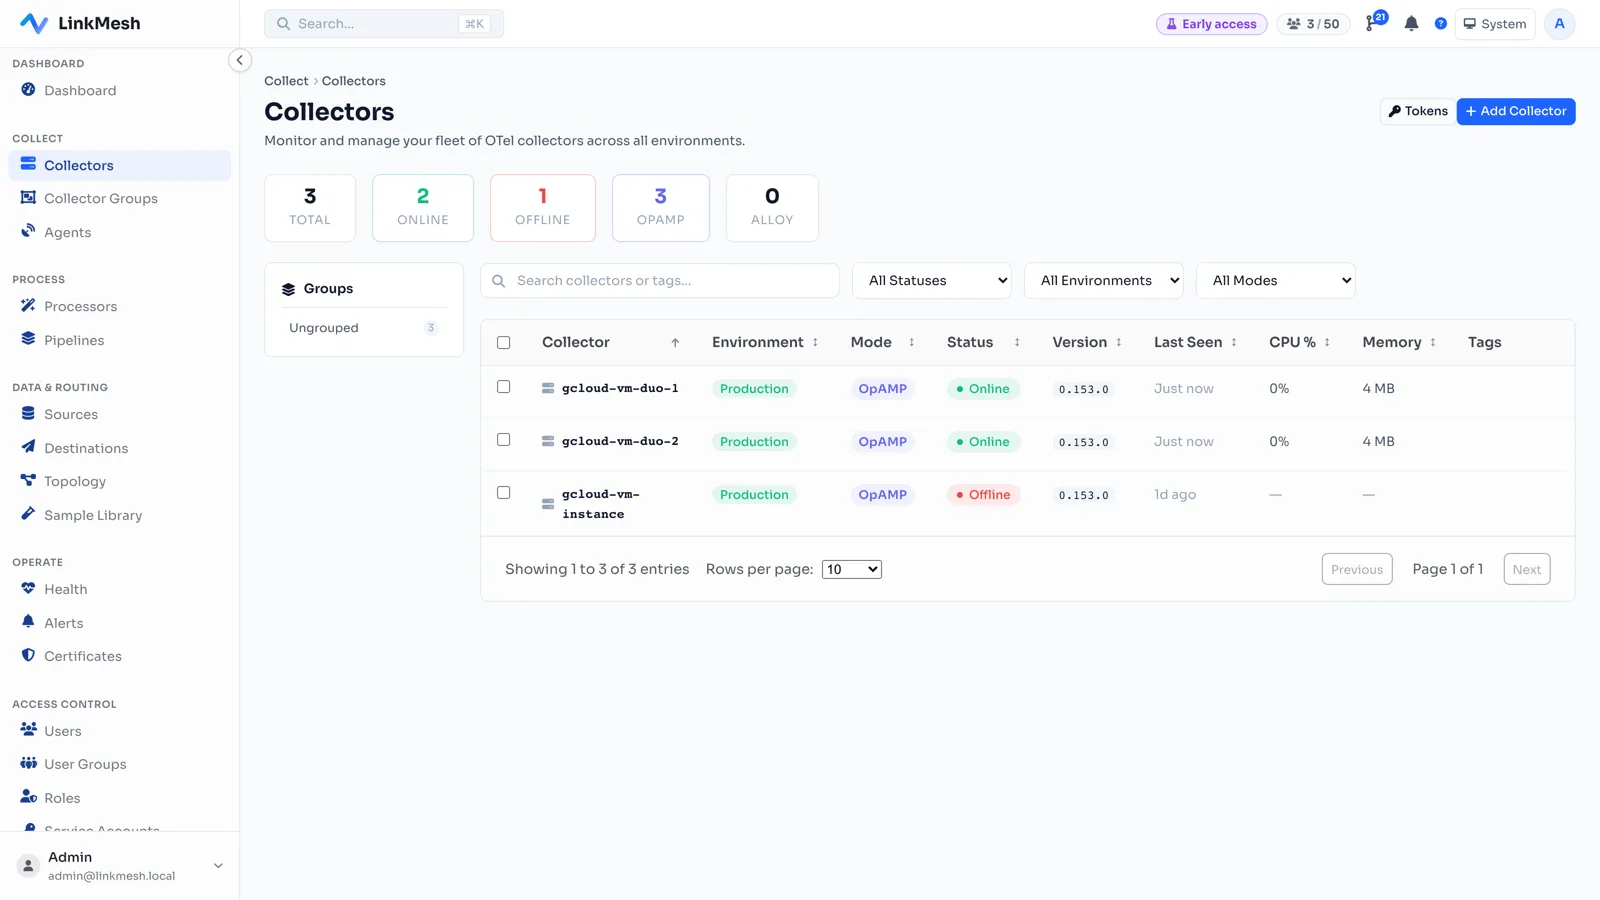
LinkMesh ist genau dafür eine selbst betriebene OpAMP-Steuerebene: Sie richten jeden Collector mit einem Token darauf aus, komponieren Quellen, Prozessoren und Routen in einer visuellen Oberfläche, und LinkMesh rendert, validiert und verteilt die Konfiguration an die richtigen Knoten — mit Durchsatz pro Kante, sodass Sie die verschwundene Doppelerfassung belegen statt annehmen. Weil die Abrechnung pro Collector statt pro GB erfolgt, wird das Werkzeug, das die Konsolidierung verwaltet, nicht selbst nach dem Volumen bemessen, das Sie senken wollen. Konfigurationsänderungen sind versioniert und prüfbar (GitOps für Collector-Konfiguration), und Abweichungen von der gewollten Konfiguration sind erkennbar (Konfigurationsdrift erkennen).
In der Reihenfolge konsolidieren, die das Risiko nimmt
Die Reihenfolge zählt mehr als das Werkzeug. Jeder Schritt ist umkehrbar, und keiner davon ist ein Stichtag:
- Zählen Sie die Agents auf einem repräsentativen Host, mit CPU, Speicher und ausgehendem Volumen pro Agent. Diese Inventur ist üblicherweise die Folie, die das Projekt finanziert.
- Rollen Sie den Collector neben allem anderen aus, zunächst ohne Erfassung oder nur mit einer unkritischen Quelle. Sie weisen Rollout, Enrollment und Upgrade-Pfade nach, nicht Telemetrie.
- Verschieben Sie eine Quelle des unumstrittensten Agents — typisch den Exporter des Plattformteams oder einen nicht sicherheitsrelevanten Logpfad — und exportieren Sie sie an das bestehende Backend dieser Quelle. Nachgelagert ändert sich nichts.
- Prüfen Sie die Parität, dann nehmen Sie dem alten Agent diese Quelle weg. Nicht den Agent: die Quelle. Zwei Prozesse an einer Datei sind der Weg, auf dem ein Host doppelt gezählt wird und jede Zeile zweimal ankommt — siehe Dual-Shipping ohne Duplikate.
- Wiederholen Sie das Quelle für Quelle, bis ein Agent nichts mehr zu tun hat, und bauen Sie ihn dann ab. Agents verschwinden vom Host als Folge verschobener Quellen, nie als eigener Schritt.
- Erst danach senken Sie Volumen. Filtern, Sampling und Verwerfen am Rand ist der grosse finanzielle Gewinn (Observability-Kosten senken), aber solange die Parität noch offen ist, macht es jede Lücke undiagnostizierbar.
- Behalten Sie den APM-Agent am längsten. Tiefes Tracing ist die am schwersten zu ersetzende Fähigkeit; machen Sie Infrastruktur und Logs zuerst und lassen Sie die APM-Entscheidung ein eigenes Projekt sein.
Bevor Sie den ersten Agent abbauen
- Volumenparität pro Quelle zwischen altem Agent und Collector über dasselbe Zeitfenster — eine grosse Lücke ist ein fehlender Eingang oder ein zu scharfer Filter, keine Effizienz.
- Zu jedem Eingang gibt es einen Receiver, einschliesslich Windows-Ereigniskanälen, systemd-Journalen und jedem eigenen Herstellermodul, das vor Jahren jemand ergänzt hat.
- Feldparität bei Zeitstempel, Severity und den zwei oder drei extrahierten Feldern, auf die Ihre Alarme und gespeicherten Suchen tatsächlich zugreifen. OTTL-Parsing unterscheidet sich von grok und von Hersteller-Pipelines, und das ist die häufigste Regression.
- Ressourcenattribute —
service.name, Host und Umgebung — vorhanden und konsistent, damit ein Host über alle Backends hinweg ein Host ist (Semantic Conventions durchsetzen). - Host-Budget geprüft: Ein Collector, der die Arbeit von vier Agents macht, braucht Memory-Limiter und Queue-Dimensionierung bewusst gesetzt, nicht auf Standardwerten (Collector-Sizing).
- Fehlerverhalten getestet: Starten Sie den Collector neu und trennen Sie ein Ziel. Er muss puffern und fortsetzen, ohne Daten zu verlieren oder sich festzufahren (Collector-Hochverfügbarkeit).
- Der alte Agent bleibt installiert, aber untätig für ein vereinbartes Beobachtungsfenster — ein bis zwei vollständige Geschäftszyklen — damit ein Rollback ein Konfigurations-Push ist und kein neues Rollout.
Ein Agent für alles ist ein erreichbares Ergebnis, und ungewöhnlich für diese Branche verlangt es von niemandem, sein Backend, seine Dashboards oder seine Verlängerung aufzugeben. Es verlangt, die Erfassung Quelle für Quelle aus der Hand der Anbieter zu nehmen — und die Flotte dabei verwaltet zu halten.
LinkMesh ersetzt die Hersteller-Agent-Konsolen durch eine selbst betriebene OpAMP-Steuerebene für Ihre OpenTelemetry-Flotte — Collector-Konfiguration in einer Oberfläche bauen und validieren, eine Änderung vor dem Ausrollen vorab prüfen, an die richtigen Knoten verteilen und am Durchsatz pro Kante belegen, dass die Doppelerfassung wirklich weg ist. Abrechnung pro Collector, nicht pro GB. Sehen Sie, was es kann, oder stellen Sie eines auf — in wenigen Minuten.