
 LinkMeshObservability Data Collection Management
Config-Drift erkennen
Wenn ein Node nicht mehr die Config ausführt, die Sie glauben.
 Roman Hüsler← Zurück zum Blog
Sie glauben, Ihre OpenTelemetry-Collector-Flotte führt eine bekannte Menge an Policies aus — PII maskiert, Rauschen gefiltert, Attribute standardisiert, Daten nur an genehmigte Backends geroutet. Drift ist die Lücke zwischen diesem Glauben und der Realität: einer oder mehrere Nodes, deren laufende Config still von der Config abgewichen ist, die Sie beabsichtigt haben. Nichts brennt, kein Alert feuert — der Node führt fröhlich eine Config aus, die eine Policy verletzt, die Sie für universell hielten.
Diese Stille ist es, die Drift gefährlich macht. Ein abgestürzter Collector ist offensichtlich; ein Collector, der seit dem Incident vom letzten Dienstag eine unmaskierte Pipeline ausführt, ist unsichtbar, bis ein Auditor, eine Rechnung oder eine Datenpanne ihn für Sie findet. Dieser Leitfaden behandelt, wie Drift entsteht, warum er teuer ist, wie man ihn erkennt und wie man ihn ganz verhindert.
Platform Leads, SREs und Security-/Compliance-Verantwortliche, die dafür zuständig sind, was eine Flotte von OpenTelemetry-Collectorn tatsächlich tut — nicht was die Doku sagt, dass sie tun sollte. Voraussetzungen: eine Collector-Flotte und eine Vorstellung einer beabsichtigten Config (ein Repo, ein Template, eine Policy), der die Flotte entsprechen soll. Verwandt: Governance-Enforcement.
Wie Drift entsteht
Drift ist selten böswillig. Er ist der angesammelte Rückstand des normalen operativen Lebens:
- Hand-Edits während Incidents. Um 3 Uhr morgens verbindet sich jemand per SSH auf einen Node, passt einen Filter an, um eine Flut zu stoppen, oder erhöht eine Queue-Size, stellt den Service wieder her — und nimmt es nie zurück. Der Notfall-Edit wird durch Unaufmerksamkeit dauerhaft.
- Unvollständige Rollouts. Ein Config-Push schlägt auf einer Teilmenge von Nodes fehl, oder ein Canary wurde nie ausgeweitet, sodass ein Teil der Flotte die neue Version und ein Teil die alte ausführt. Beide sind „gültig”; keine ist einheitlich.
- Nie zurückgenommene manuelle Hotfixes. Eine einmalige Änderung, um ein Team zu entblocken, wird vergessen, sobald der Druck weg ist. Der Fix überlebt den Grund für ihn.
- Version-Skew. Neue Nodes kommen aus einem Template hoch, das ein paar Versionen hinterher ist, oder ein Autoscaler startet Instanzen mit einer veralteten eingebackenen Config. Die Flotte schichtet sich langsam in Config-Generationen auf.
Nichts davon wirft einen Error. Jedes hinterlässt einfach einen Node, der etwas anderes ausführt als das, was Sie glauben.
Warum Drift gefährlich ist
Der Grund, warum Drift zählt, ist, dass genau die Dinge, die eine Collector-Config steuert, die sind, die man sich nicht leisten kann, still falsch zu bekommen:
- Stille Policy-Verletzungen. Ein Node, dessen Redaction-Processor herausbearbeitet wurde, verschickt unmaskierte PII über das Netzwerk — ein Compliance-Incident, der keinen Error und keinen Alert erzeugt, nur eine Haftung.
- Kostenexplosionen. Ein Filter oder Sampler, der weggedriftet ist — oder während eines Incidents gelockert wurde —, lässt einen hochvolumigen Stream ungesampelt durch, und das erste Anzeichen ist die Rechnung des nächsten Monats, die die Arbeit aus dem Senken von Observability-Kosten zunichtemacht.
- Nicht zuordenbare Daten. Ein Node, dem seine
resource-Attribute fehlen, sendet Telemetrie ohneservice.name, Environment oder Owner, sodass sie nicht zugeordnet, abgefragt oder verrechnet werden kann — und still die Dashboards für alle verschmutzt.
Der gemeinsame Faden ist, dass Drift Governance bricht, ohne etwas Sichtbares zu brechen. Die Policy ist auf dem Papier und auf dem Grossteil der Flotte noch wahr; sie ist einfach hier nicht wahr, und nichts sagt es Ihnen.
Wie man Drift erkennt
Drift zu erkennen bedeutet, kontinuierlich eine Frage zu beantworten: Stimmt die Config, die jeder Node tatsächlich ausführt, mit der Config überein, die wir für ihn beabsichtigt haben? Ein paar ergänzende Techniken:
- Laufende Config gegen die Source of Truth vergleichen. Ziehen Sie die effektive Config jedes Nodes und diffen Sie sie gegen die versionierte Config, die er ausführen soll. Jeder Unterschied ist Drift, Punkt.
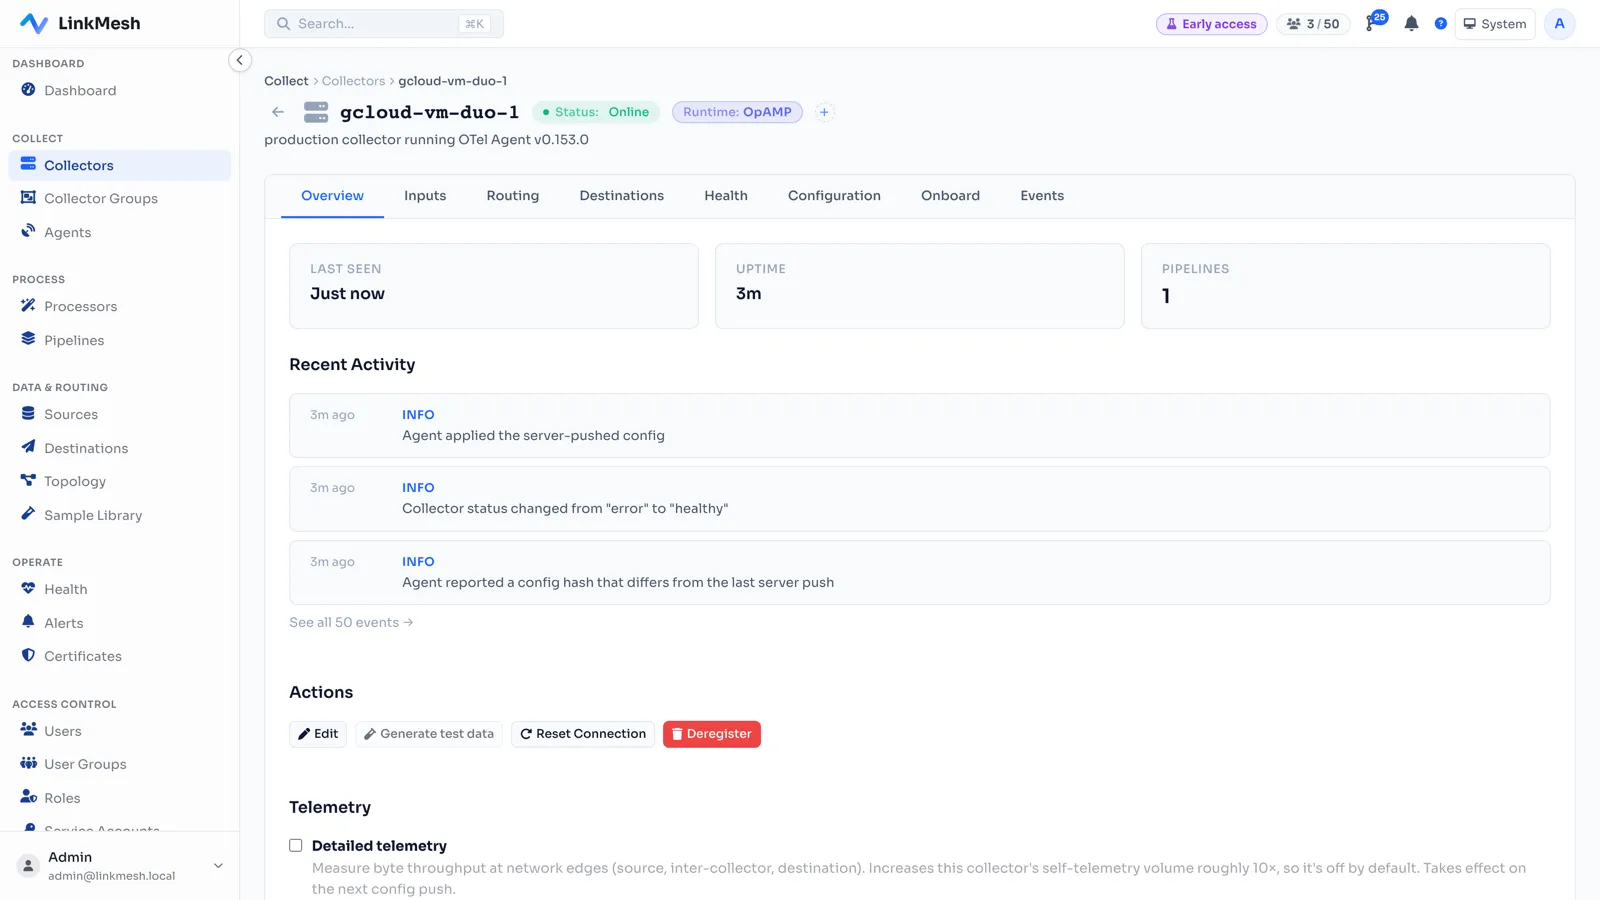
- Version- und Hash-Prüfungen. Hänge an jede Config eine Version oder einen Content-Hash an und lass jeden Node den Hash melden, den er ausführt. Den gemeldeten Hash mit dem beabsichtigten Hash zu vergleichen, ist eine günstige, kontinuierliche Drift-Prüfung über die gesamte Flotte — eine Abweichung ist eine Markierung ohne vollen Diff.
- Config-Apply-Audit-Events. Zeichnen Sie jedes Apply auf — wer, was, wann, welche Version —, sodass eine Out-of-band-Änderung (ein Hand-Edit, der nicht über den normalen Pfad kam) als ein Node auftaucht, dessen laufender Zustand kein entsprechendes Apply-Event hat.
# Hash the config a node is actually running and compare to intended
sha256sum /etc/otelcol/config.yaml | awk '{print $1}'
# -> 9f7c...   (intended: a1b2...)  => DRIFT
Ad-hoc-Skripte wie dieses funktionieren für eine Handvoll Nodes, aber sie sind eine Momentaufnahme, kein Wächter — sie sagen Ihnen von Drift, nachdem er passiert ist, und nur wenn Sie daran denken, sie auszuführen. Die stärkere Position ist eine Flotte, in der Drift gar nicht erst Fuss fassen kann.
Wie eine Control Plane Drift verhindert
Erkennung sagt Ihnen, dass Drift passiert ist; Prävention verhindert, dass er passiert. Der strukturelle Fix ist, die zentrale Config autoritativ zu machen, sodass der lokale Zustand eines Nodes nicht abweichen und abweichend bleiben kann. Genau das ermöglicht OpAMP, das Open Agent Management Protocol: Ein zentraler Server besitzt die Config jedes Collectors und rollt sie auf die Flotte aus. Wenn der Server die Source of Truth ist, hören lokale Hand-Edits auf, autoritativ zu sein — die zugewiesene Config ist das, was läuft, und ein Out-of-band-Edit wird entweder beim nächsten Sync überschrieben oder als Abweichung aufgezeigt, statt still zu bestehen.
Das kehrt das ganze Problem um. Mit rohen YAML-Dateien ist die laufende Config autoritativ und das Repo eine hoffnungsvolle Kopie; Drift ist der Standard und Erkennung eine lästige Pflicht. Mit einer Control Plane ist die zentrale Version autoritativ und die Aufgabe jedes Nodes ist, ihr zu entsprechen; Drift ist die Ausnahme und per Konstruktion sichtbar.
LinkMesh ist eine selbst gehostete Control Plane, die genau auf diesem Modell aufbaut. Die Config, die Sie zentral zusammenstellen, ist die Source of Truth; sie wird gerendert, validiert und über OpAMP auf die richtigen Nodes ausgerollt, und weil die Control Plane sie besitzt, ist ein Hand-Edit auf einer Box nicht die Autorität — die erzwungene Config ist es. Jede Änderung ist versioniert und auditiert (GitOps-Stil), sodass „welche Nodes entsprechen dem Beabsichtigten, und wer hat was wann geändert” immer eine Antwort hat. Es ist derselbe Mechanismus hinter sicherem Rollout und Rollback, GitOps für Collector-Config und Governance-Enforcement: eine autoritative Config, einheitlich angewendet, drift-frei per Design statt per Wachsamkeit.
Wo man anfängt
Sie brauchen keine Control Plane, um zu beginnen — Sie müssen aufhören, überrascht zu werden:
-
Eine beabsichtigte Config etablieren. Versionieren Sie sie. Wenn es keine Source of Truth gibt, gibt es nichts, wovon etwas driften kann, und nichts, wogegen man erkennen kann.
-
Jeden Node melden lassen, was er ausführt. Eine Version oder ein Hash pro Node verwandelt „sind wir in sync?” in einen Vergleich statt in eine Vermutung.
-
Kontinuierlich vergleichen und bei Abweichung alarmieren. Ein täglicher Diff von laufend-gegen-beabsichtigt fängt Drift innerhalb eines Tages ab, statt zur Audit-Zeit.
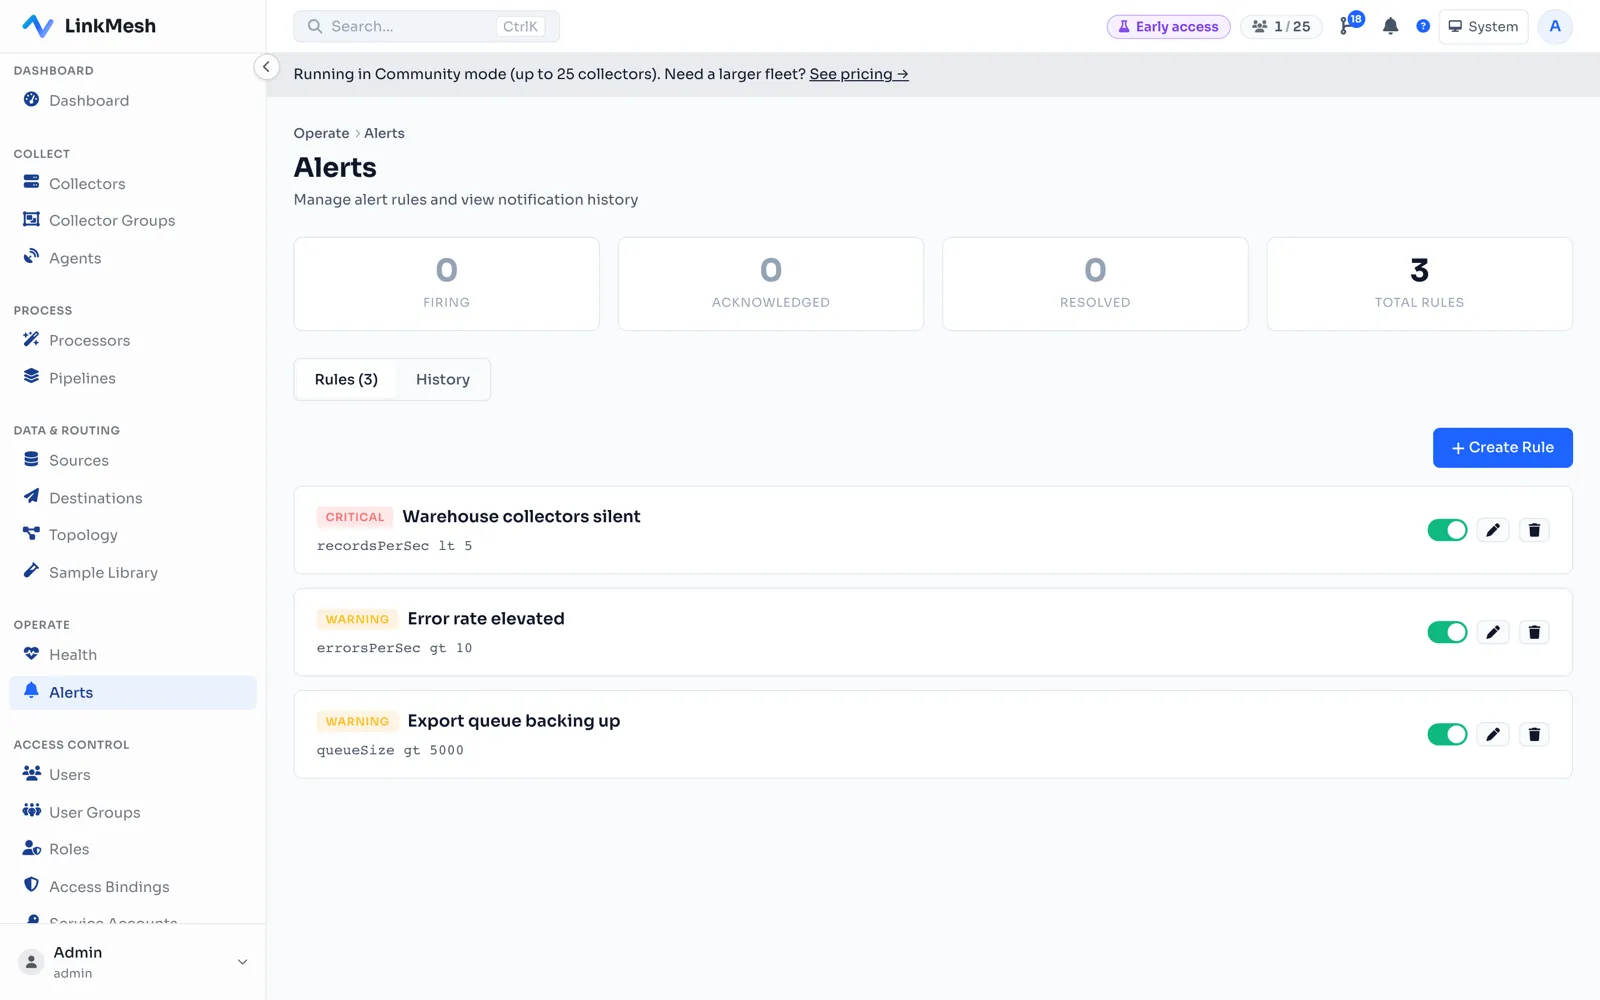
Drift, die verändert, was ein Collector trägt, zeigt sich auch in seinem Durchsatz: Ein Filter, der still angedriftet ist, verwirft Volumen; einer, der weggedriftet ist, fügt welches hinzu. Ein Schwellenwert auf Datensätze pro Sekunde fängt diese Klasse von Drift in dem Moment ab, in dem sie die Daten verändert, ohne auf den nächsten Diff zu warten.
-
Dann die zentrale Config autoritativ machen. Wechseln Sie zu OpAMP-verwalteter Config, sodass lokale Edits nicht die Autorität sein können — was Drift von etwas, das man erkennt, in etwas verwandelt, das grösstenteils gar nicht passieren kann.
Drift ist das langsame Leck in jeder von Hand verwalteten Flotte. Sie können es mit Erkennung ausschöpfen, oder Sie können es mit einer autoritativen Control Plane abdichten — und Letzteres ist um 3 Uhr morgens deutlich weniger Arbeit.
LinkMesh macht die zentrale Config zur Source of Truth: zusammengestellt, validiert, versioniert und über OpAMP ausgerollt, sodass lokale Hand-Edits aufhören, autoritativ zu sein — drift-frei per Design, mit einem Audit-Trail jeder angewendeten Änderung. Selbst gehostet, pro Collector bepreist. Jetzt loslegen in Minuten, oder ansehen, was es kann.