
 LinkMeshObservability Data Collection Management
Governance & Durchsetzung
Verwandeln Sie Telemetrie-Policy in Regeln, die tatsächlich gelten.
 Philippe Braxmeier← Zurück zum Blog
Jedes Observability-Programm schreibt irgendwann ein Policy-Dokument. „PII maskieren, bevor sie den Host verlassen.” „Keine Debug-Logs an das teure Backend schicken.” „Jedes Signal mit einem Team und einer Umgebung versehen.” „Nur diese Ziele sind freigegeben.” Es ist ein gutes Dokument. Es ist in den meisten Organisationen aber auch völlig ungenutzt – ein PDF, das beschreibt, was passieren sollte, während jedes Team seine eigene Collector-Konfiguration betreibt und tut, was es will.
Diese Lücke zwischen Policy und Pipeline ist der Ort, an dem Governance scheitert. Eine Regel, die in einem Wiki lebt und darauf angewiesen ist, dass jeder Ingenieur sich an sie erinnert, ist keine Governance; sie ist ein Vorschlag. Echte Governance bedeutet, dass die Policy an dem Punkt angewendet wird, an dem Telemetrie gesammelt wird, einheitlich, ob sich jemand an ihre Existenz erinnert oder nicht.
OpenTelemetry gibt Ihnen die Maschinerie, um diese Lücke zu schliessen – den Collector, um Regeln anzuwenden, und OpAMP, um sie von einem Ort aus an eine ganze Flotte zu pushen. In diesem Leitfaden geht es darum, Telemetrie-Policy in Durchsetzung zu verwandeln: was zu governen ist, warum rohe Collectors es schwer machen und wie eine Control Plane die Regeln zum Halten bringt.
Platform-Leads, Observability-Verantwortliche und Security-/Compliance-Stakeholder, die für Telemetrie über viele Teams und Collectors hinweg verantwortlich sind – jeder, der eine Datenverarbeitungs- oder Kosten-Policy geschrieben hat (oder schreiben sollte) und nun braucht, dass sie in der Produktion tatsächlich hält. Voraussetzungen: eine Flotte von OpenTelemetry Collectors (oder ein Plan für eine) und die Befugnis, zu standardisieren, wie sie konfiguriert werden.
Was „Governance” für eine Telemetrie-Pipeline tatsächlich bedeutet
Governance ist nicht eine Kontrolle; es ist eine Handvoll Policies, die Sie für jede Pipeline im Bestand ausnahmslos wahr haben wollen:
- Datenschutz – sensible Felder (PII, Secrets, Tokens) werden maskiert oder verworfen, bevor Telemetrie die Netzwerkgrenze überschreitet, auf jeder Route, nicht nur auf denen, an die jemand gedacht hat.
- Kosten-Leitplanken – Rauschen wird gefiltert und volumenstarke Streams werden gesamplet, damit kein einzelnes Team die Rechnung heimlich ver-10-fachen kann. Volumenkontrolle wird zum Standard, nicht zum Aufräumprojekt.
- Standardisierung – konsistente Ressourcenattribute (
service.name,deployment.environment.name, Team-/Owner-Tags), damit Daten team-übergreifend zuordenbar und abfragbar sind statt ein Turmbau zu Babel. - Freigegebene Ziele – Telemetrie fliesst nur zu sanktionierten Backends. Kein wildgewordener Exporter, der heimlich Produktions-Logs an einen ungeprüften Dritten schickt.
- Änderungskontrolle – jede Pipeline-Änderung wird reviewt, versioniert und ist auditierbar, sodass „wer hat was, wann und warum geändert” immer eine Antwort hat.
Jede davon ist am Collector durchsetzbar. Das Problem ist, sie an tausend Collectors durchsetzbar zu machen, konsistent, und es so zu halten.
Warum rohe OTel-Collectors die Durchsetzung erschweren
Der OpenTelemetry Collector kann jede dieser Policies ausdrücken – Redaction mit den
transform- und redaction-Prozessoren, Kostenkontrolle mit filter und
probabilistic_sampler, Standardisierung mit resource-Prozessoren, Routing nur zu
freigegebenen Exportern. Die Fähigkeit ist nicht das Problem. Das Betriebsmodell
ist es.
Von Haus aus ist jeder Collector seine eigene YAML-Datei. Das bedeutet:
- Keine zentrale Durchsetzung. Eine Policy ist nur so gut wie ihr Vorhandensein in jeder Konfiguration. Verpassen Sie einen Node, und das ist Ihr Leck, Ihr Kostenausbruch oder Ihre nicht zuordenbaren Daten.
- Config-Drift. Jemand bearbeitet einen Collector während eines Incidents von Hand und vergisst, es zurückzunehmen. Nun verletzt dieser Node still die Policy, und nichts weist darauf hin.
- Keine Vorschau, keine Sicherheit. Pushen Sie eine schlechte Redaction-Regel flottenweit, und Sie erfahren es in der Produktion. Es gibt kein „zeig mir, was diese Änderung bewirkt, bevor sie ausgerollt wird”.
- Kein Audit-Trail. Wenn ein Auditor fragt „beweisen Sie, dass PII auf dieser Pipeline an diesem Datum maskiert wurde”, ist ein Haufen handbearbeiteter YAML-Dateien keine Antwort.
Das ist der ehrliche Grund, warum viele Teams nie über das Policy-PDF hinauskommen: es von Hand über eine Flotte durchzusetzen ist mehr Arbeit, als irgendjemand aufrechterhalten kann, also verfällt es. Governance, die auf Disziplin angewiesen ist, skaliert nicht.
Der Wandel: von dokumentierter Policy zu durchgesetzter Konfiguration
Die Lösung besteht darin, aufzuhören, jeden Collector als eigenständig bearbeitbare Box zu behandeln, und anzufangen, die Konfiguration der Flotte als einziges, governtes Artefakt zu behandeln – aus Policy gerendert, vor dem Ausrollen validiert, überall gleichzeitig gepusht und gesperrt, damit sie nicht driften kann.
Zwei OpenTelemetry-Bausteine machen das möglich:
- Der Collector wendet die Regeln an – die Prozessoren, die maskieren, filtern, samplen, standardisieren und routen.
- OpAMP (das Open Agent Management Protocol) ist der Fernverwaltungs-Standard, der einen zentralen Server die Konfiguration jedes Collectors besitzen und Updates an die Flotte pushen lässt. Entscheidend ist: Wenn der Server die Source of Truth ist, hören lokale Änderungen auf, massgeblich zu sein – was genau das ist, was Drift beseitigt.
Setzen Sie eine Control Plane auf diese beiden, und Policy wird zu Konfiguration, Konfiguration wird durchgesetzt, und Durchsetzung wird beweisbar.
Wie eine Control Plane es durchsetzt
Hier passt LinkMesh hinein: Es ist eine selbstgehostete Control Plane für OpenTelemetry Collectors, die jede dieser Policies in etwas Angewendetes und Beweisbares verwandelt, nicht in etwas Dokumentiertes und Erhofftes.
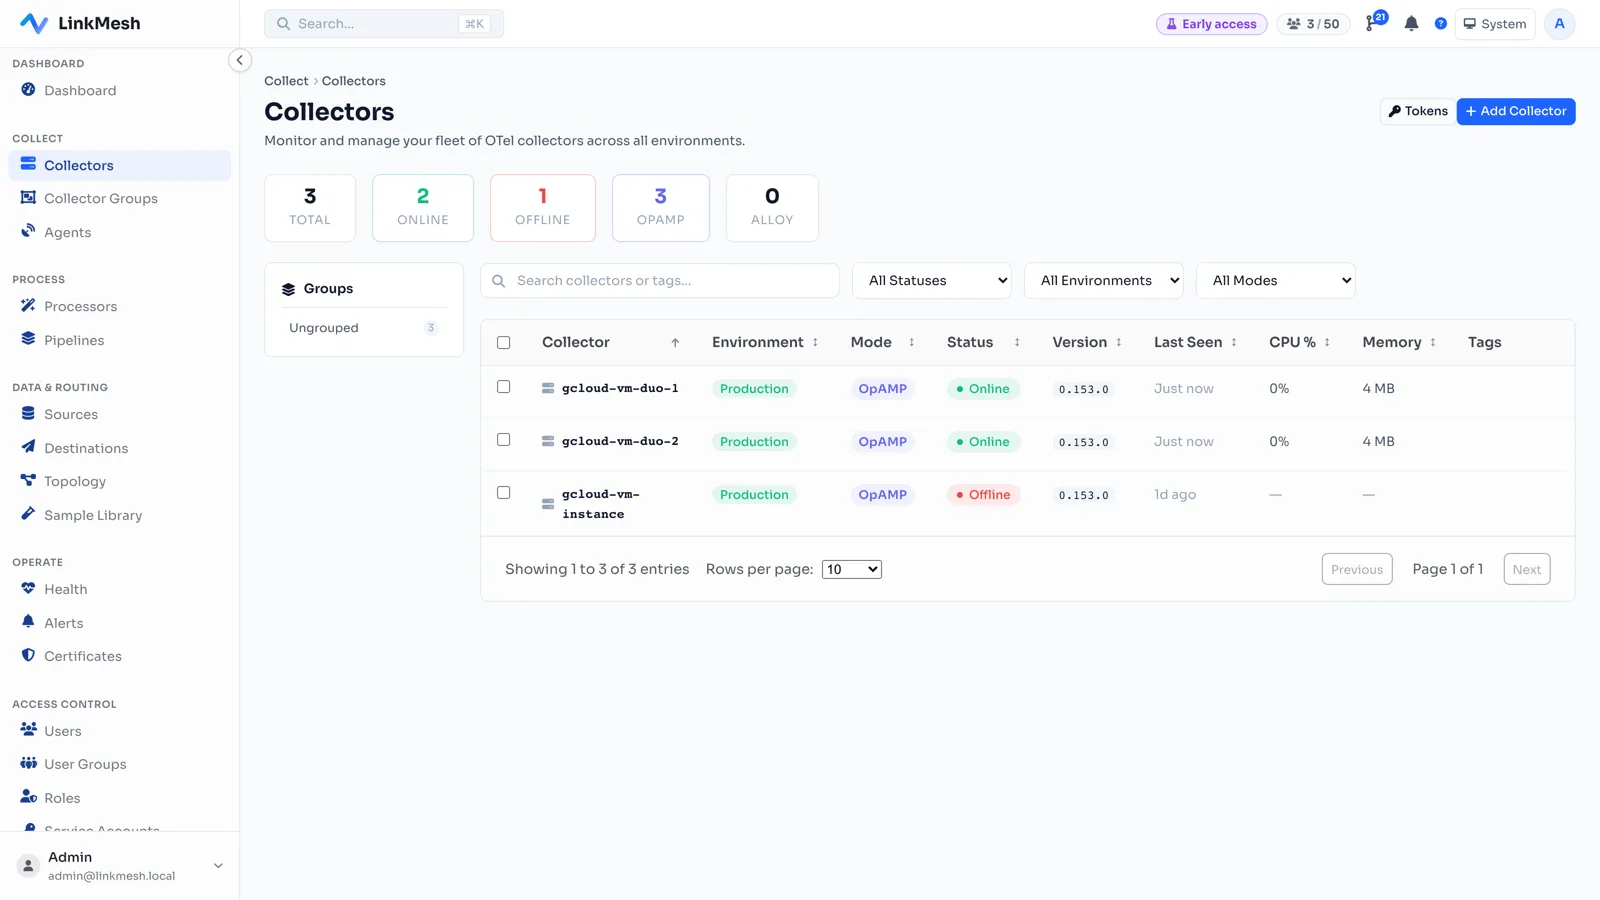
Zentrale Konfiguration als Source of Truth. Sie komponieren Quellen, Prozessoren, Routen und Ziele einmal, in einem visuellen Builder. LinkMesh rendert und validiert die Collector-Konfiguration und liefert sie an die richtigen Nodes – OpAMP-Push oder remotecfg-Pull. Weil die Control Plane die Konfiguration besitzt, ist eine Handänderung an einem Node nicht massgeblich – die durchgesetzte Konfiguration ist es. Das ist Drift-Vermeidung by Design, nicht durch Kontrollgänge.
Verpflichtende Verarbeitung auf jeder Route. Redaction und Filterung sind keine optionalen Zusätze, die ein Team überspringen kann; sie sind Schritte in der Pipeline, die die Control Plane ausrollt. Setzen Sie einen PII-Redaction-Prozessor in die Standard-Pipeline, und er gilt überall dort, wo diese Pipeline deployt ist – der Durchsetzungsmechanismus hinter der Praxis, die wir in PII-Maskierung in Logs behandeln.
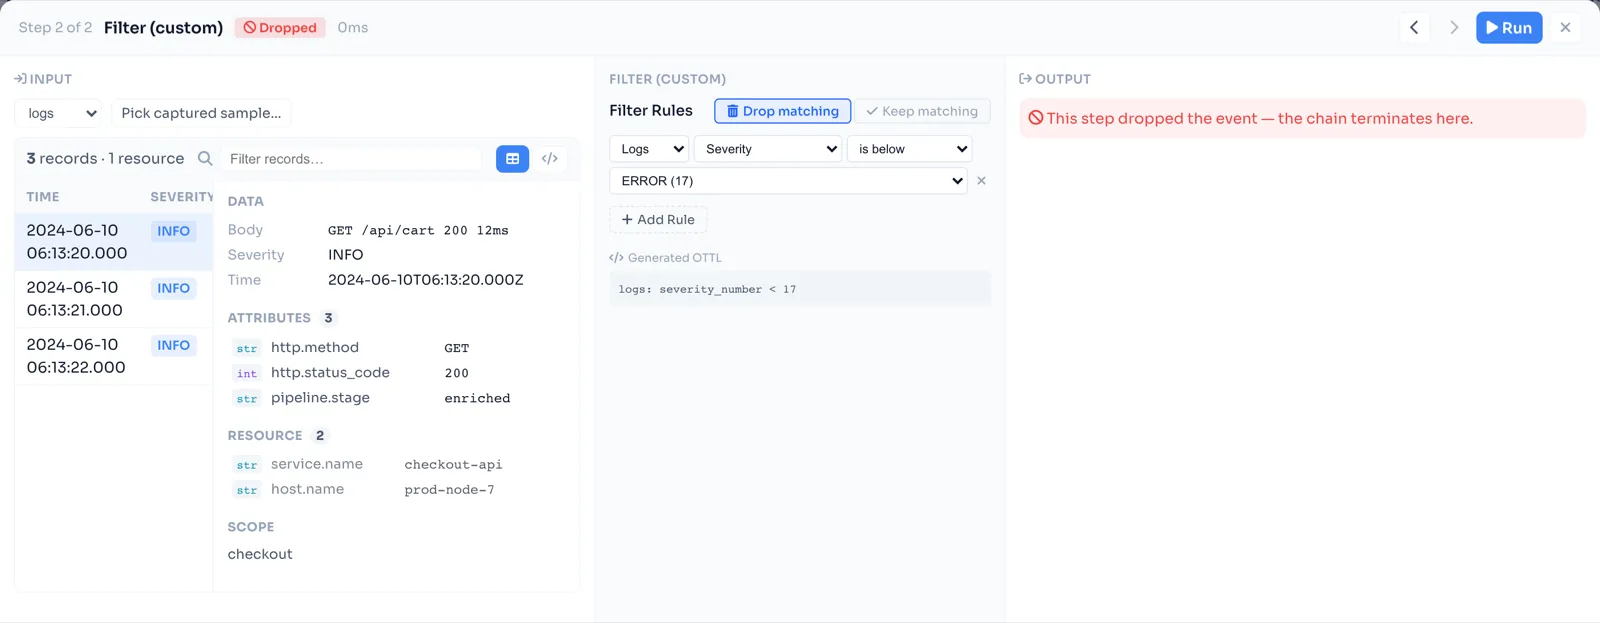
Vorschau, bevor Sie durchsetzen. Eine Governance-Änderung, die Sie nicht testen können, ist eine Governance-Änderung, die Sie zu machen sich fürchten. LinkMesh zeigt die Wirkung eines Prozessors als Vorschau – Input, Konfiguration, Output –, sodass Sie bestätigen können, dass eine Redaction- oder Drop-Regel genau das tut, was Sie beabsichtigen, bevor sie an die Flotte ausgerollt wird:
Ein Audit-Trail dessen, was tatsächlich ausgerollt wurde. Jede Konfigurationsänderung wird versioniert und aufgezeichnet – im GitOps-Stil –, sodass „wer hat was, wann und warum geändert” immer eine Antwort hat. Das ist der Unterschied zwischen einer behaupteten Policy und der Fähigkeit zu beweisen, dass sie an einem gegebenen Datum galt, was Compliance tatsächlich verlangt. (Die Mechanik steht in GitOps für Collector-Konfiguration.)
Verifikation, nicht Glaube. Durchsetzung, die Sie nicht beobachten können, ist bloss Hoffnung. LinkMesh zeigt Durchsatz pro Kante und Drop-Zähler pro Prozessor, sodass Sie eine governende Regel in Kraft treten sehen können – die angewendete Redaction sehen, den gesamplten Stream schrumpfen sehen – und bestätigen, dass die Policy live ist statt bloss angenommen.
Governance ohne neuen Kostenzähler
Es gibt eine Falle, die einen Namen verdient. Eine Governance-Schicht, die nach dem von ihr inspizierten Volumen abrechnet, wird zu ihrem eigenen Kostenproblem – je mehr Sie governen, desto mehr zahlen Sie, was stillschweigend davon abhält, alles zu governen. LinkMesh hat einen Preis pro verwaltetem Collector, nicht pro Gigabyte, sodass das Durchsetzen von Policy über Ihre gesamte Flotte keinen Nutzungszähler zu dem hinzufügt, den Sie am Backend zu kontrollieren versuchen. Und weil die Telemetrie niemals durch die Control Plane fliesst – sie bleibt auf Ihrer Infrastruktur, direkt zu freigegebenen Zielen geroutet –, ist die Governance-Schicht auch kein neuer Ort, an dem sensible Daten liegen.
Das verstärkt sich auch mit der Kostenarbeit: Dieselbe Durchsetzung, die PII maskiert und Attribute standardisiert, ist der Ort, an dem Sie Rauschen verwerfen und Volumen samplen, sodass Governance und Observability-Kostenkontrolle derselbe Satz Regeln sind, am selben Ort angewendet.
Wo anfangen
Sie müssen nicht am ersten Tag alles governen. Setzen Sie die Policy mit dem höchsten Einsatz zuerst durch und erweitern Sie dann:
- Redaction zuerst – setzen Sie einen PII-Maskierungsprozessor in die Standard-Pipeline, damit sensible Daten am Rand, überall, standardmässig maskiert werden.
- Kosten-Leitplanken als Nächstes – fügen Sie Filter- und Sampling-Standards hinzu, damit kein Team die Rechnung unbemerkt aufblähen kann.
- Attribute standardisieren – setzen Sie
service.name, Umgebung und Owner-Tags durch, damit jedes Signal zuordenbar ist. - Ziele sperren und auditieren – beschränken Sie das Routing auf freigegebene Backends und führen Sie den versionierten Trail jeder Änderung.
Governance hört in dem Moment auf, ein Dokument zu sein, in dem die Regeln in der Konfiguration leben, die die Flotte tatsächlich ausführt. OpenTelemetry gibt Ihnen den Collector und OpAMP, um das real zu machen; eine selbstgehostete Control Plane macht es durchsetzbar, vorschaubar und beweisbar – was der eigentliche Sinn von Governance überhaupt ist.
LinkMesh verwandelt eine Datenverarbeitungs- oder Kosten-Policy in validierte Collector-Konfiguration, liefert sie an jeden Node (OpAMP-Push oder remotecfg-Pull), zeigt jede Änderung vor dem Ausrollen als Vorschau und führt einen Audit-Trail dessen, was wann ausgerollt wurde. Selbstgehostet, Preis pro Collector. Stellen Sie eine Control Plane bereit und setzen Sie Ihre erste Policy in Minuten durch, oder sehen Sie, was es kann, und die Preise.