
 LinkMeshObservability Data Collection Management
Alloy vs. OpenTelemetry Collector
Konfiguration, Remote-Management und der Betrieb eines gemischten Fleets.
 Philippe Braxmeier← Zurück zum Blog
„Grafana Alloy oder der OpenTelemetry Collector?” ist eine der häufigsten Fragen, wenn ein Team seinen Telemetrie-Agenten standardisiert. Die ehrliche Antwort ist, dass sie viel näher beieinander liegen, als das „versus” nahelegt – Alloy ist eine OpenTelemetry-Collector-Distribution –, sodass die Entscheidung auf ein paar konkrete Unterschiede hinausläuft und nicht auf ein Alles-oder-nichts.
Dieser Beitrag geht durch, was sie tatsächlich gemeinsam haben, wo sie sich wirklich unterscheiden (Konfigurationssprache, Remote-Management, Ökosystem), eine Entscheidungsmatrix und wie Sie ein Fleet betreiben, das beide enthält, ohne die zentrale Kontrolle zu verlieren.
Abstammung: Grafana Agent → Alloy
Grafana Alloy ist der Nachfolger des Grafana Agent. Für diesen Vergleich noch wichtiger: Grafana positioniert und baut Alloy als eine herstellerneutrale Distribution des OpenTelemetry Collectors: Es bettet OTel-Collector-Komponenten ein und ergänzt Grafanas eigene Pipelines – Prometheus-Scraping und Service Discovery, Loki für Logs, Pyroscope für Profiles – plus natives Clustering und eine eingebaute Debugging-UI.
Das ist also nicht „Grafanas Sache vs. der offene Standard”. Beide sprechen OTLP; beide sind aus OpenTelemetry-Collector-Komponenten gebaut. otelcol-contrib ist die Community-„contrib”-Distribution – der breiteste Katalog an OTel-Receivern, -Processors und -Exportern. Alloy ist eine kuratierte OTel-Distribution mit angeschraubtem Grafana-/Prometheus-Ökosystem. Behalten Sie diese Rahmung, und der Rest der Entscheidung wird deutlich einfacher.
Konfigurationssprache: River (Alloy-Syntax) vs. YAML
Der sichtbarste Unterschied ist, wie Sie eine Pipeline schreiben. Der Collector verwendet YAML
mit receivers, processors, exporters und service.pipelines. Alloy verwendet eine
komponentenbasierte Konfigurationssyntax (ursprünglich „River”), bei der Komponenten
verdrahtet werden, indem sie sich gegenseitig auf ihre In- und Outputs beziehen.
Dieselbe OTLP-in-, Batch-, OTLP-out-Pipeline im Collector (YAML):
receivers:
  otlp:
    protocols:
      grpc:
processors:
  batch:
exporters:
  otlp:
    endpoint: otlp.example.com:4317
service:
  pipelines:
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp]
…und in Alloy:
otelcol.receiver.otlp "default" {
  grpc { }
  output {
    metrics = [otelcol.processor.batch.default.input]
  }
}

otelcol.processor.batch "default" {
  output {
    metrics = [otelcol.exporter.otlp.default.input]
  }
}

otelcol.exporter.otlp "default" {
  client {
    endpoint = "otlp.example.com:4317"
  }
}
Dieselbe Pipeline, zwei mentale Modelle. YAML ist ein deklarierter Graph – Sie listen Stufen
auf und benennen sie in service.pipelines. Alloy ist ein expliziter Verdrahtungsgraph – jede
Komponente deklariert per Referenz, wohin ihr Output geht. Alloys Modell ist mächtig, wenn Sie
Discovery, Scraping und OTel-Komponenten in einem Agenten zusammenführen; YAML ist einfacher
und portabler über das OTel-Ökosystem hinweg.
Es gibt auch einen Aspekt der Lernkurve. YAML ist vertraut und aus dem riesigen Bestand an
Collector-Beispielen online per Copy-and-paste übernehmbar. Alloys Syntax braucht einen Moment
länger, um verinnerlicht zu werden, aber die expliziten Referenzen machen grosse
Konfigurationen leichter nachvollziehbar – Sie sehen genau, was was speist, statt Namen über
einen service.pipelines-Block hinweg abzugleichen. Keine ist schwer; sie belohnen nur leicht
unterschiedliche Gewohnheiten.
Remote-Management: remotecfg vs. OpAMP
Keines der Tools möchte, dass Sie die Konfiguration auf jedem Host von Hand bearbeiten, und jedes hat eine native Möglichkeit, Konfiguration von einem zentralen Server zu beziehen:
- Alloy hat einen
remotecfg-Block: Der Agent holt seine Konfiguration von einem Remote-Endpunkt (Grafana Cloud Fleet Management oder ein beliebiger kompatibler Server) und pollt auf Updates. - otelcol-contrib verwendet OpAMP – in der Praxis über den
opampsupervisor, der pushed Konfiguration anwendet und den Health-Zustand meldet. (Wir haben das ausführlich in OpAMP erklärt behandelt.)
Beide verschaffen Ihnen zentrale Konfiguration; es sind nur unterschiedliche Protokolle. Es gibt einen semantischen Unterschied, der erwähnenswert ist: OpAMP ist ein Push-and-Report-Modell über eine persistente Verbindung, während remotecfg ein Pull-and-Poll-Modell ist. In beiden Fällen authentifiziert sich der Agent gegenüber dem Server (typischerweise mit einem Bearer Token), und in beiden Fällen wollen Sie, dass die Konfiguration validiert wird, bevor sie ausgeliefert wird – eine Pipeline, die nicht startet, ist eine schlechte Pipeline, egal wie sie angekommen ist. Die praktische Konsequenz: Wenn Sie beide Runtimes betreiben, verwalten Sie zwei verschiedene Remote-Config-Mechanismen – es sei denn, Ihre Control Plane spricht beide (dazu unten mehr).
Ökosystem, UI und Selbst-Telemetrie
Ein paar Unterschiede, die im Alltag zählen:
- Komponentenkatalog. otelcol-contrib trägt den umfangreichsten Satz an OTel-Komponenten, einschliesslich nischiger Receiver und Exporter. Alloy kuratiert, welche OTel-Komponenten es einbettet, und ergänzt die Prometheus-/Loki-/Grafana- Komponenten, die der Collector nicht hat. Wenn Sie von einer bestimmten Contrib-Komponente abhängen, prüfen Sie, ob Alloy sie unterstützt; wenn Sie in der Prometheus-/Grafana-Welt leben, hat Alloy Batterien, die der Collector nicht hat.
- Eingebaute UI. Alloy liefert eine Web-UI aus, die den Komponentengraphen visualisiert und Live-Debugging dessen bietet, was durch jede Komponente fliesst – wirklich nützlich, wenn eine Pipeline sich fehlverhält. Der Collector stellt interne Metriken und zPages bereit, aber keine eingebaute Graph-UI.
- Clustering. Alloy hat natives Clustering, um Scrape-Targets über Instanzen hinweg zu teilen; der Collector überlässt das der Art, wie Sie ihn deployen.
- Selbst-Telemetrie. Beide emittieren Metriken über sich selbst – Durchsatz, Queue-Grössen, verworfene Daten, Exporter-Fehler –, sodass Sie den Agenten überwachen können, nicht nur das, was durch ihn fliesst. Alloy zeigt vieles davon in seiner UI; beim Collector scrapen Sie seinen internen Metriken-Endpunkt. So oder so ist das Beobachten der eigenen Gesundheit des Agenten das, was „Daten kommen nicht mehr an” von einem Rätsel in einen Alert verwandelt.
Keiner dieser Punkte macht das eine „besser” – sie drängen in unterschiedliche Richtungen.
Entscheidungsmatrix: wann Alloy, wann otelcol, wann beide
| Wenn Sie… | Tendenz |
|---|---|
| Im Grafana-/Prometheus-Stack lebst (Scraping, Discovery, Loki) | Alloy |
| Die eingebaute Komponentengraph-UI + Live-Debugging willst | Alloy |
| Natives Clustering für Scrape-Targets brauchst | Alloy |
| Den breitesten OTel-Komponentenkatalog / eine nischige Contrib-Komponente willst | otelcol-contrib |
| Eine reine, herstellerneutrale OTel-Haltung + OpAMP willst | otelcol-contrib |
| Einen heterogenen Bestand hast (teils Grafana-lastig, teils reine OTel-Hosts) | Beide |
Diese letzte Zeile ist häufiger die reale Welt, als man erwartet. Unterschiedliche Teams, Akquisitionen und Plattformen bescheren Ihnen Alloy auf einigen Hosts und otelcol auf anderen – und das ist in Ordnung, solange Sie sie gemeinsam verwalten können.
Ein gemischtes Fleet von einer Control Plane aus betreiben
Der Haken an „betreiben Sie beide” ist, dass Alloy remotecfg spricht und otelcol OpAMP,
sodass Sie naiv mit zwei Management-Planes enden. Die Lösung ist eine Control Plane, die beide
spricht – Sie stellen die Pipeline einmal zusammen, und sie liefert sie an jede Runtime auf
die Art aus, die diese Runtime erwartet.
Ohne das bedeutet ein gemischtes Fleet zwei Dashboards, zwei Konfigurationsformate, die von Hand zu erstellen sind, und zwei Stellen, an denen zu prüfen ist, ob eine Änderung tatsächlich angekommen ist – und die Drift, die Sie eliminieren wollten, schleicht sich über die Nahtstellen zurück. Eine einzige Control Plane fasst das wieder zu einem Inventar und einem Edit-and-Apply-Flow zusammen, was auch immer jeder Host gerade ausführt.
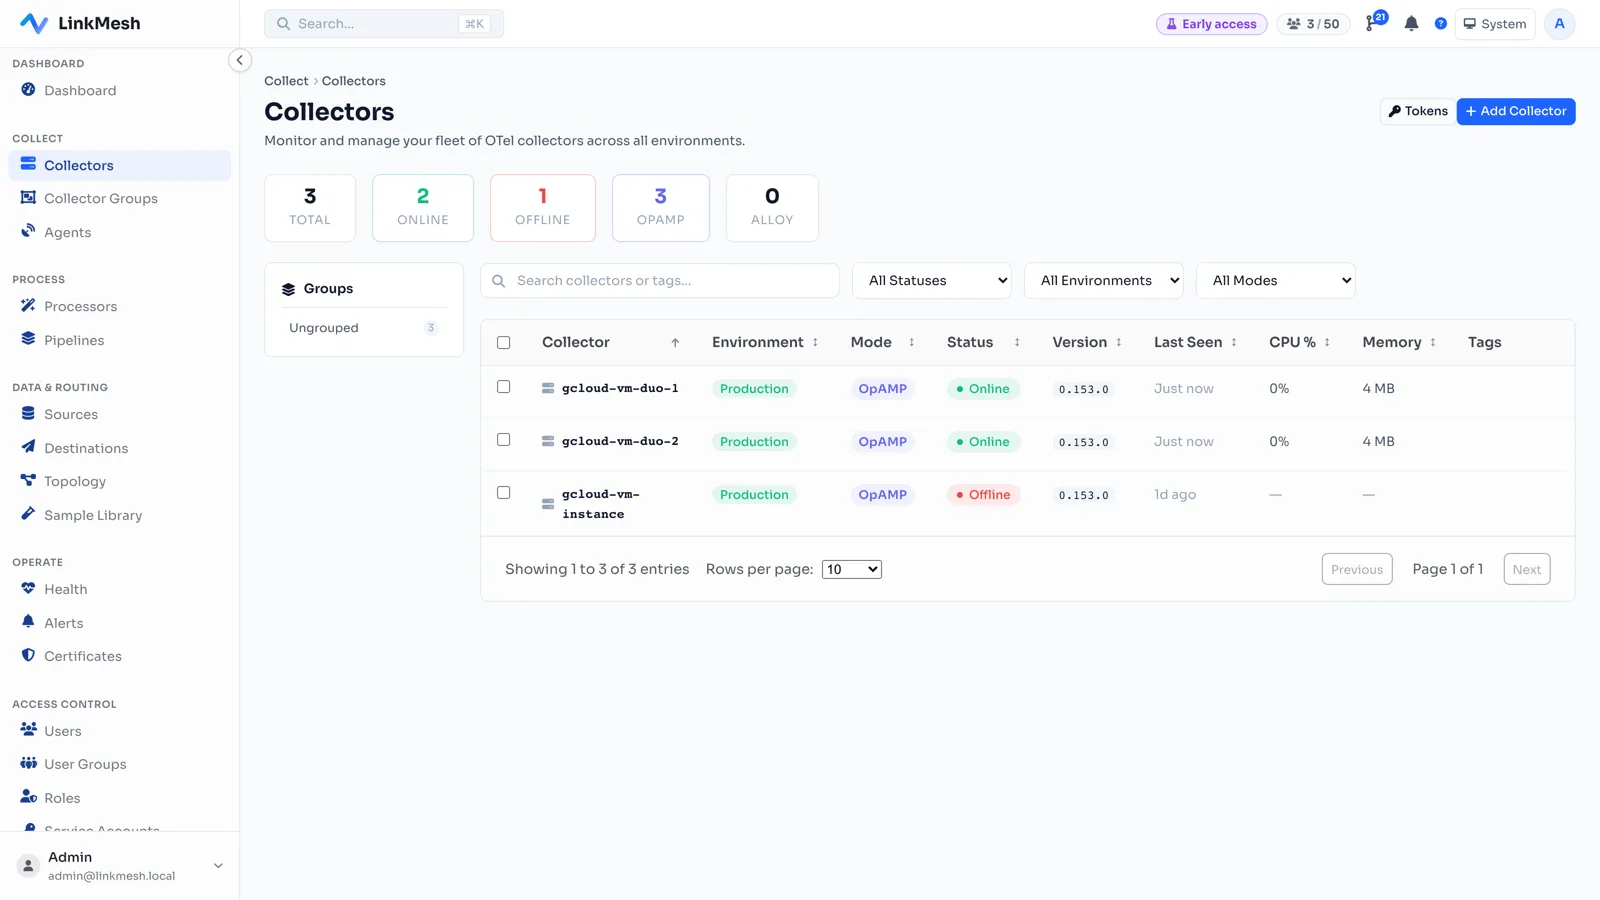
So behandelt LinkMesh die Runtime als eine Achse, nicht als eine Gabelung. Sie
enrollen Alloy über remotecfg und otelcol über OpAMP, und beide erscheinen in einem
Fleet-Inventar – gleicher Status, gleicher Verlauf angewendeter Konfigurationen, gleiche
Drift-Ansicht:
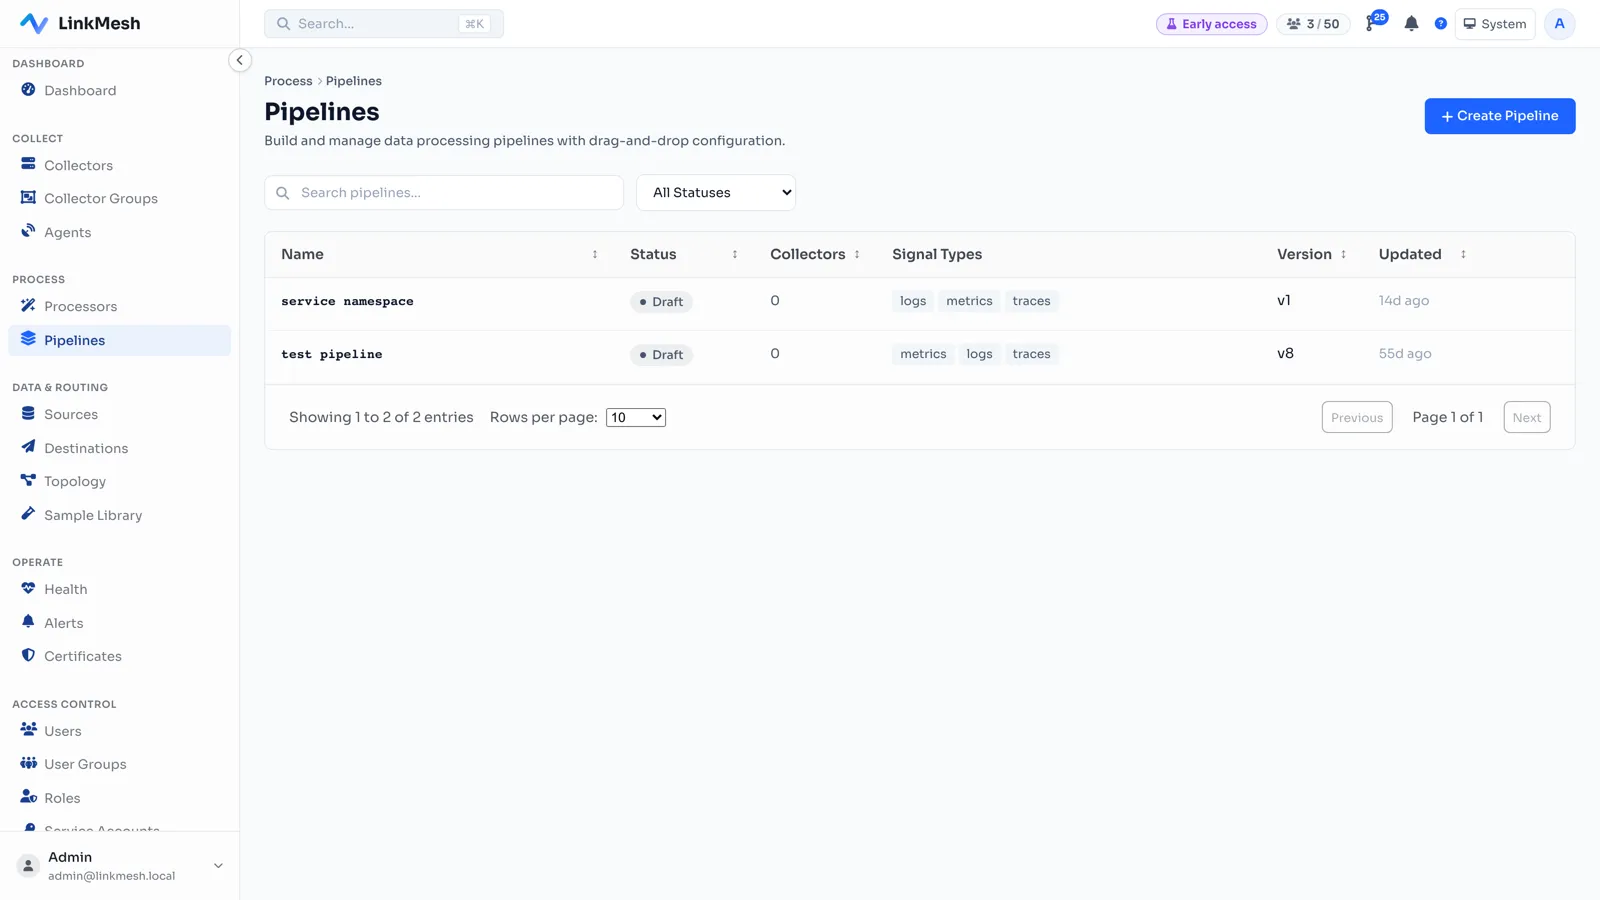
Sie stellen die Pipeline einmal im Builder zusammen, und die Control Plane rendert und liefert sie an jede Runtime aus:
Die Kurzfassung
Alloy und der OpenTelemetry Collector sind eigentlich keine Rivalen – Alloy ist eine OTel-Collector-Distribution mit angehängtem Grafana-Ökosystem. Wählen Sie Alloy für die Grafana-/Prometheus-Welt und ihre UI; wählen Sie otelcol-contrib für den breitesten, reinsten OTel-Footprint; betreiben Sie beide, wenn Ihr Bestand gemischt ist. Was „beide” davon abhält, zum Kopfschmerz zu werden, ist eine einzige Control Plane, die jede Runtime nativ verwaltet.
Sehen Sie sich die Seite Features an, holen Sie sich ein Binary von Downloads oder stellen Sie eine Control Plane auf und enrollen Sie Ihren ersten Collector – Alloy oder otelcol – unter linkmesh.io/install.