
 LinkMeshObservability Data Collection Management
Config-Rollout & Rollback
Die Flotte ändern, ohne sie zu zerstören.
 Roman Hüsler← Zurück zum Blog
Die häufigste Art, eine Observability-Pipeline zu zerstören, ist kein Hardwareausfall und keine Traffic-Spitze — es ist eine Config-Änderung. Jemand bearbeitet einen Processor, korrigiert einen Endpoint oder verschärft einen Filter, rollt es auf die Flotte aus, und ein Tippfehler oder eine zu weit gefasste Regel verwirft eine Stunde später während eines Incidents still die Telemetrie, die man gerade braucht. Die Änderung selbst ist Routine; die Art, wie sie ausgerollt wird, entscheidet, ob sie sicher oder gefährlich ist.
In diesem Leitfaden geht es darum, eine Collector-Config-Änderung wie das Produktions-Deploy zu behandeln, das sie tatsächlich ist: vor dem Ausliefern validiert, schrittweise ausgerollt, versioniert, damit es immer einen bekannten funktionierenden Stand gibt, zu dem man zurückkehren kann, und in Sekunden umkehrbar statt in einer hektischen Runde von SSH-Sitzungen.
Platform Engineers und SREs, die OpenTelemetry-Collector-Config über mehr als eine Handvoll Nodes hinweg ändern und das Risiko gespürt haben, einen Edit auf einen Schlag überallhin auszurollen. Voraussetzungen: eine Collector-Flotte und der Wunsch, YAML nicht mehr pro Node von Hand zu bearbeiten. Weiterführend: GitOps für Collector-Config und OpAMP erklärt.
Vor dem Anwenden validieren
Die meisten fehlerhaften Rollouts fängt man kostenlos ab, wenn man die Config validiert, bevor sie einen Node erreicht. Der Collector kann eine Config prüfen, ohne sie auszuführen:
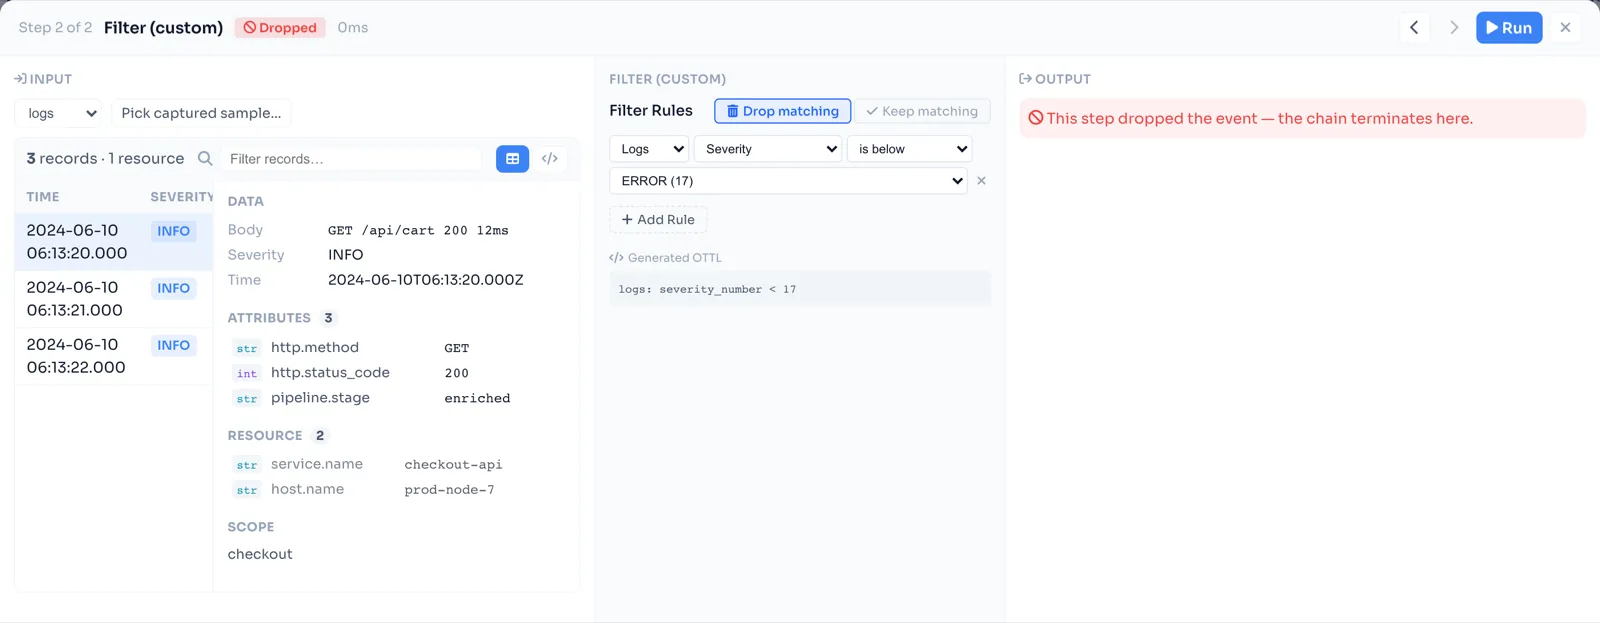
otelcol-contrib validate --config config.yamlValidierung fängt strukturelle Fehler ab — einen unbekannten Processor, einen in einer Pipeline referenzierten, aber nicht definierten Receiver, einen fehlerhaften Exporter-Block — bevor sie einen Collector lahmlegen. Doch strukturelle Gültigkeit ist nicht dasselbe wie verhaltensmässige Korrektheit: Eine Config kann vollkommen gültig sein und trotzdem jeden Span verwerfen, weil ein Filter invertiert ist. Deshalb ist die zweite Hälfte von „validieren” eine Vorschau — die zeigt, was ein Processor tatsächlich mit Beispiel-Input macht, bevor er ausgeliefert wird. Zu sehen, wie ein Filter, der nur Errors behält, auf echten Daten die richtigen Records verwirft, fängt die Fehler ab, die eine Schema-Prüfung niemals erkennt.
In Stufen ausrollen, nicht auf einen Schlag
Selbst eine validierte, in der Vorschau geprüfte Änderung sollte nicht gleichzeitig jeden Collector treffen. Ein gestuftes (Canary-)Rollout begrenzt den Blast Radius von allem, was die vorigen Prüfungen übersehen haben:
- Canary. Wenden Sie die neue Config auf eine kleine, repräsentative Teilmenge an — einen Node, eine Zone oder einen unkritischen Service — und lassen Sie den Rest auf der aktuellen Version.
- Beobachten. Geben Sie ihr lange genug, um echten Traffic zu sehen. Vergleichen Sie Durchsatz und Drop-Zahlen auf dem Canary mit den unveränderten Nodes. Ein gesundes Rollout sieht langweilig aus: Volumen hält sich, Drops schiessen nicht hoch, keine Errors in den Logs.
- Ausweiten. Sobald der Canary eindeutig gesund ist, weiten Sie auf die nächste Stufe aus, dann auf den Rest der Flotte. Wenn irgendwo etwas verdächtig aussieht, stoppen Sie und rollen nur den Canary zurück — der Blast Radius wächst nie über die Teilmenge hinaus.
Der ganze Wert des Canarying liegt darin, dass ein Fehler einen Node für zehn Minuten betrifft statt tausend Nodes auf unbestimmte Zeit. Das funktioniert nur, wenn man während der Einbrennphase tatsächlich die richtigen Signale beobachtet, weshalb das Beobachten der Wirkung eines Rollouts (siehe unten) Teil des Prozesses ist und kein Nachgedanke.
Versionierte Config ist die Source of Truth
Schnelles Rollback ist nur möglich, wenn es eine letzte funktionierende Version gibt, zu der man zurückkehren kann — was bedeutet, dass jede Config versioniert ist und der laufende Zustand der Flotte aus diesen Versionen abgeleitet wird, nicht aus dem, was zuletzt jemand auf eine Box getippt hat. Behandeln Sie Config als versioniertes Artefakt (GitOps-Stil): Jede Änderung ist eine neue Version, geprüft und festgehalten, und der Node führt die Version aus, die ihm zugewiesen wurde. Das ist das Fundament, auf dem der gesamte GitOps-Ansatz für Collector-Config aufbaut, und es ist das, was Drift erkennbar und Rollback trivial macht.
Ohne Versionierung bedeutet „Rollback”, die vorherige Config unter Druck aus dem Gedächtnis zu rekonstruieren. Mit Versionierung bedeutet Rollback, eine bestimmte frühere Version erneut auszurollen — ein Diff, den man lesen kann, und ein Artefakt, dem man vertrauen kann.
Schnell zurückrollen
Wenn ein Rollout schiefgeht, zählt Geschwindigkeit mehr als Diagnose. Der richtige erste Schritt ist, den Service wiederherzustellen und dann zu untersuchen:
- Auf die letzte funktionierende Version zurücksetzen. Wählen Sie die vorherige Config-Version und rollen Sie sie erneut auf die betroffenen Nodes aus. Weil es eine Version ist und keine Rekonstruktion, wissen Sie genau, was Sie wiederherstellen.
- Wiederherstellung bestätigen. Beobachten Sie, wie Durchsatz und Drop-Zahlen auf den zurückgesetzten Nodes zu ihrer vorherigen Baseline zurückkehren.
- Dann diagnostizieren. Mit wiederhergestelltem Service arbeiten Sie heraus, was die fehlerhafte Änderung angerichtet hat — anhand des in der Vorschau geprüften Diffs zwischen den beiden Versionen —, bevor Sie es erneut versuchen.
Rollback sollte ein Knopfdruck sein, kein Projekt. Wenn das Zurücknehmen einer flottenweiten Änderung erfordert, auf jedem Node YAML zu bearbeiten, haben Sie kein echtes Rollback; Sie haben ein zweites, riskanteres Rollout unter Zeitdruck.
Warum OpAMP und eine Control Plane das erstklassig machen
All das oben Beschriebene — eine Version auf eine Teilmenge ausrollen, beobachten, ausweiten, zurücknehmen — ist von Hand mühsam, weil rohe Collector unabhängige YAML-Dateien ohne gemeinsame Vorstellung von „Version” oder „zugewiesener Config” sind. OpAMP, das Open Agent Management Protocol, ist der Standard, der es einem zentralen Server erlaubt, die Config jedes Collectors zu besitzen und Updates auf die Flotte auszurollen. Das ist das Primitiv, das Rollout und Rollback von einer Pro-Node-SSH-Angelegenheit in eine Flottenoperation verwandelt:
- Gezieltes Anwenden. Rollen Sie eine Version auf eine gelabelte Teilmenge (den Canary) aus und lassen Sie den Rest unberührt — weil die Control Plane weiss, welcher Node welche Config ausführt.
- Atomares Zurücknehmen. Weise der betroffenen Gruppe die letzte funktionierende Version erneut zu, und die Control Plane rollt sie überall auf einen Schlag aus.
- Kein Drift nach dem Anwenden. Weil der Server autoritativ ist, kann ein Node keinen Hand-Edit still behalten — die zugewiesene Version ist das, was läuft, worum es beim Erkennen von Config-Drift genau geht.
Eine selbst gehostete Control Plane wie LinkMesh setzt das auf OpAMP auf: Config im visuellen Builder zusammenstellen, validieren und in der Vorschau prüfen, zuerst auf einen einzelnen Canary-Collector ausrollen, dessen Durchsatz pro Edge und Drop-Zahlen pro Processor beobachten, um Health zu bestätigen, und dann auf die gesamte Flotte veröffentlichen — oder die Flotte in einer Aktion auf eine frühere Version zurücksetzen. Es ist dieselbe Enforcement-Maschinerie hinter Governance im grossen Massstab, angewendet auf den alltäglichen Akt, Config sicher zu ändern.
Die Wirkung beobachten
Ein Rollout ist nicht „fertig”, wenn die Config angewendet ist; es ist fertig, wenn Sie bestätigt haben, dass die Flotte auf der neuen Version gesund ist. Das bedeutet, die Signale zu beobachten, die eine fehlerhafte Änderung offenlegen:
- Durchsatz pro Edge — hat sich das Volumen gehalten, oder ist eine Route still geworden, weil ein Receiver oder Exporter kaputtgegangen ist?
- Drop-Zahlen pro Processor — hat ein Filter oder Sampler begonnen, weit mehr (oder weit weniger) zu verwerfen als beabsichtigt?
- Collector-Errors und -Restarts — verursacht die neue Config Crashes oder Export-Fehler?
Wenn diese über den Canary und dann über die Flotte hinweg stabil bleiben, ist das Rollout wirklich gesund — nicht nur angewendet. Diese Bestätigung ist das, was Sie mit Zuversicht ausweiten lässt und, falls sie je fehlt, das, was Ihnen sagt, zurückzurollen, bevor der Blast Radius wächst.
LinkMesh macht Rollout und Rollback erstklassig: eine Änderung validieren und in der Vorschau prüfen, eine Version auf einen einzelnen Canary-Collector ausrollen, Durchsatz und Drop-Zahlen pro Edge beobachten und dann auf die Flotte veröffentlichen — oder die Flotte in einer Aktion auf die letzte funktionierende Version zurücksetzen, über OpAMP. Selbst gehostet, versioniert, auditiert. Jetzt loslegen in Minuten, oder ansehen, was es kann.