
 LinkMeshObservability Data Collection Management
Observability-Kosten senken
Filtern, samplen & routen vor der Rechnung.
 Philippe Braxmeier← Zurück zum Blog
Observability-Rechnungen haben eine unangenehme Eigenschaft: Sie wachsen mit Ihrem Erfolg. Mehr Traffic, mehr Services, mehr Telemetrie – und weil die meisten Anbieter pro aufgenommenem Gigabyte abrechnen, klettert die Rechnung schneller als der Nutzen, den Sie aus den Daten ziehen. Die gute Nachricht ist, dass das meiste dieses Volumens Rauschen ist, für dessen Speicherung Sie zahlen und das Sie nie abfragen.
Dies ist ein praxisnahes Playbook, um Observability-Ausgaben zu senken, ohne blind zu werden: messen, wo das Volumen ist, das Rauschen filtern, das Volumenstarke samplen und Daten an Ziele routen, deren Preis zu dem passt, wie Sie sie tatsächlich nutzen – alles bevor sie ein teures Backend erreichen.
Wohin das Geld tatsächlich geht
Anbieter-Preisgestaltung stapelt meist drei Gebühren: Ingest (pro akzeptiertem GB), Index (die Daten durchsuchbar machen) und Retention (sie aufbewahren). Die Ingest-Zahl ist die, die direkt mit dem Volumen skaliert, und dort hilft eine Pipeline am meisten.
Ein kurzes, illustratives Stück Rechnung. Angenommen, Sie schicken 1 TB Logs pro Tag und Ihr Backend berechnet in der Grössenordnung von 0,50 $ pro aufgenommenem GB:
1.000 GB/Tag × 0,50 $/GB = 500 $/Tag ≈ 15.000 $/MonatNehmen Sie nun an, 60 % dieser Logs sind DEBUG-Zeilen, Health-Check-Spam und
erfolgreiche Load-Balancer-Pings, die nie jemand abfragt. Sie vor der Aufnahme zu
verwerfen bringt dieselbe Rechnung in Richtung 6.000 $/Monat – für Daten, die Sie
sich nie angesehen hätten. Die genauen Zahlen variieren nach Anbieter und Tarif, aber
die Form ist immer dieselbe: Volumen ist der Hebel, und das günstigste Gigabyte ist
das, das Sie nie schicken.
Logs und Traces sind ein Volumen-Spiel; Metriken sind ein Kardinalitäts-Spiel. Jede eindeutige Kombination von Label-Werten ist eine separate Zeitreihe zum Speichern, und ein einzelnes Label mit hoher Kardinalität – eine User-ID, eine Request-ID, eine rohe URL – kann Ihre Metrik-Rechnung um Grössenordnungen vervielfachen. Dieselbe Pipeline, die Log-Volumen filtert, kann ausser Kontrolle geratene Labels verwerfen oder wegaggregieren, bevor sie in Millionen von Reihen explodieren.
Schritt 1 – Messen: Sie können nicht kürzen, was Sie nicht sehen
Bevor Sie irgendetwas löschen, finden Sie heraus, woher das Volumen tatsächlich kommt. Blindes Kürzen ist der Weg, auf dem Sie versehentlich die eine Log-Zeile verwerfen, die Sie beim nächsten Incident brauchten. Sie wollen Durchsatz pro Quelle und pro Route: welche Pipeline, welcher Service, welcher Log-Stream die Gigabytes erzeugt.
Volumen ist fast immer schief verteilt: eine Handvoll Services oder Log-Streams erzeugt den Grossteil davon. Finden Sie die zuerst – die paar grössten Sprecher machen üblicherweise die Mehrheit der Rechnung aus, und sie zu beheben ist der Ort, an dem sich der Aufwand auszahlt. Einem volumenschwachen Stream nachzujagen, um einen Rundungsfehler von der Rechnung abzuschneiden, ist vergeudete Arbeit.
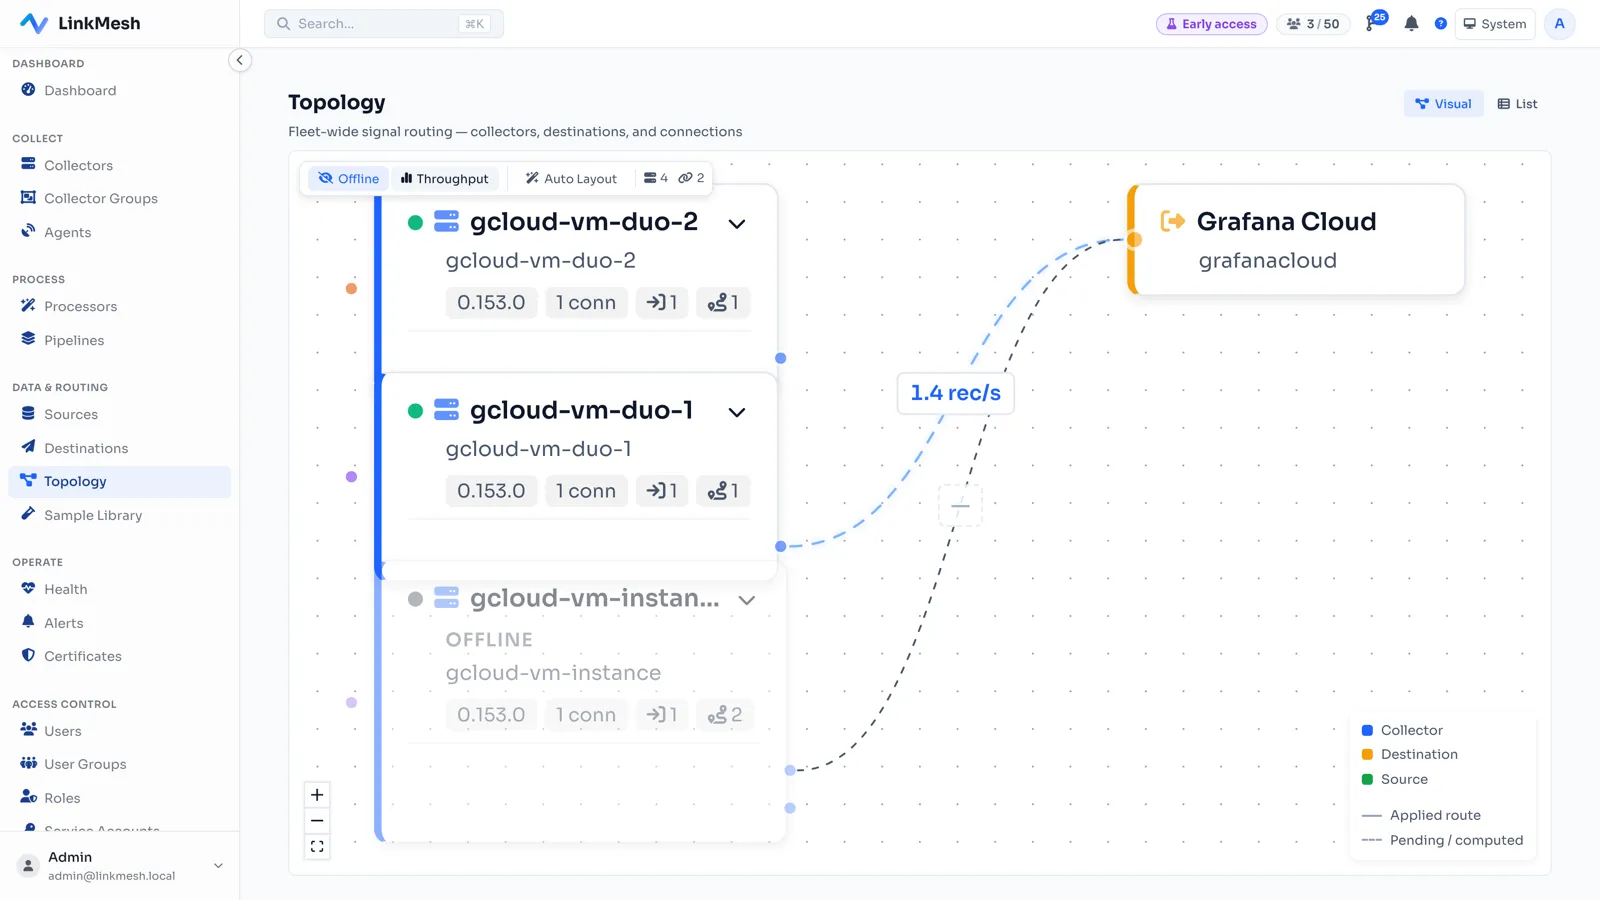
Eine Telemetrie-Pipeline mit Durchsatz pro Kante verwandelt das von Ratespiel in eine Zahl, auf die Sie zeigen können. LinkMesh zeigt Records pro Sekunde auf jeder Kante der Topologie, sodass Sie genau sehen, wo Volumen eintritt und was jedes Ziel erreicht:
Schritt 2 – Filtern: das Rauschen am Rand verwerfen
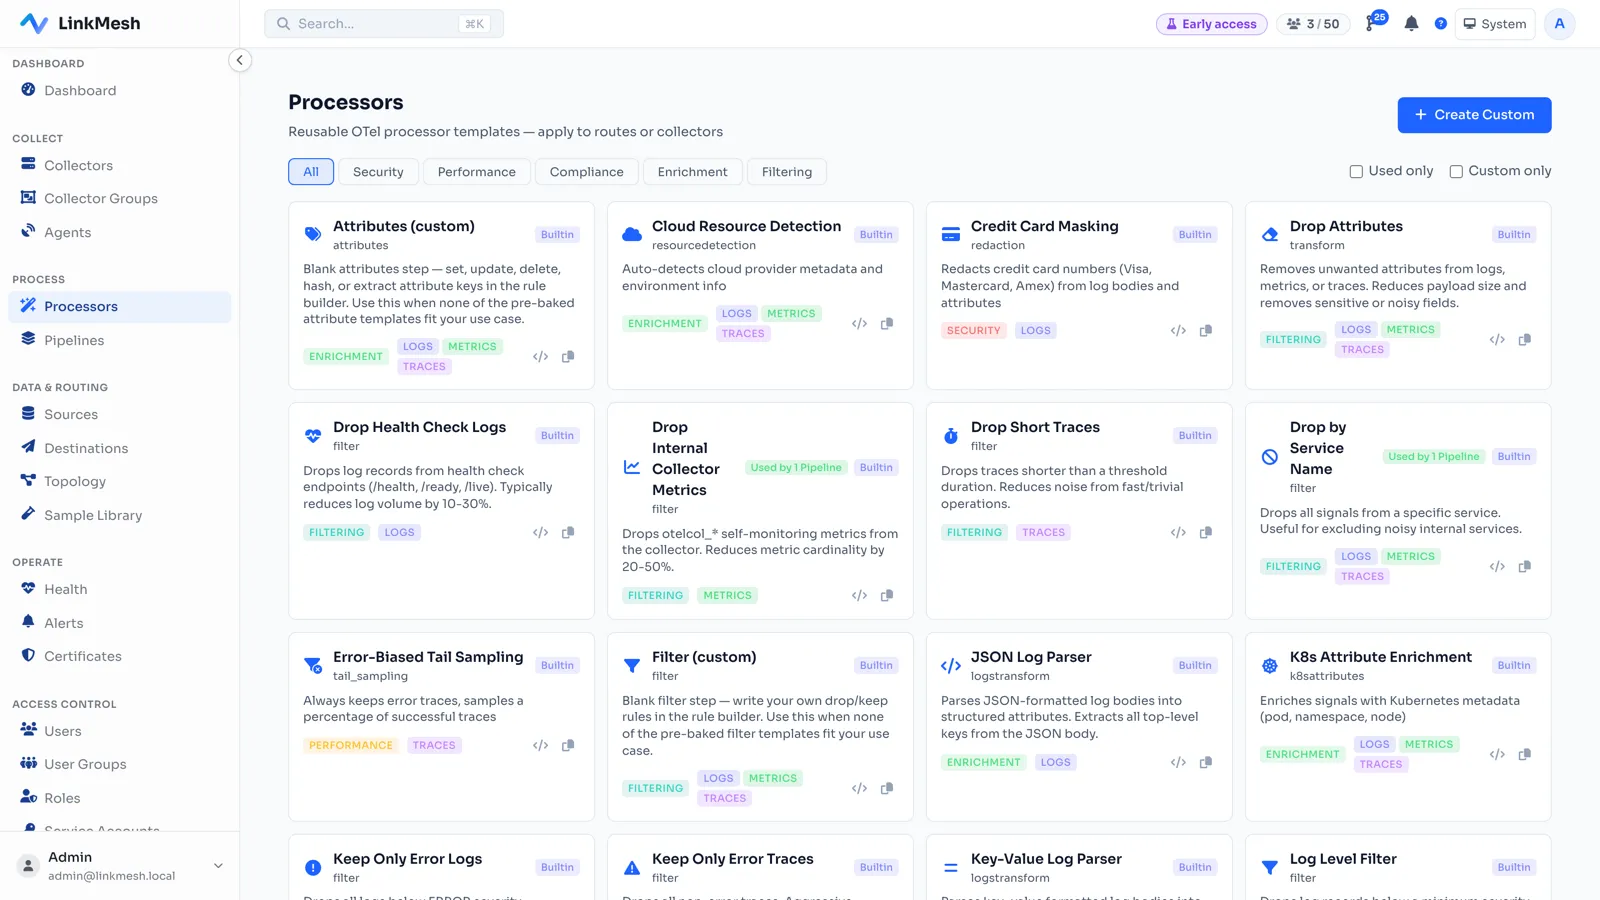
Der grösste, sicherste Gewinn ist, Daten, die Sie nie nutzen, so früh wie möglich zu verwerfen. Debug-Logs in der Produktion, Health-Check-Requests, geschwätzige Drittanbieter-Komponenten, ausführliche Erfolgs-Events – filtern Sie sie am Collector, bevor sie Sie nachgelagert etwas kosten.
Mit dem filter-Prozessor des OpenTelemetry Collectors ist das Verwerfen von
Sub-INFO-Logs ein paar Zeilen:
processors:
  filter/drop_debug:
    logs:
      log_record:
        - 'severity_number < SEVERITY_NUMBER_INFO'
Sie können auf jedes Attribut filtern – Health-Check-URLs verwerfen, einen lauten Namespace oder Spans von einem synthetischen Monitor. Die Faustregel: Wenn kein Dashboard, kein Alert und keine Untersuchung je eine Datenkategorie liest, sollte sie nicht in Ihrem bezahlten Backend sein.
Filtern geht nicht nur um ganze Records. Fette Log-Zeilen und aufgeblähte
Ressourcenattribute summieren sich ebenfalls – das Verwerfen ungenutzter Attribute
mit dem attributes- oder transform-Prozessor trimmt jedes Record, das Sie doch
behalten. Sensible Felder zu maskieren (ohnehin aus Compliance-Gründen sinnvoll)
verkleinert Payloads als Nebeneffekt. Kleinere Records bedeuten geringeren Ingest,
über den ganzen Stream hinweg.
Schritt 3 – Samplen: das Signal behalten, die Masse verwerfen
Manche Daten sind im Aggregat nützlich, aber ruinös, sie vollständig zu behalten – volumenstarke Traces, erfolgreiche Requests, repetitive Info-Logs. Sampling behält einen repräsentativen Bruchteil. Head-basiertes Sampling ist das einfachste: entscheiden Sie bei der Aufnahme, günstig, mit einer festen Rate.
processors:
  probabilistic_sampler:
    sampling_percentage: 15
Das behält 15 % des Flusses und verwirft den Rest vor der Aufnahme. Für Traces können Sie mit Tail Sampling schlauer werden – 100 % der Fehler und langsamen Requests behalten, die schnellen erfolgreichen samplen – zum Preis von Pufferung. Beginnen Sie mit Head-Sampling auf Ihren volumenstärksten, wertärmsten Streams; es ist der schnellste Hebel nach dem Filtern.
Die Leitplanke ist, nie blind zu samplen. Behalten Sie 100 % der Fehler, alles Langsame und alles Sicherheitsrelevante; samplen Sie nur die langweilige, erfolgreiche, volumenstarke Mehrheit. Eine Pipeline, die Sie die Regel pro Route setzen lässt – volle Genauigkeit auf dem Fehlerpfad, aggressives Sampling auf dem Happy Path –, ist das, was Sampling sicher statt beängstigend macht.
Schritt 4 – Routen: Daten an das Ziel schicken, das ihr Wert verdient
Nicht jede Telemetrie verdient Ihr Premium-, indiziertes, schnell abfragbares Backend. Vieles davon existiert für Compliance oder den gelegentlichen Deep Dive – es muss aufbewahrt werden, nicht in 200 ms abfragbar sein. Routing lässt Sie den Stream nach Wert aufteilen:
- Premium-Backend – die ~10 %, die Sie aktiv abfragen: Dashboards, Alerts, Live-Debugging. Schnell, indiziert, teuer pro GB.
- Günstiges Archiv – Objektspeicher (S3 und Freunde) für Compliance und Forensik am Regentag. Pfennige pro GB, langsamer abzufragen, und das ist in Ordnung.
Alles „für alle Fälle” an die Premium-Stufe zu schicken ist der Ort, an dem eine riesige Menge Observability-Geld still verdunstet. Routen Sie nach Wert, und das teure Backend zahlt nur für das, was sich seinen Platz verdient.
Eine häufige Aufteilung: Anwendungs-Error-Logs und die Metriken hinter Ihren SLOs gehen an die Premium-Stufe; vollständige Access-Logs und Audit-Trails gehen an Objektspeicher, abgefragt nur, wenn ein Auditor oder ein Incident darum bittet. Dieselben Daten aufbewahrt, ein Bruchteil der Kosten – Sie haben gerade aufgehört, Premium-Tarife für die Speicherung ruhender Daten zu zahlen.
Diese Aufteilung ist eine Routing-Entscheidung, keine Filter-Entscheidung — Sie verwerfen die Access-Logs nicht, Sie schicken sie woandershin, wo es günstiger ist. Wie die Routing-Seite in der Praxis funktioniert — eine nach Priorität geordnete Bedingungskaskade, gebaut mit einem Feld-/Operator-/Wert-Picker statt handgeschriebenem OTTL —, steht in Route Telemetry by Attribute (englisch).
Den Drop verifizieren
Jeder Schritt oben ist reversibel und wert, gemessen zu werden, also schliessen Sie den Kreis: Vergleichen Sie den Durchsatz pro Route vor und nach jeder Änderung. Wenn das Filtern eines Namespaces eine Route von 8.000 auf 3.000 Records pro Sekunde gesenkt hat und jedes Dashboard weiterhin funktioniert, ist das eine echte, beweisbare Einsparung – keine hoffnungsvolle Konfigurationsänderung.
Hier zahlt sich eine Pipeline mit eingebauter Messung doppelt aus. LinkMesh zeigt Drop-Zähler pro Prozessor und Durchsatz pro Kante, sodass Sie einen Filter in Kraft treten sehen und bestätigen können, dass das Volumen tatsächlich gesunken ist – und dass Sie dabei nichts Nachgelagertes kaputt gemacht haben. (Für die Grundlagen hinter diesen Stufen siehe unseren Leitfaden zu Telemetrie-Pipelines.)
Wo anfangen
Aufwand sollte der Wirkung folgen, also machen Sie diese der Reihe nach:
- Messen Sie Ihre paar volumenstärksten Routen.
- Filtern Sie Debug-Logs und Health-Check-Rauschen – der grösste sichere Gewinn.
- Samplen Sie die volumenstarken, wertarmen Streams, die das Filtern überleben.
- Routen Sie Nur-Aufbewahren-Daten an günstigen Speicher, halten Sie den abgefragten Ausschnitt premium.
Die meisten Teams bekommen einen grossen Schnitt allein aus den Schritten 2 und 3, bevor sie irgendetwas Riskantes anfassen – und weil jeder Schritt gemessen ist, können Sie die Einsparung beweisen und beweisen, dass Sie dabei kein Dashboard kaputt gemacht haben.
Ein weiterer Hebel: das Werkzeug, das Geld spart, darf nicht auch nach Volumen abrechnen
Es gibt eine Ironie, die einen Namen verdient. Viele Pipeline-Werkzeuge, die Ihnen helfen, Ingest zu kürzen, haben selbst einen Preis nach dem Volumen, das sie verarbeiten – sodass das Werkzeug, das Sie zur Kostenkontrolle gekauft haben, eine Rechnung hat, die ebenfalls mit Ihren Daten wächst.
LinkMesh hat einen Preis pro verwaltetem Collector, nicht pro Gigabyte, sodass das Schrumpfen Ihrer Telemetrie reine Einsparung ist: Es senkt Ihre Backend-Rechnung und erhöht nie unsere. Siehe Preise für das Modell, oder stellen Sie eine Control Plane bereit und beginnen Sie, Ihr Volumen unter linkmesh.io/install zu messen – und zu kürzen.