
 LinkMeshObservability Data Collection Management
Die Kette in der Vorschau, nicht den Incident
Beobachten Sie ein echtes Record durch jeden Prozessor-Schritt, bevor Sie speichern.
 Philippe Braxmeier← Zurück zum Blog
Eine Telemetrie-Pipeline zu bearbeiten ist eine jener Aufgaben, bei denen die Rückkopplungsschleife brutal lang ist. Sie schreiben einen Filter, um Health-Check-Rauschen zu verwerfen, speichern ihn, pushen ihn an einen Collector, warten, bis er greift, und gehen dann in Ihrem Backend nachsehen, ob die richtigen Records überlebt haben. Machen Sie die Regex ein bisschen zu gierig, und Sie erfahren es Stunden später – indem Sie bemerken, dass die Logs, die Sie brauchten, weg sind.
Das Problem ist nicht die Pipeline. Es ist, dass Sie sie blind bearbeiten. Sie schreiben eine Transformation und hoffen, dass sie tut, was Sie denken, ohne Möglichkeit, das Ergebnis zu sehen, bis es bereits auf Live-Traffic läuft.
Eine gute Idee von n8n übernehmen
Wenn Sie n8n, das Workflow-Automatisierungswerkzeug, verwendet haben, wissen Sie, dass sein bestes Feature nicht der Node-Katalog ist – es ist, dass Sie einen beliebigen Node öffnen und die tatsächlichen Daten sehen können, die durch ihn fliessen: was hereinkam, was der Node tat, was herauskam. Sie bauen mit den Augen auf echten Werten, nicht auf einem abstrakten Diagramm.
LinkMesh bringt dieselbe Idee zu OpenTelemetry-Pipelines. Öffnen Sie einen beliebigen Schritt in einer Prozessor-Kette, und Sie erhalten eine Node-Detailansicht: das Record auf dem Weg hinein, die Konfiguration des Schritts und das Record auf dem Weg hinaus – alles in einem Rahmen.
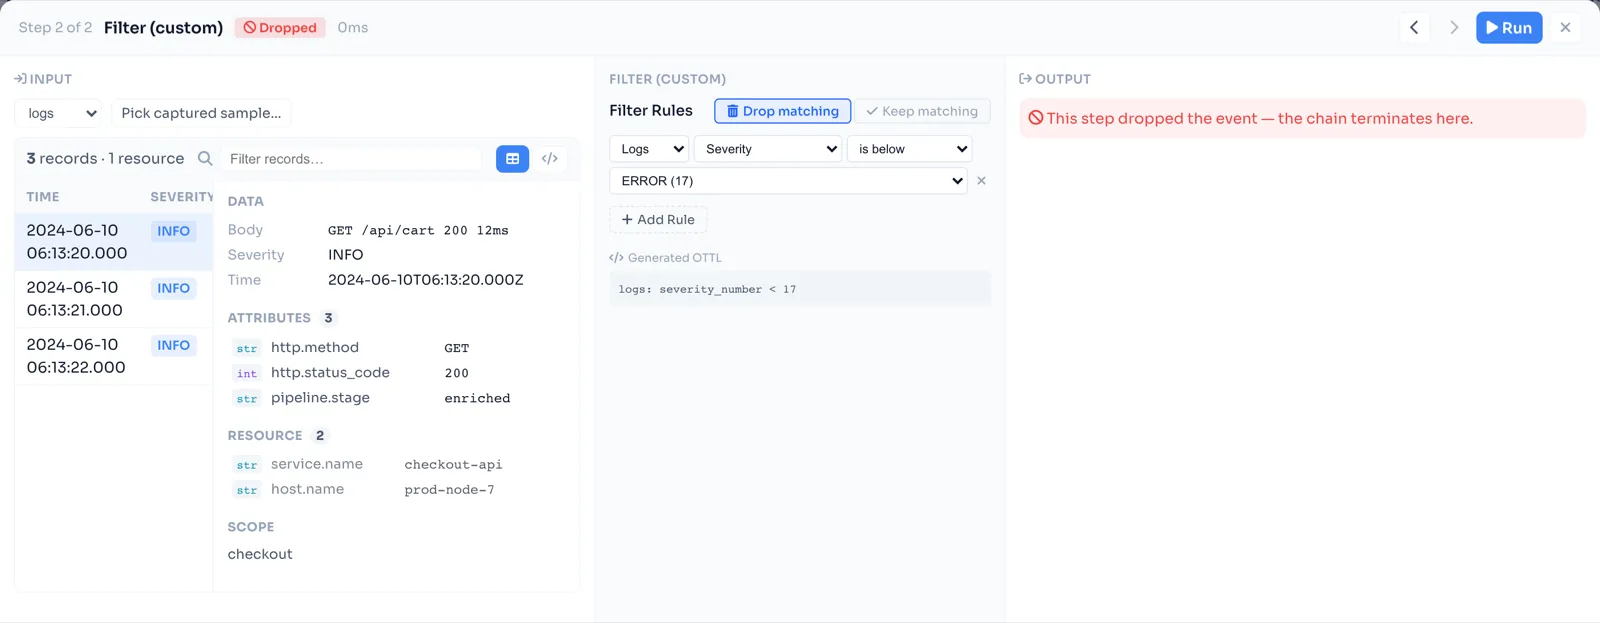
Lesen Sie es von links nach rechts:
- Input – die Records, die in diesen Schritt eintreten. Keine Spielzeug-Payload:
echte Events, mit ihrem Body, ihrer Severity, ihren Attributen (
http.method,http.status_code,pipeline.stage) und ihrer Ressource (service.name,host.name), so ausgelegt, dass Sie genau sehen, womit der Schritt arbeitet. - Config – der Schritt selbst. Hier ein benutzerdefinierter Filter, gesetzt auf
Treffer verwerfen, wo die Severity unter
ERRORliegt, mit dem generierten OTTL (severity_number < 17), direkt unter dem Regel-Builder angezeigt. Sie sehen die menschenfreundliche Regel und den tatsächlichen Collector-Ausdruck, zu dem sie kompiliert, zusammen. - Output – das Ergebnis. Dieses Record ist
INFO, also traf es die Drop-Regel, und der Output-Bereich sagt es klar: dieser Schritt hat das Event verworfen – die Kette endet hier. Kein Rätselraten, warum ein Record nicht durchkam.
Dieser dritte Bereich ist der ganze Sinn. Ein verworfenes Record ist kein Rätsel, das Sie aus fehlenden Daten in Ihrem Backend rekonstruieren – es ist ein beschriftetes Ergebnis, das Sie an genau dem Schritt sehen können, der die Entscheidung getroffen hat.
Durch die ganze Kette schrittweise gehen
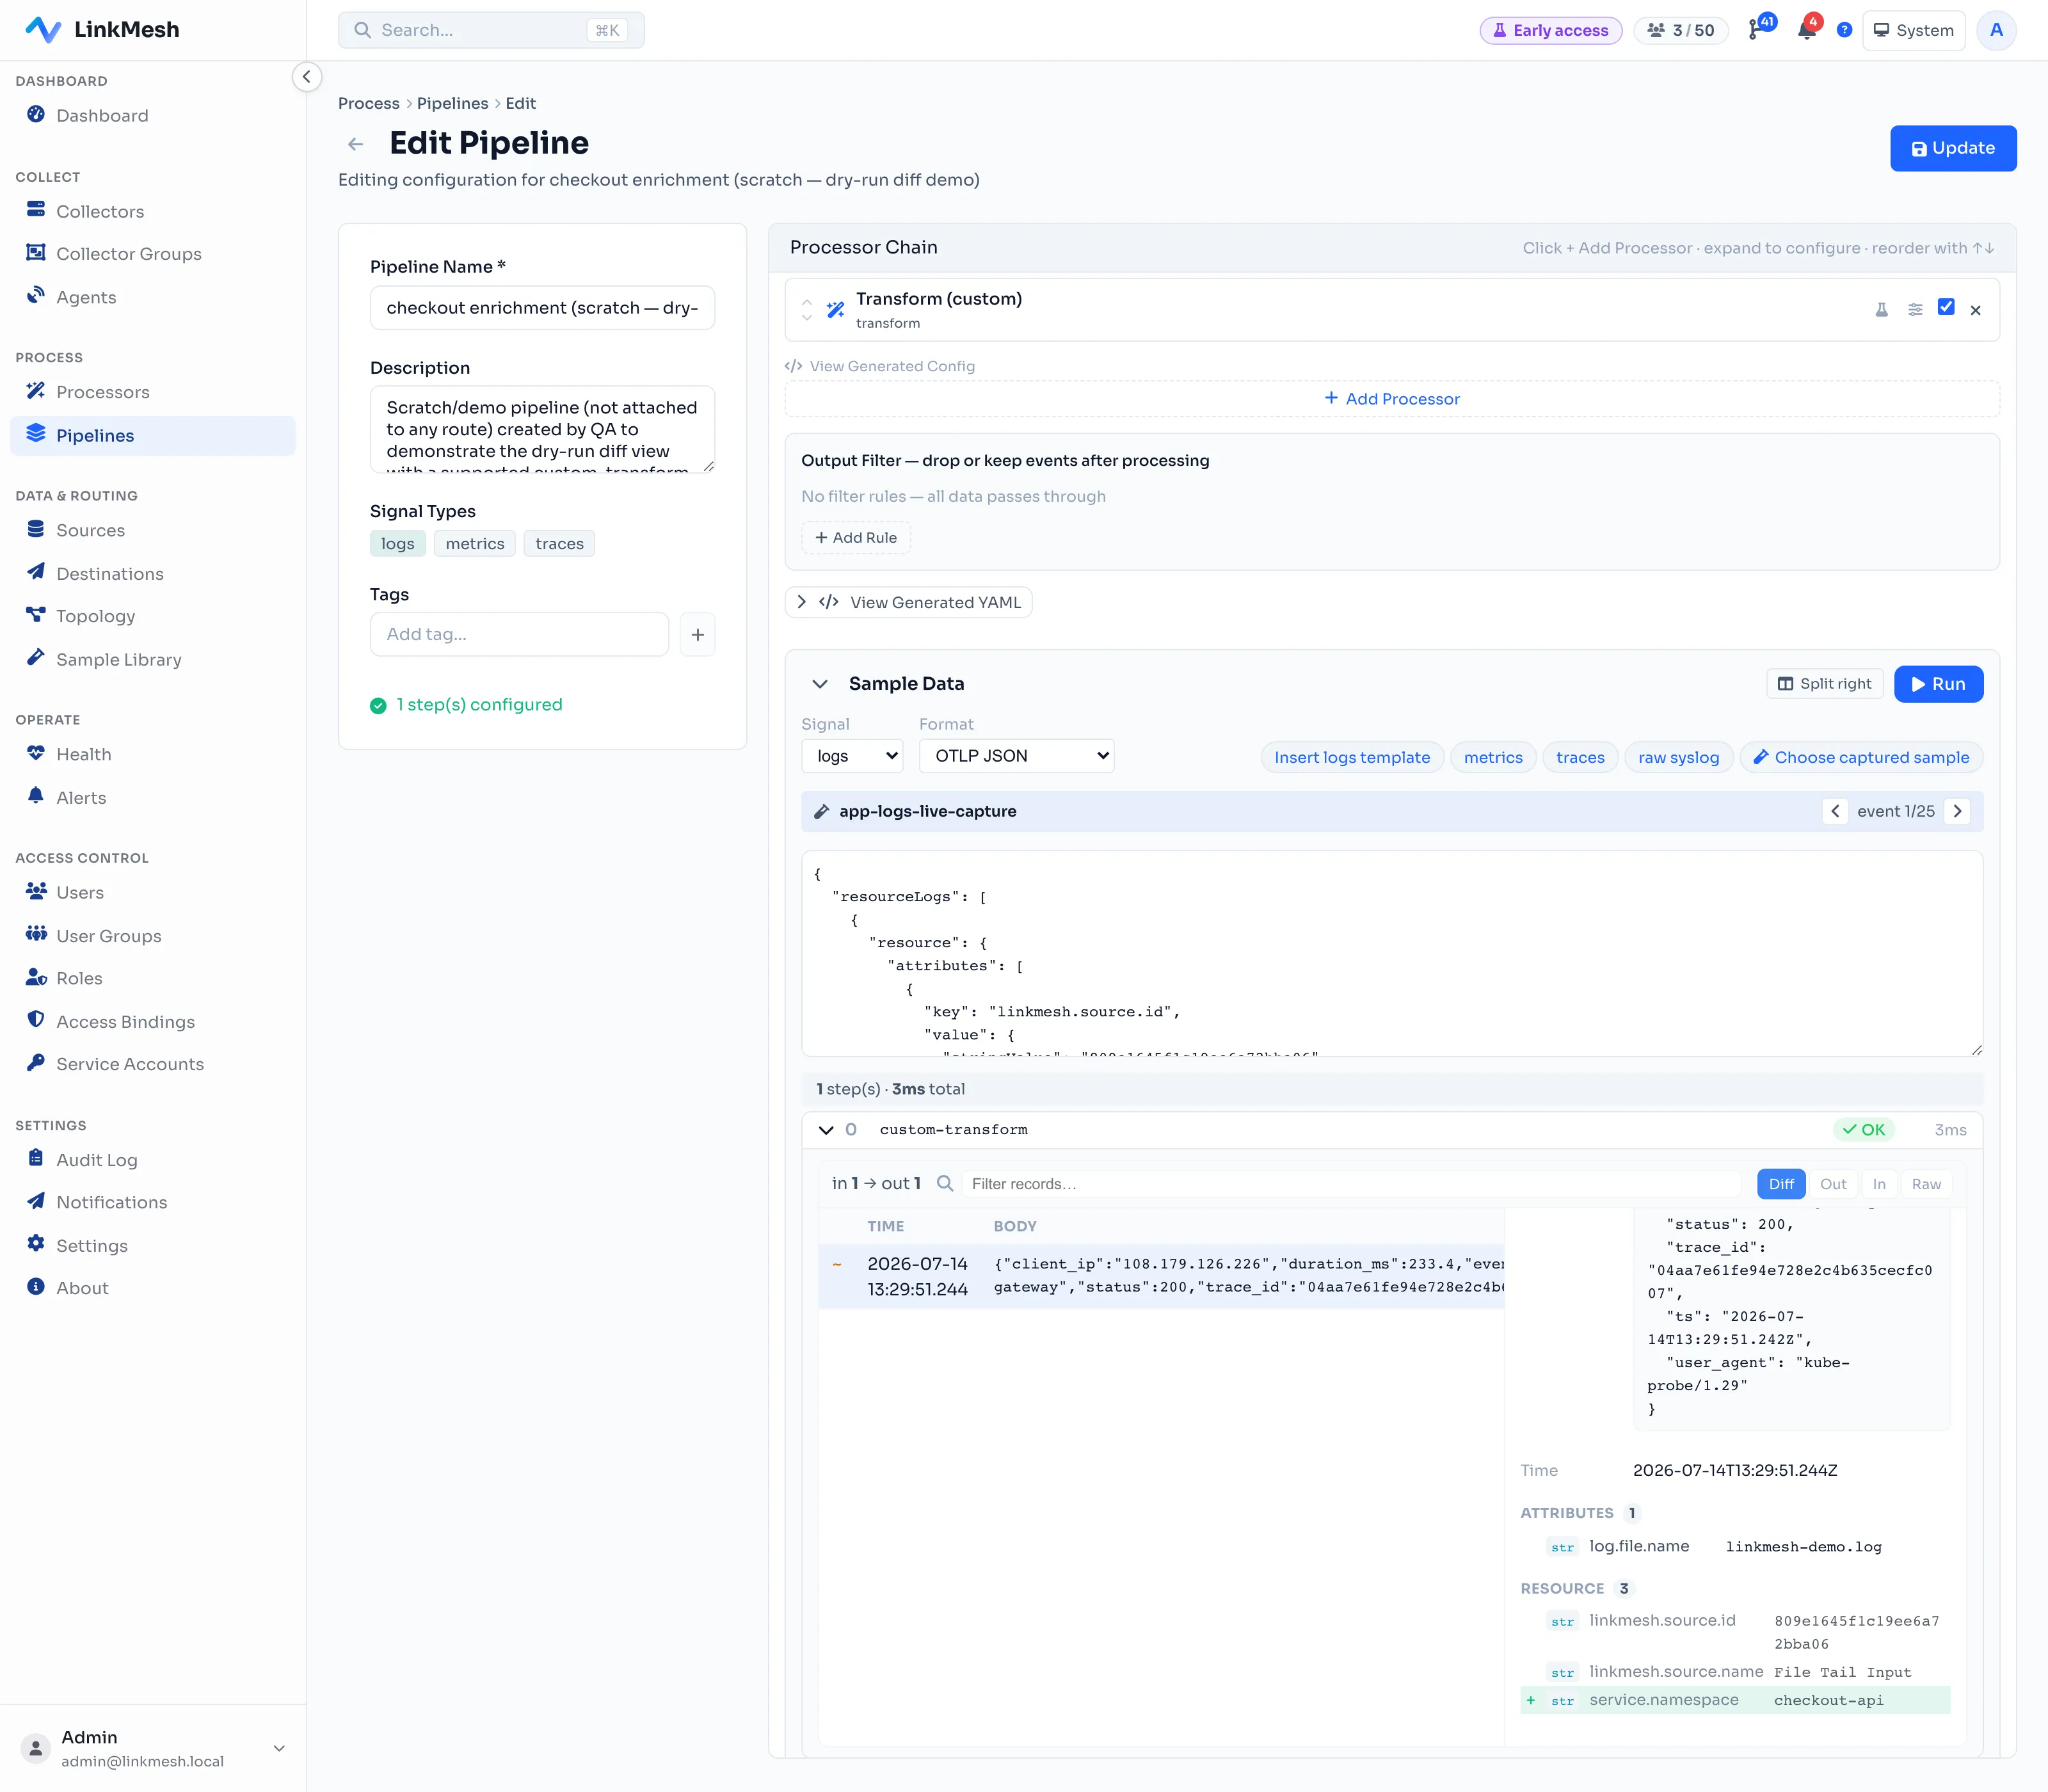
Eine Kette ist mehr als ein Schritt, und Bugs lieben die Nahtstellen zwischen ihnen – der Schritt, der ein Feld umschreibt, auf das der nächste Schritt gematcht hat, die Umsortierung, die ändert, was überlebt. Die Vorschau lässt Sie die Kette Schritt für Schritt durchlaufen: Wechseln Sie zum vorherigen oder nächsten Prozessor und beobachten Sie, wie sich dasselbe Record in jeder Stufe transformiert, mit dem Timing und Status jedes Schritts (durchgelassen oder verworfen) hervorgehoben.
Wenn der finale Output nicht das ist, was Sie erwartet haben, diffen Sie nicht den Input der ganzen Kette gegen ihren Output und blinzeln. Sie gehen schrittweise durch, bis Sie den genauen Prozessor finden, an dem das Record von dem abwich, was Sie wollten – und Sie beheben diesen einen.
Der Diff ist semantisch, nicht textuell: Er hebt genau die Attribute hervor, die ein Schritt hinzufügt, ändert oder verwirft. So ist eine Anreicherung, die still den falschen Wert setzt – oder gar nichts hinzufügt –, auf einen Blick offensichtlich, nicht in einer Wand aus JSON vergraben.
Gegen echte Records testen, nicht gegen eine Vermutung
Eine Vorschau ist nur so ehrlich wie die Daten, die Sie ihr geben. Sie können ein Sample von Hand einfügen, aber der schärfere Workflow ist, gegen Records zu testen, die Ihre Collectors tatsächlich gesehen haben.
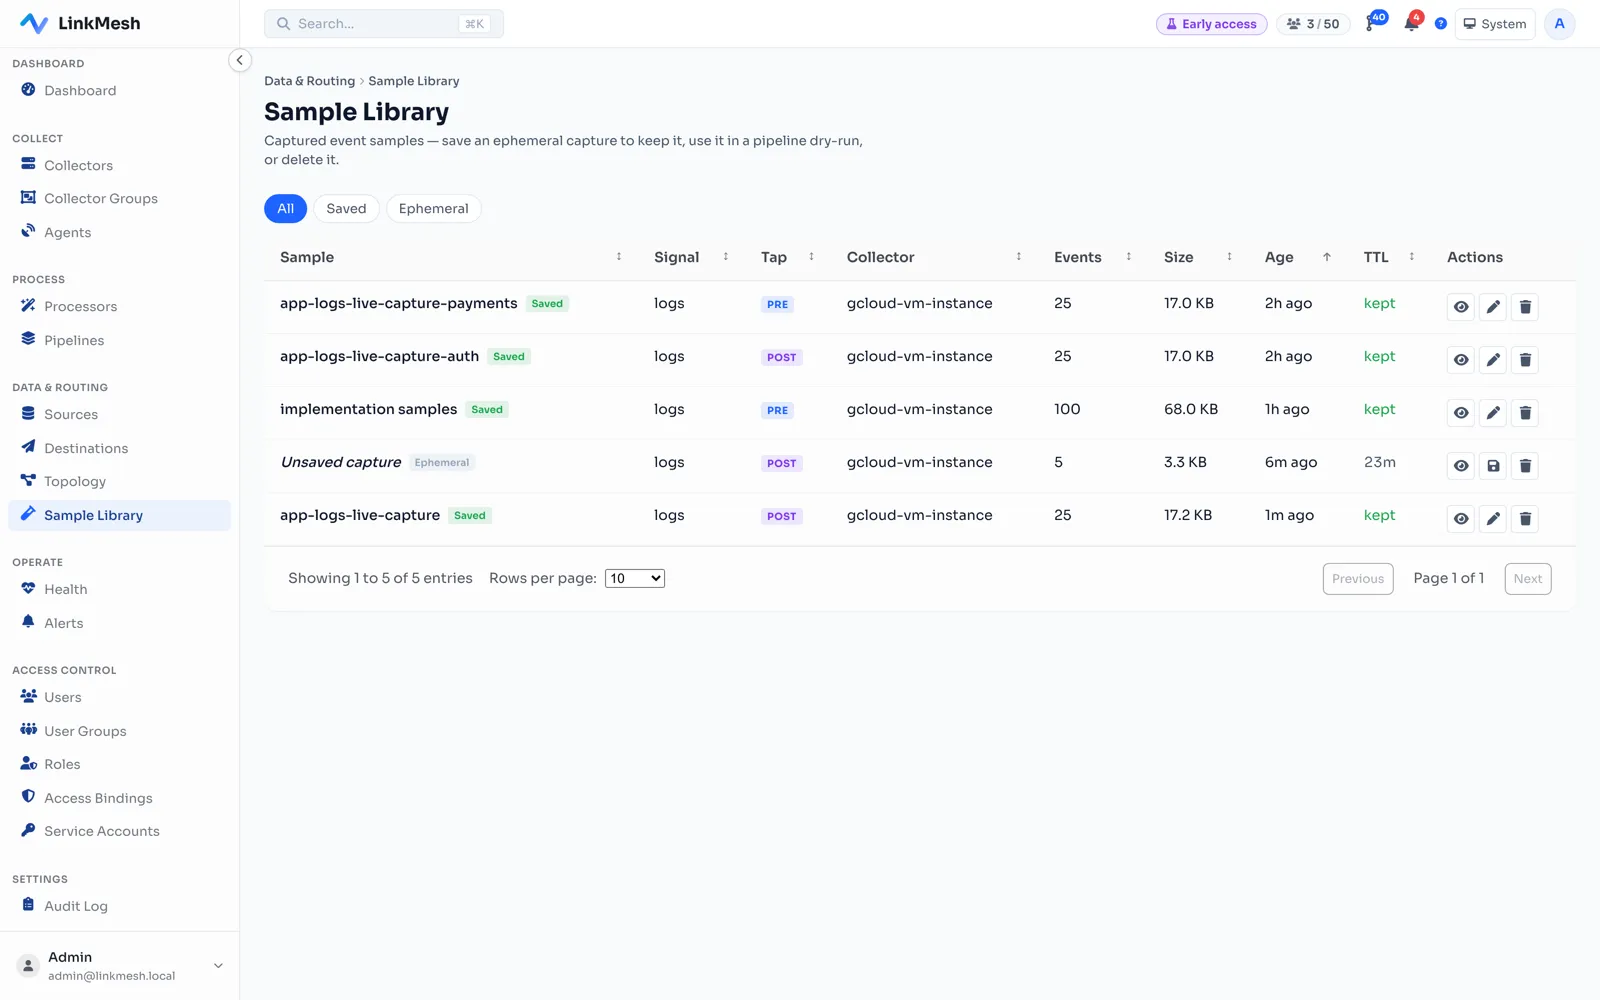
Erfassen Sie eine Handvoll Events auf einer Live-Route, speichern Sie sie in der Sample Library und spielen Sie sie in die Vorschau zurück. Nun validieren Sie Ihren Filter gegen die unordentlichen, realen Formen, die Ihre Services tatsächlich emittieren – die Log-Zeile mit dem unerwarteten Null, das Trace mit dem Attribut, von dessen Existenz Sie nichts wussten –, nicht gegen ein sauberes Beispiel, das immer durchgegangen wäre.
Mit Zuversicht bearbeiten
Nichts davon ändert, was eine Pipeline tun kann. Was es ändert, ist, wie es sich anfühlt, eine zu bauen. Statt schreiben-speichern-pushen-warten-hoffen bekommen Sie schreiben-sehen: jede Änderung gegen ein echtes Record validiert, in dem Moment, in dem Sie sie machen, die Regression zur Bearbeitungszeit gefangen statt in einem Incident-Kanal.
Das ist der Unterschied zwischen dem Ausrollen einer Pipeline, von der Sie denken, sie sei richtig, und einer, der Sie zugesehen haben, richtig zu sein.
Weiterlesen:
- Das Operator-How-to, Schritt für Schritt: Eine Prozessor-Kette in der Vorschau anzeigen
- Was ist eine Telemetrie-Pipeline?
- Telemetrie-Pipelines mit Live-Capture debuggen