
 LinkMeshObservability Data Collection Management
Semantic Conventions in der Praxis
Sich auf Attributnamen zu einigen ist einfach. Die Einigung flottenweit zu halten, ist die Arbeit.
 Roman Hüsler← Zurück zum Blog
Semantic Conventions sind der Teil von OpenTelemetry, dem alle zustimmen und
den fast niemand vollständig umgesetzt hat. Die Spezifikation sagt Ihnen, dass
ein HTTP-Statuscode unter http.response.status_code gehört, ein Servicename
unter service.name, ein Pod unter k8s.pod.name. Ihre Flotte enthält
derweil einen Service aus dem Jahr 2021, der http.status_code sendet, eine
Fremdkomponente, die status sendet, und einen Batch-Job, dessen Autor
überhaupt nicht an Konventionen gedacht hat.
Kurz gefasst — Namensabweichungen kündigen sich nicht an. Sie erzeugen Abfragen, die weniger liefern, als sie sollten, ohne Fehlermeldung irgendwo — und das Dashboard sieht gut aus. Die Korrektur in jedem Service ist richtig und langsam, denn sie erfordert eine Codeänderung, ein Release und ein Deployment in jedem Repository, und sie erreicht Komponenten nicht, deren Quellcode Ihnen nicht gehört. Die Korrektur im Collector ist eine einzige Umbenennungsregel für alles, was bereits durch die Pipeline fließt. Der schwierige Teil ist nicht, diese Regel zu schreiben — sondern sie auf jedem Collector gültig zu halten, während die Flotte wächst. Das ist ein Problem der Konfigurationsverteilung, kein OpenTelemetry-Problem. Legen Sie die Zielnamen fest, normalisieren Sie im Collector, versionieren Sie die Regel, rollen Sie sie als eine einzige Aktion aus und prüfen Sie gegen echten Traffic statt gegen die Konfiguration, die Sie anwenden wollten.
Der Fehlerfall ist eine Abfrage, die stillschweigend zu wenig meldet
Das ist der tatsächliche Preis von Namensabweichungen — und der Grund, warum es Monate dauert, ihn zu bemerken.
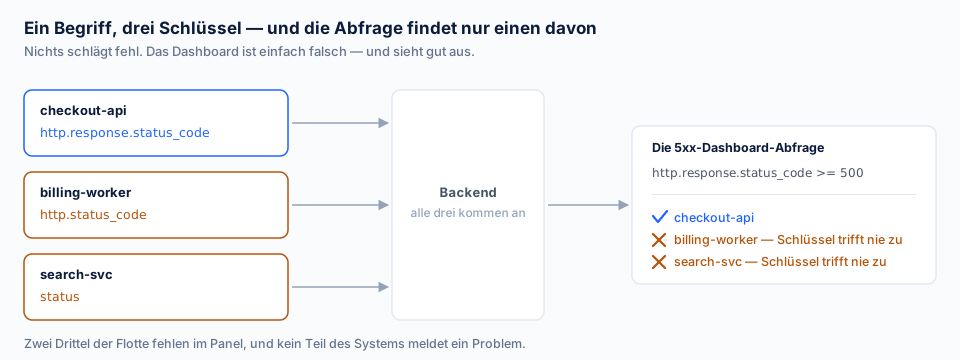
Drei Services senden, was ein Mensch „den HTTP-Statuscode” nennen würde. Einer verwendet die aktuelle Konvention. Zwei nicht. Alle drei kommen unversehrt im Backend an — nichts wird verworfen, nichts schlägt fehl, jede Ingest-Pipeline meldet sich gesund.
Dann baut jemand das 5xx-Panel und filtert auf
http.response.status_code >= 500. Dieser Filter trifft einen von drei
Services. Das Panel rendert, die Zahl wirkt plausibel, und sie ist um zwei
Drittel falsch. Niemand wird alarmiert, denn eine Untererfassung ist kein
Fehler, den irgendein Teil des Stacks erkennen soll.
Genau das unterscheidet Namensabweichungen von den meisten Pipeline-Problemen. Ein verworfener Batch zeigt sich in einer Queue-Metrik. Ein defekter Exporter zeigt sich in der Health des Collectors. Ein falsch benanntes Attribut zeigt sich als leicht enttäuschendes Dashboard — und wird niedrigem Traffic zugeschrieben.
Derselbe Mechanismus beschädigt stillschweigend alles Nachgelagerte, das auf Attributen aufsetzt: Alarmregeln, die für die halbe Flotte nie auslösen, Kostenzuordnung, die dem falschen Team zugerechnet wird, und attributbasiertes Routing, das nur einen Teil des vorgesehenen Traffics weiterleitet. Routing-Regeln verdienen besondere Erwähnung, denn eine Regel, die auf einen von zwei Services unterschiedlich geschriebenen Schlüssel matcht, scheitert in der Richtung, die am schwersten zu sehen ist: Die Daten gehen an das Standardziel und fließen weiter.
Warum die Korrektur nicht allein in Ihre Services gehört
Die prinzipientreue Antwort lautet, dass jeder Service von vornherein den richtigen Schlüssel senden sollte. Das stimmt, und Sie sollten weiter darauf hinarbeiten. Für sich genommen ist es allerdings ein Plan, der nicht konvergiert.
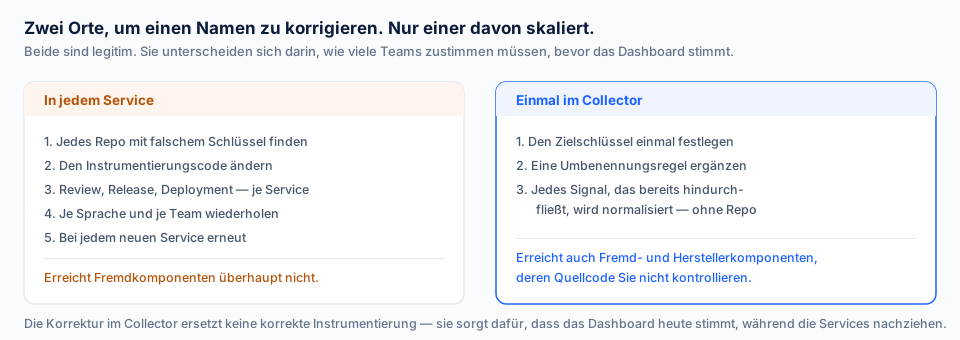
Die Korrektur in den Services bedeutet: jedes Repository finden, das den falschen Schlüssel sendet, die Instrumentierung ändern und das durch Review, Release und Deployment bringen — je Service, je Sprache, je Team, und danach erneut für jeden Service, der nach Ihrem Abschluss entsteht. Jeder dieser Schritte liegt im Sprint eines anderen.
Und es gibt eine Kategorie, die so überhaupt nicht erreichbar ist: Fremdkomponenten, Hersteller-Agents und alles, dessen Quellcode Sie nicht kontrollieren. Diese senden, was sie senden. Keine interne Konventionsarbeit ändert daran etwas.
Die Normalisierung im Collector kehrt die Rechnung um. Der Collector sieht ohnehin jedes Signal jedes Service — dafür ist er da. Eine einzige Umbenennungsregel dort gilt für alle auf einmal, einschließlich der Services, deren Teams keine Zeile geändert haben, und einschließlich der Komponenten, die Sie nie hätten patchen können.
Die beiden Ansätze stehen nicht in Konkurrenz. Normalisieren Sie im Collector, damit Ihre Abfragen heute stimmen; korrigieren Sie die Instrumentierung weiter stromaufwärts, damit die Umbenennungsregeln irgendwann entfallen können. Was Sie nicht tun sollten: das Erste auf das Zweite warten lassen.
Die drei Schritte, die die meisten Abweichungen abdecken
In Collector-Begriffen sind das vor allem die Prozessoren attributes und
transform, und drei Operationen decken nahezu alle realen Abweichungen ab:
- Umbenennen — der häufige Fall. Aus
http.status_codewirdhttp.response.status_code. Beide Schlüssel bedeuten dasselbe; einer davon ist die Konvention. In der LinkMesh-Prozessorbibliothek ist das ein Attributes-Schritt, der Attributschlüssel über den Rule Builder setzt, aktualisiert, löscht, hasht oder extrahiert — statt über handgeschriebene Konfiguration. - Hochziehen — ein Wert, der im Log-Body oder in einem verschachtelten JSON-Feld vergraben ist, wird zu einem erstklassigen Attribut unter dem konventionellen Schlüssel. Ein JSON Log Parser-Schritt, der die Top-Level-Schlüssel aus einem strukturierten Body extrahiert, ist meist der Anfang; für die härteren Fälle siehe unsaubere Logs parsen.
- Anreichern — das Attribut ist nicht falsch, es fehlt.
Kubernetes-Metadaten (
k8s.pod.name,k8s.namespace.name) und Cloud-Ressourcenattribute werden im Collector aus der Umgebung ergänzt, weil der Service sie schlicht nicht kennt.
Eine Warnung zum ersten Punkt, denn dort entsteht der Schaden. Das Umbenennen eines Schlüssels verändert, was jede bestehende Abfrage, jeder Alarm und jede Route findet, die auf diesen Schlüssel matcht. Bevor Sie umbenennen, sollten Sie wissen, wer den alten Schlüssel liest. Die sichere Reihenfolge auf einer laufenden Flotte: den neuen Schlüssel zusätzlich zum alten ergänzen, die Abfragen und Alarme migrieren, die ihn lesen, und erst dann das Original löschen — statt umzubenennen und anschließend herauszufinden, welche Dashboards von der bisherigen Schreibweise abhingen.
Und halten Sie die Zielliste kurz. Semantic Conventions decken eine enorme
Fläche ab, und der Versuch, sie auf einmal vollständig einzuhalten, erzeugt
eine Prozessorkette, die niemand pflegen wird. Die Attribute, die zuerst eine
Normalisierung verdienen, sind die, auf die tatsächlich etwas abfragt, routet
oder alarmiert: service.name, deployment.environment.name, die HTTP- und
Status-Schlüssel und alles, worauf Ihre eigenen Routing-Regeln matchen.
Aus einer Collector-Einstellung eine Flotteneigenschaft machen
Dieser Teil entscheidet, ob eine Konvention den Kontakt mit einer wachsenden Flotte übersteht — und er ist überhaupt kein OpenTelemetry-Problem.
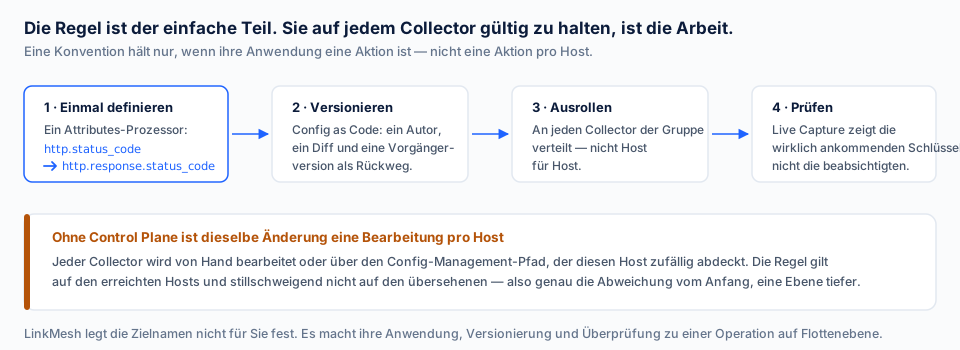
Schreiben Sie die Regel einmal. Legen Sie sie als versionierte Konfiguration ab, sodass die Änderung einen Autor, ein Diff und eine Vorgängerversion hat, zu der Sie zurückkehren können, wenn eine Umbenennung doch ein Panel zerlegt hat. Verteilen Sie sie dann als eine einzige Aktion an jeden Collector der Gruppe.
Ohne das ist Normalisierung eine Bearbeitung pro Host. Sie wenden die Regel auf den Collectors an, die Sie erreichen, und sie gilt stillschweigend nicht auf denen, die Sie übersehen — also genau die ursprüngliche Abweichung, eine Ebene tiefer und schwerer zu erkennen, denn nun meldet derselbe Service unterschiedliche Schlüssel, je nachdem welcher Collector ihn verarbeitet hat.
Hier lohnt sich Klartext über die Grenze: LinkMesh legt die Zielnamen nicht für Sie fest und erkennt Konventionsverstöße nicht für Sie. Sie entscheiden, was konform ist. Was die Control Plane ändert, sind die Kosten dieser Entscheidung — eine Normalisierungsregel wird zu einer versionierten Änderung, die an die Flotte ausgerollt wird, statt zu einer Bearbeitung, die auf jedem Host von Hand wiederholt und von der nächsten Person beim Onboarding neu hergeleitet wird. Das ist eine bewusste Abgrenzung, keine Lücke: Die Konventionen sind ein veröffentlichter Standard, und welche Teile davon zählen, ist eine Entscheidung über Ihre eigene Telemetrie.
Gegen echten Traffic prüfen, nicht gegen die Konfiguration
Eine Normalisierungsregel, die in der Konfiguration steht, ist nicht dasselbe wie eine Normalisierungsregel, die wirkt. Der Prozessor kann nach dem Schritt sitzen, der das Attribut entfernt. Der Schlüssel kann mit abweichender Groß-/Kleinschreibung ankommen. Der Service kann ihn auf der Ressource statt auf dem Record senden.
Prüfen Sie also die ankommenden Daten, nicht die beabsichtigten. Erfassen Sie nach dem Rollout Live-Traffic auf einem Collector und lesen Sie die Attributschlüssel, die tatsächlich vorhanden sind — die Technik aus Telemetrie-Pipelines mit Live Capture debuggen. Die Frage, die Sie beantworten, ist eng und konkret: Trägt nach dieser Regel jeder Stream den konventionellen Schlüssel?
Führen Sie dann die Abfrage erneut aus, die zu wenig gemeldet hat. Wenn sich das 5xx-Panel bewegt, sobald Sie normalisieren, ist das Ihre Bestätigung — und zugleich ein Maß dafür, wie falsch es war.
Was das nicht löst
Die Normalisierung von Namen macht Attribute konsistent. Sie macht sie nicht korrekt. Wenn ein Service den falschen Statuscode meldet, liefert das Umbenennen des Schlüssels eine verlässlich falsche Zahl unter einem konventionellen Namen.
Ebenso wenig repariert sie rückwirkend Daten, die bereits im Backend liegen. Alles, was unter dem alten Schlüssel gespeichert wurde, bleibt dort. Abfragen über den Rollout-Zeitpunkt hinweg müssen daher beide Schreibweisen treffen, bis das Retention-Fenster darüber hinweggezogen ist. Planen Sie das ein, statt sich davon überraschen zu lassen — ein Dashboard, das am Rollout-Tag einen scharfen Verhaltenswechsel zu zeigen scheint, zeigt meist den Rollout.
Und die Konventionen selbst bewegen sich. Die HTTP-Konventionen haben auf dem Weg zu „stable” bereits Umbenennungen durchlaufen — genau so landen Flotten bei zwei Schreibweisen derselben Idee. Normalisierungsregeln sind keine einmalige Aufräumaktion, sondern ein kleines Stück laufender Pflege, das der Spezifikation folgt.
Wo Sie anfangen
Nehmen Sie das eine Attribut, das Sie bereits etwas kostet. Nicht die vollständige Konventionsliste — einen Schlüssel, von dem ein Dashboard, eine Route oder ein Alarm abhängt.
- Fragen Sie Ihr Backend nach dem Begriff ab, nicht nach dem Schlüssel. Finden Sie die Schreibweisen, die in der letzten Woche tatsächlich vorkamen.
- Wählen Sie das konventionelle Ziel aus der OpenTelemetry-Semantic-Conventions-Registry.
- Ergänzen Sie den neuen Schlüssel zusätzlich zum alten im Collector, auf einer Collector-Gruppe.
- Erfassen Sie Live-Traffic und bestätigen Sie, dass der Schlüssel ankommt.
- Migrieren Sie die Abfragen, Alarme und Routen, die den alten Schlüssel lesen. Löschen Sie dann den alten Schlüssel.
- Rollen Sie die Regel als eine versionierte Änderung an den Rest der Flotte aus.
Die gesamte Schleife dauert beim ersten Attribut einen Nachmittag und bei den folgenden Minuten, weil Schritt 6 jedes Mal dieselbe Aktion ist. Wenn nicht — wenn das Ausrollen einer Prozessoränderung an die Flotte selbst ein Projekt ist — dann ist das, und nicht die Konventionen, das zuerst zu lösende Problem.
Wenn Ihre Collectors noch einzeln verwaltet werden, finden Sie die Grundlagen dazu, warum diese Ebene existiert, unter Was eine Telemetrie-Pipeline eigentlich ist. LinkMesh ist die selbstgehostete Control Plane, die wir genau dafür bauen: ein Ort, um einen Prozessor zu definieren, ihn zu versionieren und ihn an jeden Collector auszurollen, den Sie betreiben — auf Ihrer eigenen Infrastruktur.