
 LinkMeshObservability Data Collection Management
Eine zentrale Observability-Plattform aufbauen
Ein praktischer Pilot für hybride Infrastruktur, gemeinsame Standards und kontrollierte Änderungen.
 Roman Hüsler← Zurück zum Blog
Eine zentrale Observability-Plattform benötigt einen wiederholbaren Weg, um Workloads anzubinden, Standards anzuwenden und die Ankunft der Betriebsdaten am richtigen Ziel nachzuweisen. In einer hybriden Umgebung wird sonst jede neue Applikation zur nächsten Einzelverhandlung über Agents, Firewall-Regeln, Attribute und Zuständigkeiten.
Dieser Leitfaden richtet sich an Plattformteams und Solution-Architekten, die Collector-Verwaltung über On-Premises und Azure hinweg evaluieren – einschliesslich Kubernetes. Im Mittelpunkt stehen das Betriebsmodell und die Nachweise vor einem grösseren Rollout. Grundlagen zur Collector-Topologie finden Sie im separaten Leitfaden zur Enterprise-Architektur.
Mit einem Service und einer verantwortlichen Person beginnen
Wählen Sie einen Geschäftsservice, dessen Verantwortliche erklären können, wie sich ein Ausfall auswirkt. Legen Sie fest, welche Transaktionen zählen, welche Indikatoren Probleme sichtbar machen und wer reagiert. Gesunde Server beweisen noch nicht, dass Kunden eine Zahlung abschliessen oder einen Auftrag übermitteln können.
Übersetzen Sie diese Prioritäten in eine überschaubare Vereinbarung: benötigte Signale, Resource-Attribute, Service-Ziele, Aufbewahrung, Zielsystem und Betriebsverantwortung. Halten Sie den ersten Pilot klein genug, um einzelne Ereignisse und eine Änderung durch die gesamte Pipeline verfolgen zu können.
| Verantwortung | Zuständiges Team | Ergebnis des Piloten |
|---|---|---|
| Geschäftsauswirkung und akzeptable Störung | Service-Verantwortliche | Priorisierte Nutzerreise und Zuverlässigkeitsziele |
| Instrumentierung und Signalqualität | Applikationsteam | Repräsentative Traces, Metriken und Logs |
| Collector-Konfiguration und Betrieb | Plattformteam | Wiederverwendbare Vorlage und Wiederherstellungsablauf |
| Datenklassifikation und Zugriff | Security und Datenschutz | Freigegebene Datenwege und Zugriffsanforderungen |
| Reaktion und Eskalation | Betrieb / ITSM | Getestete Übergabe vom Alert zum Incident |
Diese Aufgaben können sich überschneiden. Halten Sie fest, wer Änderungen freigibt und wer sie umsetzen darf; ein Diagramm schafft diese Befugnisse nicht.
Vier Architekturaufgaben voneinander trennen
Applikationen und Infrastruktur erzeugen Telemetrie. Collectors empfangen, verarbeiten und exportieren sie. Observability-Backends speichern und analysieren sie. ITSM-Systeme verbinden Betriebssignale mit Incidents, Zuständigkeiten und Changes.
LinkMesh liefert die Verwaltungsschicht für Collectors und Pipelines. Backend-Speicherung, Dashboard-Provisionierung, CMDB und Incident-Prozesse bleiben eigene Aufgaben. Planen Sie deren Integration ausdrücklich ein.
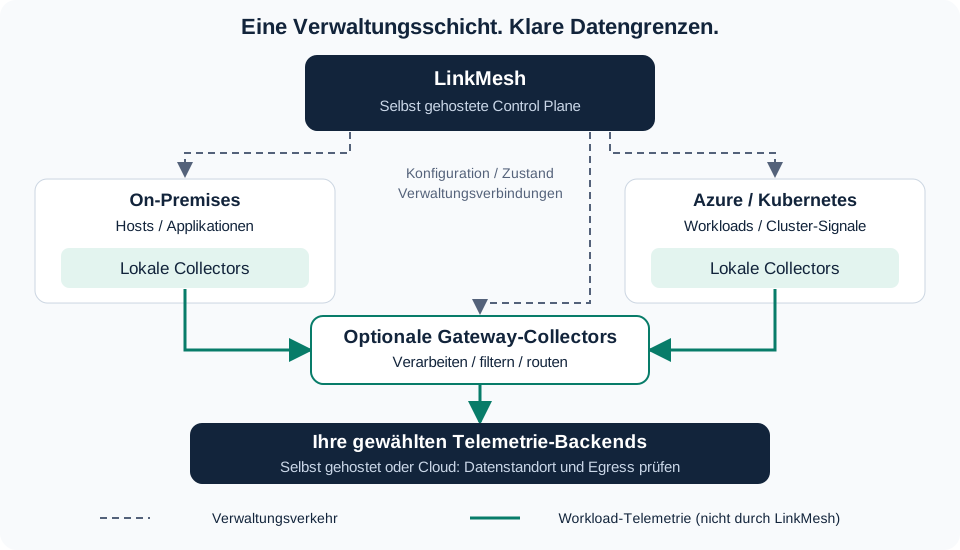
Referenzentwurf, keine Zertifizierung eines konkreten AKS- oder OpenShift-Deployments. Diagramm in voller Grösse öffnen.
Setzen Sie lokale Collectors ein, wo Host-Zugriff oder frühe Filterung erforderlich sind. Ergänzen Sie Gateways, wenn zentraler Egress, Aggregation oder Verarbeitung eine zusätzliche Betriebsabhängigkeit rechtfertigen. Die OpenTelemetry-Anleitungen zu Agents und Gateways helfen bei der Auswahl der Topologie (Englisch).
Prüfen Sie pro Umgebung Distribution und Version, verfügbare Receiver, Dienstidentität, Zertifikate und ausgehende Verbindungen. Auf AKS oder OpenShift kommen Namespace-Rechte, Host-Mounts und Cluster-Sicherheitsrichtlinien hinzu. Ein allgemeines Kubernetes-Manifest belegt nicht, dass privilegierte Host-Erfassung zulässig ist.
Eine Vorlage für das Onboarding definieren
Eine Vorlage sollte einem Applikationsteam ermöglichen, wenige Fragen zu beantworten und eine prüfbare Konfiguration zu erhalten. Nicht jeder Server benötigt jeden Receiver.
| Bestandteil der Vorlage | Beispiel einer Entscheidung |
|---|---|
| Workload-Identität | service.name, service.namespace, deployment.environment.name |
| Organisatorische Zuständigkeit | Ein dokumentiertes eigenes Attribut wie example.company.team |
| Quellen | Applikations-OTLP, Host-Metriken, ausgewählte Log-Pfade oder Event-Kanäle |
| Verarbeitung | Pflichtanreicherung, ausdrückliche Drop-Regeln und Behandlung sensibler Daten |
| Ziele | Freigegebene Backend-Endpunkte und umgebungsspezifische Zugangsdaten |
| Betrieb | Collector-Verantwortung, Version, Ressourcenlimits und Wiederherstellung |
Das Attribut für die Zuständigkeit ist eine organisatorische Konvention, kein standardisiertes OpenTelemetry-Resource-Attribut. Stimmen Sie Benennung und Validierung mit den Teams ab, die die Daten abfragen.
Testen Sie Filter mit synthetischen Secrets und Identifikatoren. Prüfen Sie tatsächlich exportierte Log-Inhalte und Attribute, einschliesslich verschachtelter Felder. Ein vorhandener Processor beweist nicht, dass jeder sensible Wert entfernt wird.
Infrastrukturautomatisierung und Konfigurationsverwaltung verbinden
Provisionieren Sie Compute, Netzwerk, Dienstidentitäten und Collector-Installation über Ihren IaC-Prozess. Dokumentieren Sie anschliessend, wie Konfiguration jeden unterstützten Collector erreicht. LinkMesh nutzt den Remote-Konfigurationsmechanismus der jeweiligen Runtime. Prüfen Sie native Remote-Konfiguration (Englisch) und die Kompatibilitätsmatrix, bevor Sie Versionen auswählen.
Für den Änderungsprozess gelten wichtige Grenzen:
- Speichern wendet Konfiguration an. Behandeln Sie die Oberfläche nicht als Entwurf mit späterer Freigabe. Erproben Sie Änderungen in einer separaten Testgruppe vor der Produktion.
- Die externe Git-Integration ist ein Historienspiegel. LinkMesh schreibt die Historie nach Git; Änderungen im Repository werden nicht als Deployments eingelesen. Siehe Einrichtung des Git-Spiegels (Englisch).
- Ein Konfigurations-Rollback stellt Quellen-/Zieleinstellungen und Secret-Werte nicht wieder her. Erfassen Sie deren Wiederherstellung separat.
- Prüfen Sie aktuelle Editionsgrenzen für Rollback, Automatisierung und Identitätsanbindung. Die Dokumentation zur Versionshistorie beschreibt die unterstützten Operationen (Englisch).
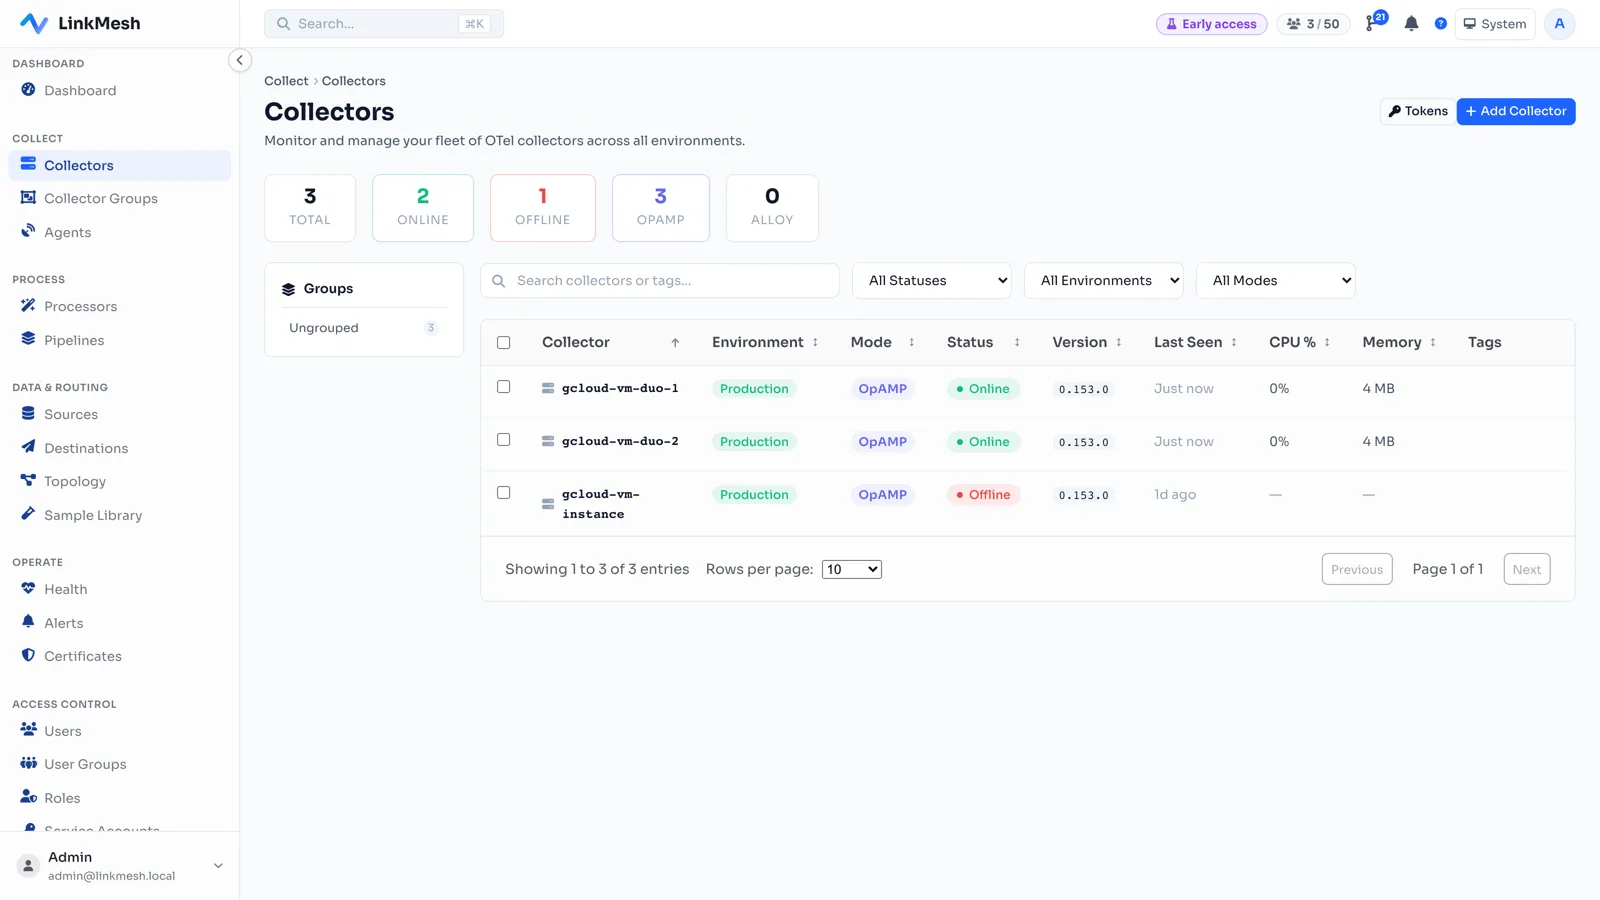
Prüfen Sie vor einer Konfigurationsänderung die verbundenen Runtimes und die Zuständigkeiten Ihres Piloten anhand des Inventars.
Security und Legacy-Abdeckung prüfbar machen
Self-Hosting gibt Ihnen eine Deployment-Option. Eine regulatorische Abnahme hängt weiterhin vom Gesamtsystem ab: Datenklassifikation, Identität, Verschlüsselung, Aufbewahrung, Betriebsabläufe und externe Abhängigkeiten. Prüfen Sie BYOK-/KMS-Anforderungen separat, statt sie aus dem Hosting-Modell abzuleiten.
Untersuchen Sie Verwaltungsverkehr ebenso wie Workload-Telemetrie. Konfiguration, Inventar, Zustand und Collector-Selbsttelemetrie benötigen ein freigegebenes Ziel. Diagnostische Sample-Erfassung ist ein zusätzlicher Ablauf für die Datenbehandlung. Beginnen Sie mit der gepflegten Dokumentation zu Security und Konnektivität (Englisch).
Erstellen Sie vor einer Agent-Ablösung eine Abdeckungsmatrix. Vergleichen Sie die Eingaben vorhandener Dashboards und Alerts und nicht nur Ereigniszahlen. Behalten Sie proprietäre Monitoring-Funktionen, wo sie weiterhin benötigt werden. Begrenzen Sie Dual Shipping auf eine definierte Gruppe und Beobachtungsdauer mit getrennten Routen und einem Volumenbudget; siehe Dual Shipping ohne Duplikate.
PoV-Checkliste mit Abnahmenachweisen
Vereinbaren Sie numerische Schwellen mit den Service-Verantwortlichen vor dem Start. Die Tabelle schlägt Messungen vor und verspricht keine Produktergebnisse.
| Test | Zu erfassender Nachweis | Abnahmeentscheidung |
|---|---|---|
| Einen On-Premises- und einen Kubernetes-Workload anbinden | Dauer, manuelle Schritte, Rechte und verbundene Versionen | Onboarding-Ziel eingehalten; jede Abhängigkeit dokumentiert |
| Signalabdeckung validieren | Mengen, Zeitstempel, Resource-Attribute und Dashboard-/Alert-Eingaben | Benötigte Abdeckung und vereinbarte Toleranzen erreicht |
| Regeln für sensible Daten testen | Synthetische Testwerte an jedem Ziel prüfen | Keine unzulässigen Testwerte über die geprüften Datenwege exportiert |
| Konfiguration ändern und zurücksetzen | Diff, wirksame Konfiguration und Wiederherstellungsprotokoll | Vorheriges Verhalten inklusive Einstellungen ausserhalb der Historie wiederhergestellt |
| Control-Plane-Verbindung unterbrechen | Fortgesetzte Erfassung und Wiederverbindung nachweisen | Verhalten entspricht dem vereinbarten Ausfallmodell |
| Backend-Verbindung unterbrechen | Queue-Wachstum, Retries, Verlust, Ressourcen und Wiederanlaufzeit | Verlust und Wiederherstellung innerhalb vereinbarter Grenzen |
| Zugriffsgrenzen prüfen | Erlaubte und verweigerte Operationen repräsentativer Rollen | Berechtigungen entsprechen der freigegebenen Aufgabenverteilung |
| Einen Alert an den Betrieb übergeben | Service-Identität, Incident-Routing und Bestätigung durch Zuständige | Betrieb erkennt den Service und kann handeln |
Messen Sie unter repräsentativer Last auch CPU, Speicher, Ingest-Volumen und Betriebsaufwand. Diese Beobachtungen unterstützen Kapazitäts- und Kostenentscheidungen; sie ersetzen keine längere Produktionsvalidierung.
Aus dem Pilot eine Evaluationsentscheidung machen
Schliessen Sie mit einem kompakten Nachweispaket ab: freigegebene Architektur, Kompatibilitätsergebnisse, Onboarding-Vorlage, Zugriffsmodell, Änderungs- und Wiederherstellungsablauf, offene Lücken und benannte Verantwortliche. Entscheiden Sie, welche Lücken die Einführung verhindern und welche während eines begrenzten Rollouts bearbeitet werden können.
Gleichen Sie LinkMesh über die Seite zur selbst gehosteten OpenTelemetry Control Plane mit Ihren Anforderungen ab. Bringen Sie Collector-Inventar, Ziel-Backends und Pilotkriterien in ein technisches Evaluationsgespräch ein oder verbinden Sie Ihren ersten Collector.