
 LinkMeshObservability Data Collection Management
GitOps für Observability
Versionierte Collector-Konfiguration – samt Drift.
 Roman Hüsler← Zurück zum Blog
Platform-Teams haben schon vor Jahren gelernt, die Produktion nicht per SSH von Hand zu bearbeiten. Infrastruktur wurde zu Code: versioniert, reviewt, zurückrollbar. Die Observability-Konfiguration hat diese Botschaft irgendwie nicht erhalten – zahlreiche Fleets laufen noch immer auf YAML-Dateien, die direkt vor Ort bearbeitet werden, Host für Host, ohne Historie und ohne die Möglichkeit zu wissen, was wo tatsächlich deployt ist.
In diesem Beitrag geht es darum, GitOps auf Observability anzuwenden: was es bedeutet, Collector-Konfiguration als Code zu behandeln, warum ein Git-Repository allein das Problem nur zur Hälfte löst und was eine Git-basierte Control Plane ergänzt – Commit-/Publish-Workflows, Versionshistorie und die Drift-Erkennung, die reines GitOps nicht bieten kann.
Das Problem der Konfigurations-Drift
Stellen Sie sich 30 Hosts vor, auf denen jeweils ein OpenTelemetry Collector läuft, jeder mit seiner eigenen YAML-Datei. Jemand passt während eines Incidents einen Processor auf Host 12 an und vergisst, es zu dokumentieren. Ein Playbook-Lauf wird nur halb angewendet, weil drei Hosts nicht erreichbar waren. Ein neuer Kollege kopiert eine alte Konfiguration auf einen frischen Node. Innerhalb von Wochen ist „die Konfiguration des Fleets” nicht mehr eine Sache – es sind 30 leicht unterschiedliche Dinge, und niemand kann mit Sicherheit sagen, was auf einem bestimmten Host läuft.
Das ist Konfigurations-Drift, und sie ist zersetzend: Sie erschwert das Nachvollziehen von Incidents („läuft dieser Host überhaupt auf der aktuellen Konfiguration?“), sie macht Änderungen riskant und sie hebt still und heimlich die Standardisierung auf, die Sie eigentlich durchsetzen wollten.
Warum reines GitOps das Problem nur halb löst
Die naheliegende Lösung ist ein Git-Repository mit Collector-Konfigurationen plus ein CI-Job, der sie ausrollt. Das ist eine echte Verbesserung – Sie bekommen Historie und Review für die Dateien. Aber ein Repository voller YAML hat drei Lücken, die speziell für Observability von Bedeutung sind:
- Keine Validierung. Git versioniert bereitwillig eine Konfiguration mit einem vertippten Receiver oder einer ungültigen Pipeline. Sie merken es erst, wenn ein Collector nicht startet und die Ingestion stoppt – nach dem Merge, in Produktion.
- Kein Live-Zustand. Das Repository sagt Ihnen, was deployt sein sollte. Es sagt nichts darüber, was auf jedem Host gerade tatsächlich läuft oder ob der letzte Push überhaupt angekommen ist.
- Keine Drift-Erkennung. Wenn jemand einen Host von Hand bearbeitet, weiss das Repository nichts davon. Ihre Source of Truth und Ihre Realität sind still auseinandergedriftet, und nichts weist Sie darauf hin.
Git liefert Ihnen den gewünschten Zustand. Observability-GitOps braucht zusätzlich den angewendeten Zustand und eine Möglichkeit, beide zu vergleichen – genau das ergänzt eine Control Plane obendrauf.
Eine Git-basierte Control Plane: Änderungen werden zu Commits
Das Modell, das diese Lücken schliesst: Behalten Sie Git als Source of Truth, aber stellen Sie ihm eine Control Plane voran, die Konfiguration sowohl erstellt als auch anwendet.
Jede Änderung, die Sie in der UI vornehmen, wird zu einem Commit – die Konfiguration wird in Git gespeichert, versioniert und reviewbar, bevor sie gerendert, validiert und an das Fleet published wird. Sie bekommen den gesamten Code-Workflow – eine Änderung vorschlagen, reviewen, publishen und bei Fehlverhalten auf einen beliebigen früheren Commit zurückrollen – ohne dass jemand YAML pro Host von Hand schreibt.
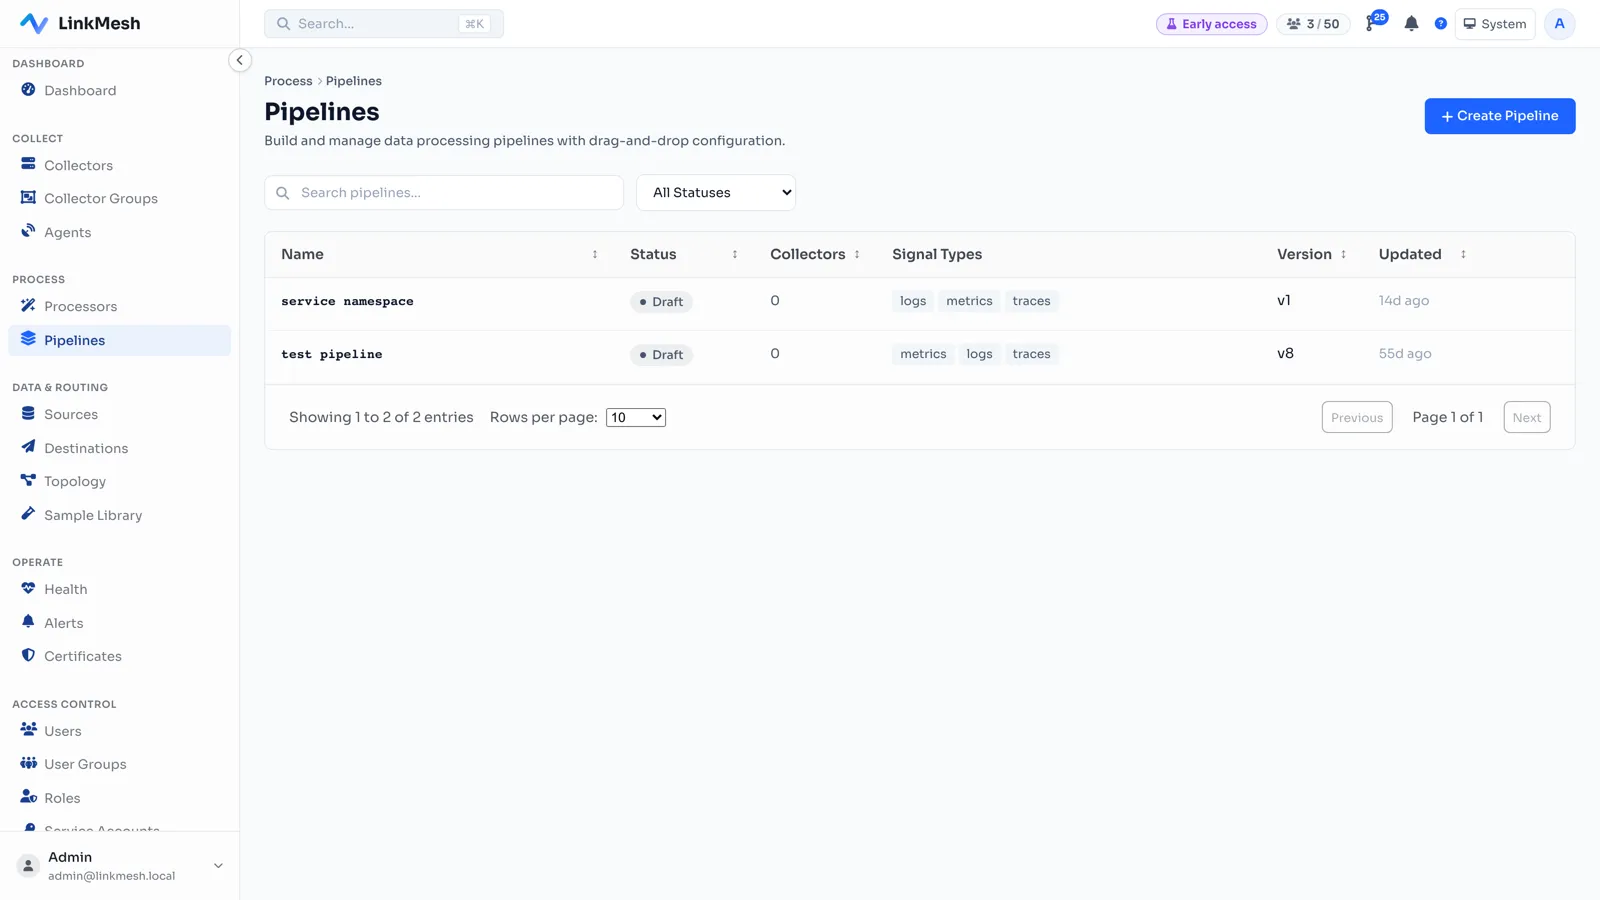
Der Validierungsschritt ist das Stück, das reines GitOps verpasst: Weil die Control Plane die tatsächliche Collector-Konfiguration rendert, kann sie eine ungültige Pipeline ablehnen, bevor sie ausgeliefert wird, statt den Tippfehler zu entdecken, wenn ein Collector nicht startet. (Falls Ihnen noch neu ist, wie Konfiguration zu den Collectors gelangt, behandelt OpAMP erklärt die Mechanik der Auslieferung.)
Wer hat wann was geändert
Sobald die Konfiguration Git-basiert ist, kommt der Audit-Trail gratis dazu – und er
sollte ein erstklassiges Feature sein, kein rohes Commit-Log, durch das Sie sich per
git blame kämpfen musst. Jede Änderung ist zuordenbar: wer sie gemacht hat, wann und
was genau sich geändert hat, mit einem lesbaren Diff.
Das zählt am meisten in den zwei Momenten, in denen Sie am wenigsten raten wollen: während eines Incidents („was hat sich unmittelbar vor diesem Ausfall geändert, und können wir es zurücknehmen?“) und während eines Reviews („wer hat im letzten Quartal zuletzt die Redaction-Regeln angefasst?”). Eine Versionshistorie, die diese Fragen mit einem Klick beantwortet, verwandelt Konfigurationsänderungen von einer Quelle der Anspannung in einen routinemässigen, umkehrbaren Vorgang.
Drift-Erkennung: gewünscht vs. angewendet
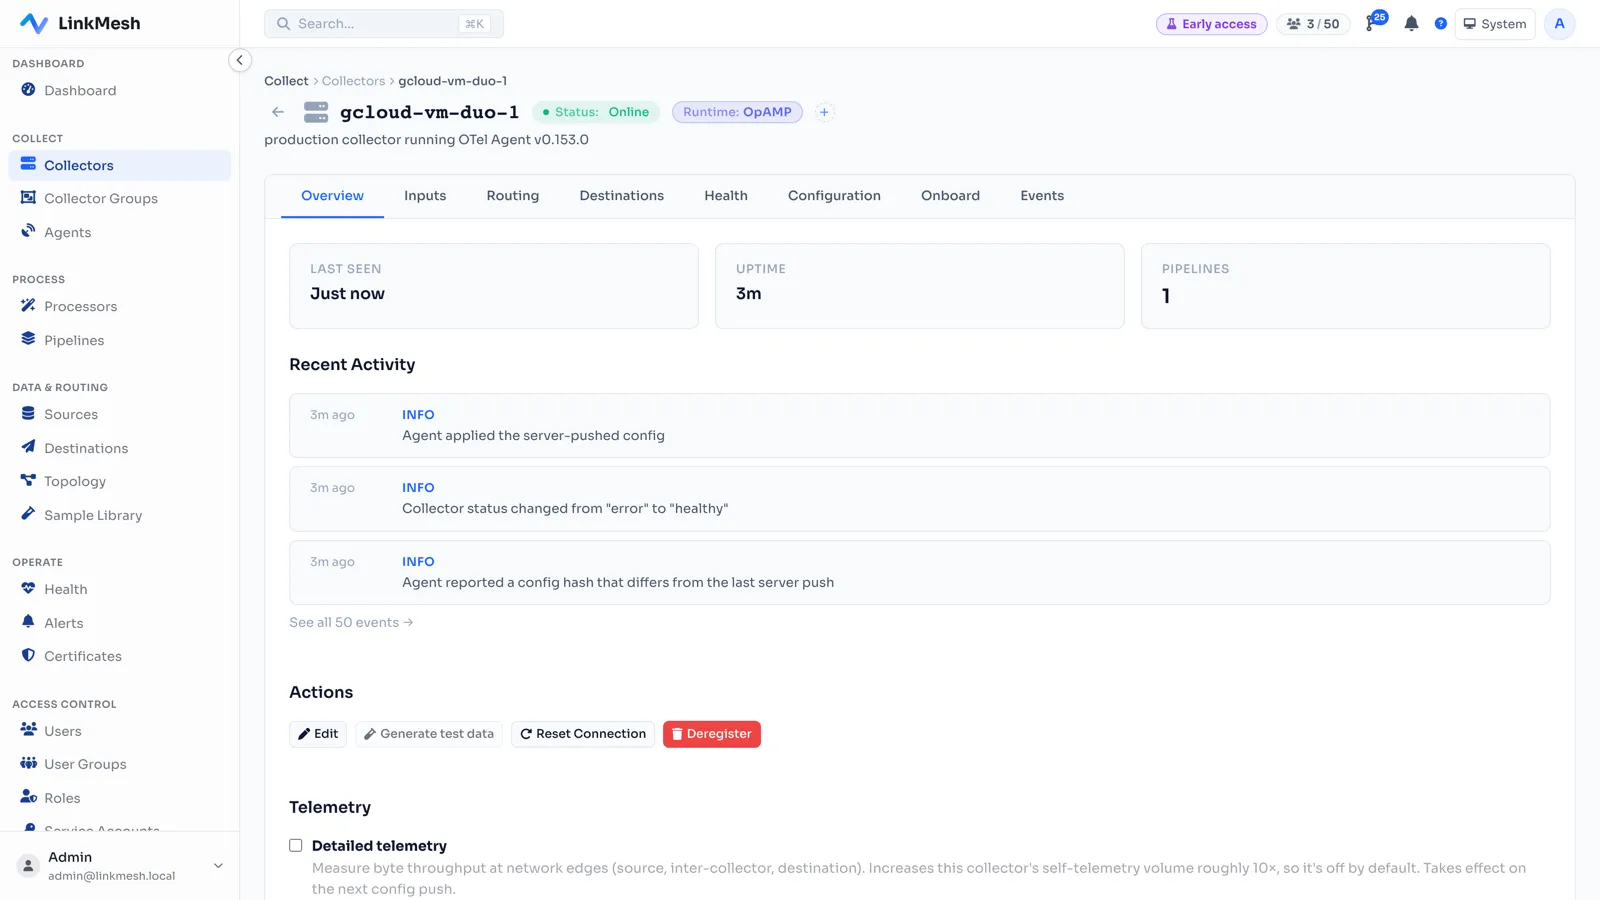
Das ist die Fähigkeit, die echtes Observability-GitOps von einem Repository voller YAML unterscheidet. Weil jeder Collector seine effektive Konfiguration an die Control Plane zurückmeldet, kann die Plattform kontinuierlich vergleichen, was laut Git laufen sollte, mit dem, was jeder Host tatsächlich ausführt – und die Differenz markieren.
Wenn also jemand um 2 Uhr nachts einen Host von Hand bearbeitet oder ein Push nur halb ankommt, finden Sie das nicht erst Wochen später heraus, wenn Daten fehlen. Die Fleet-Ansicht zeigt den Host als gedriftet an, Sie sehen den Diff, und ein erneutes Anwenden der committeten Konfiguration bringt ihn wieder in Linie. Gewünschter Zustand und Realität bleiben konvergiert – was von Anfang an der ganze Sinn von GitOps war.
Sie können Drift wie jeden anderen Alert behandeln: sichtbar machen, entscheiden, ob die Handänderung ein legitimer Fix war, der zurück committet werden sollte, oder ein Versehen, das zurückgenommen werden muss, und in einer Aktion abgleichen. So oder so bleibt die Git-Historie der einzige Nachweis dafür, was das Fleet ausführen soll – keine Archäologie mehr, um zu rekonstruieren, was sich geändert hat.
Observability als Code, richtig gemacht
Collector-Konfiguration als Code zu behandeln, ist nicht nur Ordnungsliebe – es ist die Art, wie Sie Änderungen an einem Fleet sicher und umkehrbar vornehmen. Die vollständige Version braucht vier Dinge, die ein reines Repository allein nicht liefern kann: Validierung vor dem Publish, Live-Zustand von jedem Host, eine zuordenbare Historie und Drift-Erkennung, die gewünscht mit angewendet vergleicht.
Auf diesem Modell ist LinkMesh aufgebaut: Git-basierte Konfiguration, ein Commit-and-Publish-Workflow, Versionshistorie per Klick und Drift-Erkennung über das gesamte Fleet. Stellen Sie eine Pipeline zusammen, committen und publishen Sie sie – und wissen Sie nachweisbar, was jeder Collector ausführt. Richten Sie selbst eine ein unter linkmesh.io/install.