
 LinkMeshObservability Data Collection Management
OpAMP erklärt
OpenTelemetry-Collector-Flotten fernverwalten.
 Roman Hüsler← Zurück zum Blog
Einen OpenTelemetry Collector zu betreiben ist einfach. Fünfzig zu betreiben ist eine andere Aufgabe. Jeder einzelne ist ein Prozess auf einem Host mit eigener Config-Datei, eigener Version und einer eigenen Art, still aus der Reihe zu tanzen — und standardmässig haben Sie keine zentrale Möglichkeit, das zu sehen, geschweige denn zu ändern. OpAMP ist der offene Standard, der genau diese Lücke schliessen soll.
Dieser Leitfaden erklärt, was OpAMP ist, wie das Protokoll tatsächlich funktioniert, welche Deployment-Modelle Sie wählen können (und welches heute praktikabel ist) und — ebenso wichtig — was OpAMP bewusst Ihnen zum Daraufaufbauen überlässt.
Das Flottenproblem: 50 Collectors, 50 Config-Dateien, null Sichtbarkeit
Der OpenTelemetry Collector ist ein grossartiger Baustein pro Host. Aber genau diese Stärke pro Host wird zum Flottenproblem, sobald Sie mehr als eine Handvoll betreiben:
- Kein Inventar. Welche Collectors laufen tatsächlich? Auf welcher Version ist jeder?
- Keine zentrale Config. Eine Pipeline zu ändern heisst, eine Datei auf jedem Host zu bearbeiten — via Ansible, ein Playbook oder SSH — und zu hoffen, dass jeder Node konvergiert ist.
- Stille Drift. Ein Host, der ein Update verpasst hat oder während eines Incidents von Hand bearbeitet wurde, läuft einfach still mit der falschen Config, bis keine Daten mehr ankommen.
Meist merken Sie erst, dass etwas nicht stimmt, wenn Telemetrie fehlt. Was Sie wollen, ist das Gegenteil: eine Stelle, die den Status jedes Collectors sieht und Config sicher an alle verteilt. Genau dieses Problem standardisiert OpAMP.
Was OpAMP ist: Status hoch, Config runter
OpAMP — das Open Agent Management Protocol — ist eine offene Spezifikation (unter dem OpenTelemetry-Projekt) zur Fernverwaltung einer Flotte von Agents. “Agent” meint meist einen OTel Collector, aber OpAMP ist agnostisch gegenüber dem Agent-Typ. Es definiert ein Client/Server-Protokoll mit zwei Flussrichtungen:
Hoch (Agent → Server): Jeder Agent meldet, wer er ist, seine Health, seine aktuell effektive Konfiguration und seine Telemetrie über sich selbst. Das verwandelt einen Haufen Hosts in ein lebendes Inventar.
Runter (Server → Agent): Der Server kann eine neue Remote-Konfiguration, aktualisierte Verbindungseinstellungen, Zertifikate und sogar neue Agent-Packages (Binary-/Version-Updates) verteilen. Das verwandelt “fünfzig Dateien bearbeiten” in “einmal zentral ändern”.
Unter der Haube läuft das über eine dauerhafte Verbindung (WebSocket oder einfaches HTTP), per TLS gesichert, wobei sich der Agent gegenüber dem Server authentifiziert — die Verbindung ist also kontinuierlich, kein einmaliger Push. Weil der Agent seine effektive Config zurückmeldet, kann der Server vergleichen, was er angefordert hat, mit dem, was tatsächlich läuft — die Grundlage für Drift-Erkennung. Genau dieser Round-Trip ist der Sinn der Sache: die Flotte von einer Stelle aus verwalten und wissen, dass es funktioniert hat.
Warum nicht einfach Ansible oder Puppet nutzen? Sie können eine Collector-Config mit generischem Config-Management verteilen — viele Teams tun das. Aber diese Tools sind fire-and-forget: Sie bringen eine Datei in den Sollzustand und ziehen weiter. Sie geben Ihnen keine lebende Rückverbindung, also gibt es kein kontinuierliches Health-Signal, keine Meldung, welche Config auf jedem Host tatsächlich effektiv ist, und keinen standardisierten Weg, ein Binary-Update auszuliefern oder ein Zertifikat zu rotieren. OpAMP ist eigens für den Agent-Management-Loop gebaut — dauerhafte Verbindung, Health-Heartbeat, Effective-Config-Report — und genau das macht Echtzeit-Flottensichtbarkeit und Drift-Erkennung überhaupt erst möglich.
Drei Deployment-Modelle — und das, was heute praktikabel ist
OpAMP ist ein Protokoll, also muss etwas auf dem Host es sprechen. Es gibt drei Ausprägungen, und der Unterschied ist in der Praxis erheblich.
1. Integrierter Client (die opampextension). Der Collector bringt eine OpAMP-Extension
mit, die sich direkt mit dem Server verbindet. Das ist am einfachsten zu deployen — kein
zusätzlicher Prozess. Der wichtige Vorbehalt: Für sich allein meldet die Extension Status
und empfängt Config-Nachrichten, aber sie startet oder reloadet den Collector nicht, um
eine neue Remote-Pipeline anzuwenden. Der “integrierte Client” gibt Ihnen heute also
Sichtbarkeit und teilweise Verwaltung, nicht die volle Anwendung der Remote-Config.
2. Supervisor (der opampsupervisor). Ein kleiner separater Prozess ist der
OpAMP-Client; er betreibt den Collector als Kindprozess. Wenn der Server neue Config
verteilt, schreibt der Supervisor sie auf die Platte und startet (oder reloadet) den
Collector, um sie anzuwenden — und meldet dann die neue effektive Config zurück nach oben.
Das ist das Modell, das heute tatsächlich Remote-Konfigurationsmanagement liefert, weshalb
es der praktische Default für eine echte Flotte ist.
3. Gateway / hierarchisch. In grösseren Topologien betreiben Sie eine Gateway-Ebene von Collectors, an die Edge-Agents weiterleiten. Die Gateway-Collectors sind selbst OpAMP-verwaltete Agents; das ist eine Topologie-Entscheidung, die auf die obigen Client-Modelle aufsetzt, keine andere Art, das Protokoll zu sprechen.
Die Kernaussage: Wenn Sie Config verteilen und angewendet haben wollen, ist der Supervisor das Modell, auf dem Sie heute aufbauen. Der Extension-only-Pfad wird besser, aber anzunehmen, er beherrsche bereits die volle Anwendung der Remote-Config, ist der häufigste OpAMP-Fehler.
Was OpAMP Ihnen nicht gibt
Hier stolpern viele: OpAMP ist ein Protokoll, kein Produkt. Es standardisiert die Leitung — wie ein Agent und ein Server miteinander reden. Es liefert Ihnen nicht den Server und lässt bewusst alles oberhalb der Leitung weg:
- Kein UI. OpAMP transportiert Config als opake Bytes; es hat keine Meinung dazu, wie Sie die Flotte ansehen oder verwalten.
- Kein Config-Authoring oder Validierung. Eine gültige Collector-Pipeline zu komponieren — Receiver, Processor, Exporter — und sie vor dem Ausliefern zu prüfen, ist Ihre Aufgabe.
- Kein Drift-Diffing oder Rollback-UX. Das Protokoll meldet die effektive Config; daraus ein lesbares “dieser Host ist gedriftet, hier ist das Diff, roll es zurück” zu machen, ist eine Produktfrage.
- Kein RBAC, Audit oder Versionierung. Wer was wann geändert hat und wer es darf — alles oberhalb der Protokollgrenze.
Mit anderen Worten: OpAMP gibt Ihnen den Transport für Flottenmanagement. Die Control Plane — das UI, das Config-Authoring, die Validierung, die Drift-Ansicht, die Historie — ist der Teil, den Sie entweder bauen oder übernehmen.
Wie LinkMesh OpAMP implementiert
LinkMesh ist genau diese Control Plane. Es nutzt das Supervisor-basierte
Modell, damit Remote-Config auch tatsächlich angewendet wird: Richten Sie den
opampsupervisor eines Collectors mit einem Token auf LinkMesh aus, und der Collector
taucht in der Flotte auf. Anders gesagt: LinkMesh ist ein
selbst gehosteter OpAMP-Server mit den Flotten-Werkzeugen obendrauf.
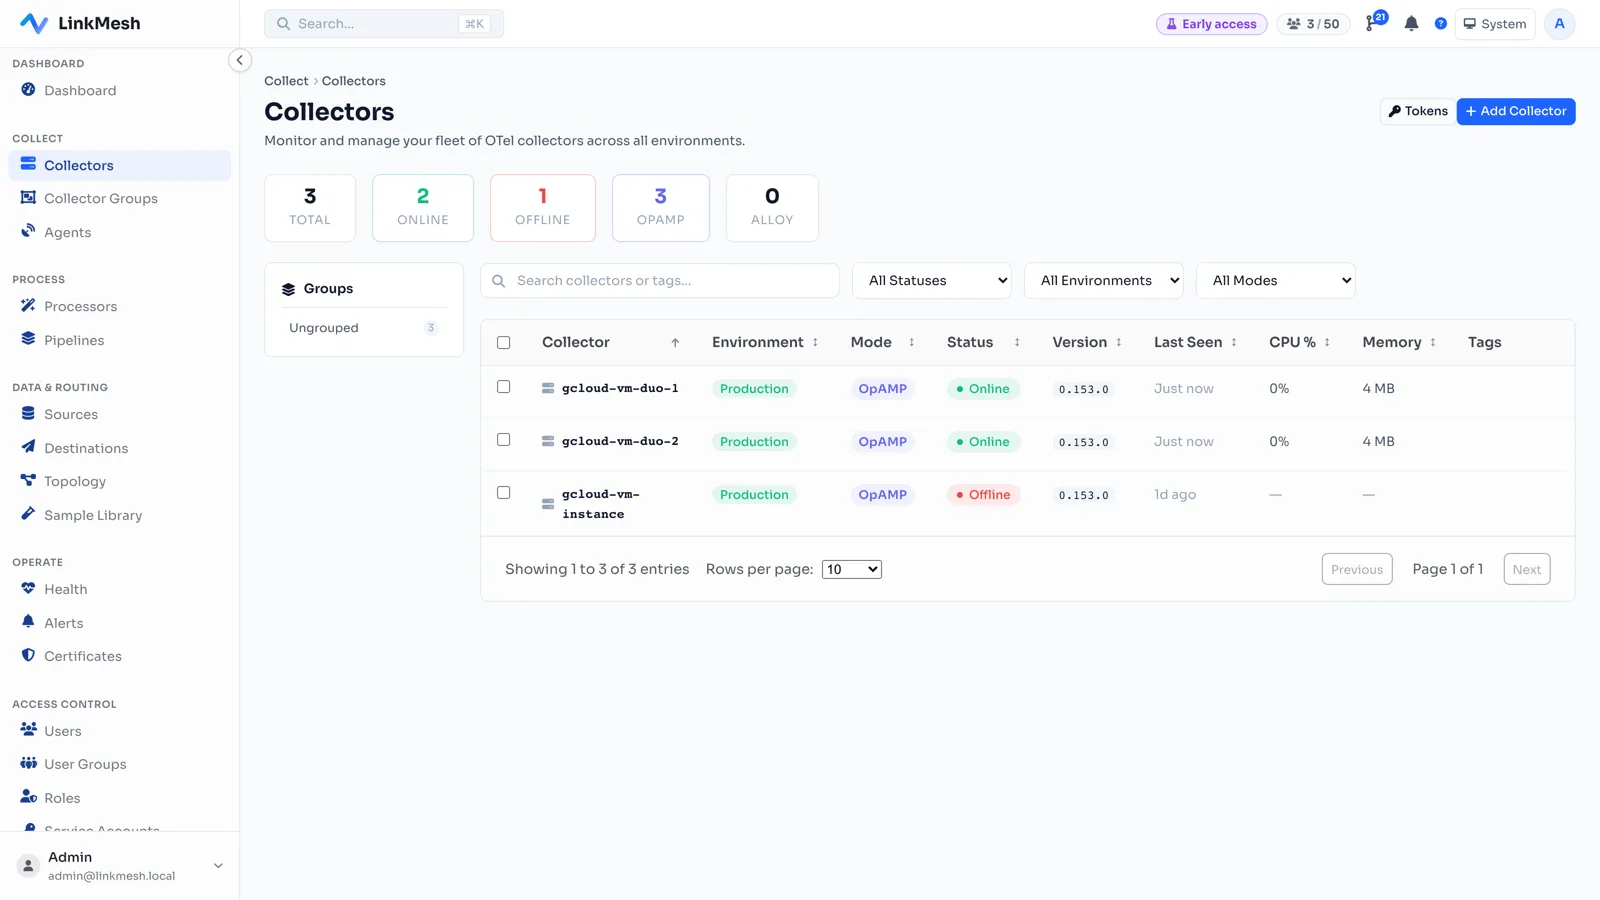
Von dort füllt LinkMesh genau die Lücken, die das Protokoll offenlässt:
- Config-Authoring + Validierung in einem visuellen Builder — Sie komponieren Sources, Processors, Routen und Destinations, und LinkMesh rendert und validiert die Collector-Config, bevor sie über OpAMP verteilt wird.
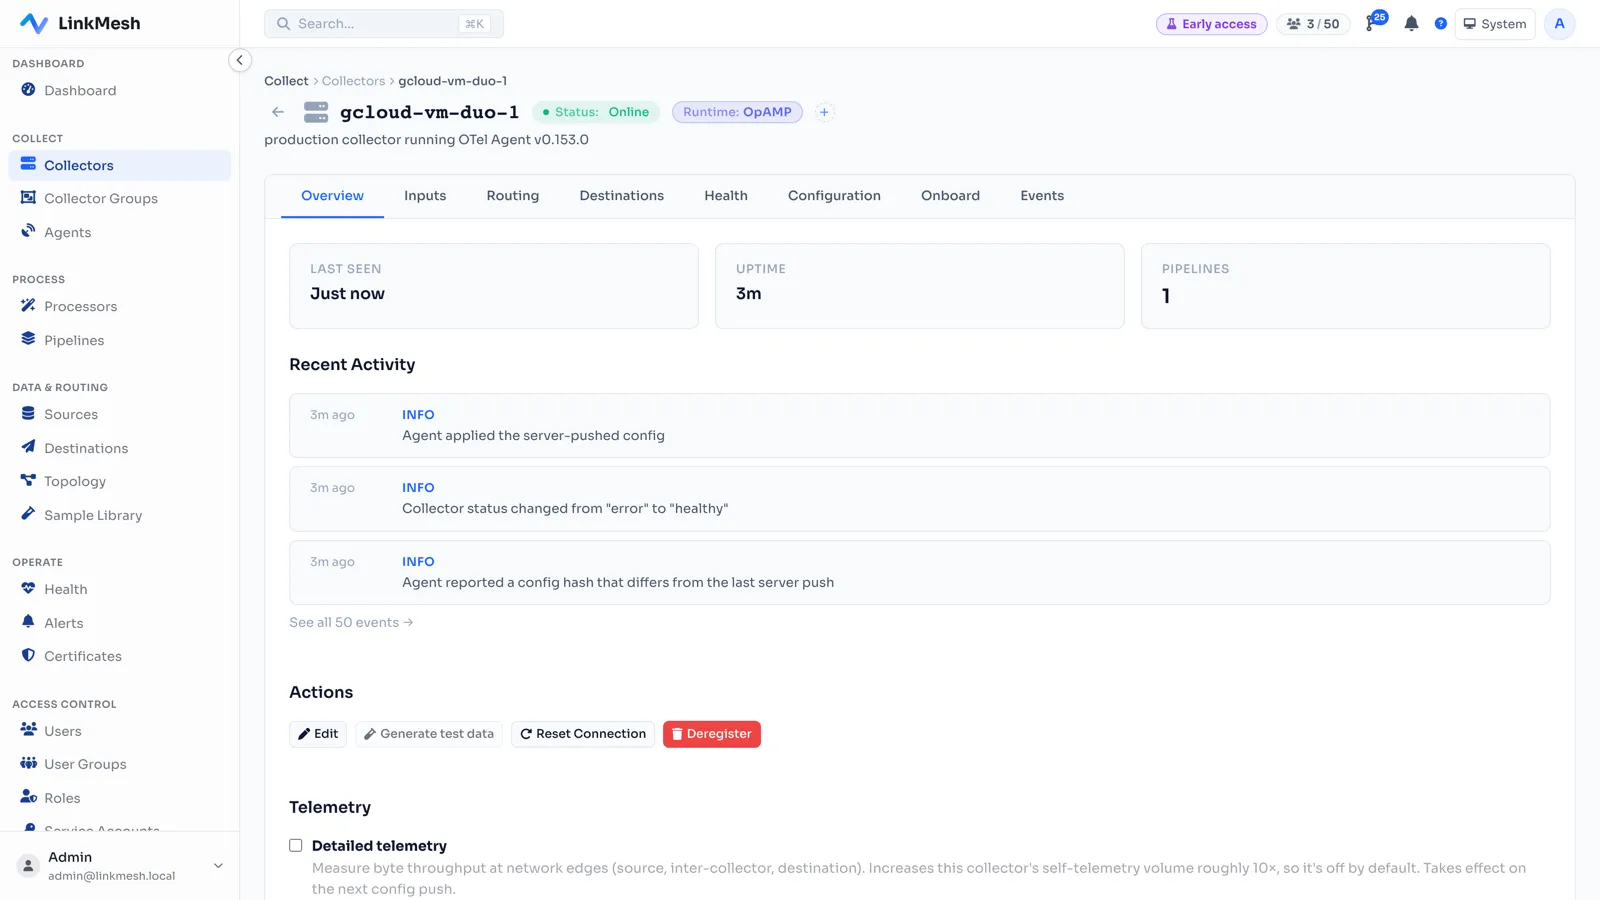
- Push- + Apply-Status — Sie sehen, wie eine Config auf jedem Host landet und wirksam wird, mit Apply-Historie pro Collector, statt zu hoffen, dass ein Playbook konvergiert ist.
- Health- + Effective-Config-Reporting speist eine lebende Flottenansicht, und der Vergleich der angeforderten Config mit der gemeldeten effektiven Config macht Drift sichtbar.
Ihre Telemetrie fliesst nie durch LinkMesh — nur der OpAMP-Management-Traffic (Status hoch, Config runter). Die Collectors bleiben auf Ihrer Infrastruktur; die Control Plane verwaltet sie lediglich.
Wenn OpAMP der Standard dafür ist, wie man eine OTel-Flotte verwaltet, dann ist eine Control Plane das, was diesen Standard in ein betreibbares Produkt verwandelt. Mehr dazu finden Sie auf der Features-Seite, die Konzepte hinter Pipelines in unserem Leitfaden zur Telemetrie-Pipeline, oder Sie stellen in wenigen Minuten eine auf und melden Ihren ersten Collector an unter linkmesh.io/install.