
 LinkMeshObservability Data Collection Management
Was ist eine Telemetrie-Pipeline?
Kosten, Routing & PII – und wie Sie selbst eine betreiben.
 Philippe Braxmeier← Zurück zum Blog
Wenn Sie mehr als ein paar Services betreiben, fliessen Ihre Logs, Metriken und Traces bereits irgendwohin – meist direkt von jedem Host zu welchem Observability-Anbieter auch immer, bei dem Sie sich angemeldet haben. Diese direkte Leitung funktioniert genau so lange, bis sie es nicht mehr tut: Die Rechnung steigt schneller als Ihr Traffic, sensible Felder landen im Index eines Dritten, und ein Backend-Wechsel bedeutet, jeden Agent anzufassen, den Sie besitzen.
Eine Telemetrie-Pipeline ist die Schicht, die alle drei Probleme auf einmal löst. Dieser Leitfaden erklärt, was eine Telemetrie-Pipeline tatsächlich ist, welche Probleme sie löst, aus welchen Teilen sie besteht und welche Optionen es gibt, selbst eine zu betreiben.
- Eine Telemetrie-Pipeline ist die Schicht zwischen den Systemen, die Logs, Metriken und Traces erzeugen, und den Backends, die sie speichern. Sie filtert, sampelt, maskiert und routet Telemetrie, bevor sie Ihr Netzwerk verlässt.
- Sie läuft in Ihren Collectors. Eine Control Plane konfiguriert diese Collectors und ist nicht dasselbe wie die Pipeline.
- Wenn Sie Telemetrie-Pipeline-Tools vergleichen, zählen drei Fragen: Wo werden die Daten verarbeitet, womit skaliert die Rechnung, und wie erreichen Config-Änderungen die Flotte?
Was ist eine Telemetrie-Pipeline?
Eine Telemetrie-Pipeline ist die Verarbeitungsschicht, die zwischen den Systemen sitzt, die Telemetrie produzieren, und den Backends, die sie speichern und analysieren. Statt dass jede Anwendung ihre Logs, Metriken und Traces direkt an einen Anbieter schickt, fliessen die Daten zuerst durch eine Pipeline, die Sie steuern – wo sie gefiltert, umgeformt, angereichert, maskiert und geroutet werden können, bevor sie überhaupt Ihr Netzwerk verlassen.
Sie werden sie auch Observability-Pipeline oder Telemetrie-Daten-Pipeline genannt sehen. Die Namen sind austauschbar; die Idee ist dieselbe. Es ist derselbe architektonische Schritt, den Datenbanken vor Jahrzehnten machten: eine Schicht in die Mitte legen, sodass Produzenten und Konsumenten nichts voneinander wissen müssen und Sie einen Ort haben, an dem Sie Policy durchsetzen.
Das Schlüsselwort ist Kontrolle. Ohne Pipeline werden Form, Volumen und Ziel Ihrer Telemetrie am Rand entschieden, durch das, was jeder Service zufällig emittiert. Mit einer wandern diese Entscheidungen an einen einzigen, versionierten Ort.
Telemetrie-Pipeline vs. Collector vs. Control Plane
Diese drei Begriffe werden oft synonym verwendet. Sie bezeichnen verschiedene Dinge, und der Unterschied entscheidet, wohin Ihre Daten fliessen.
- Die Pipeline ist die Logik: welche Telemetrie hereinkommt, was mit ihr passiert und wohin sie geht. Empfangen, verarbeiten, exportieren.
- Der Collector ist die Laufzeit, die diese Logik ausführt: ein Prozess auf einem Host, ein Sidecar oder ein Gateway. Der OpenTelemetry Collector und Grafana Alloy sind die verbreiteten. Eine Flotte von Collectors, von denen jeder seinen Teil der Pipeline ausführt, ist das, was eine Telemetrie-Pipeline physisch ist.
- Die Control Plane ist die Management-Schicht über den Collectors. Sie erstellt und versioniert die Pipeline-Config, weist sie den richtigen Collectors zu und meldet zurück, welche gesund sind und auf welcher Version laufen.
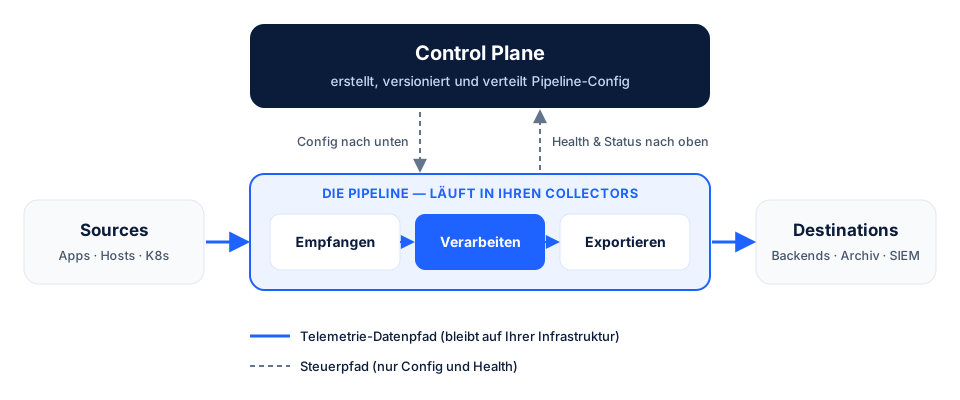
Die Trennung ist aus einem praktischen Grund wichtig. Telemetrie muss nur den Datenpfad durchlaufen: Sources, Collectors, Destinations. Der Steuerpfad trägt Config und Health, sonst nichts. Ein Design, das beide auseinanderhält, kann das Management zentralisieren, ohne Ihre Daten zu zentralisieren. Darauf kommen wir unten zurück, wenn wir die Wege vergleichen, eine Pipeline zu betreiben.
Welche Probleme löst eine Telemetrie-Pipeline?
Vier wiederkehrende Probleme treiben Teams zu einer Pipeline:
- Kostenkontrolle. Observability-Anbieter rechnen nach Ingest-Volumen ab, und das meiste davon ist Rauschen – Debug-Logs, Health-Check-Spans, hochkardinale Metriken, die niemand abfragt. Eine Pipeline lässt Sie dieses Rauschen verwerfen, samplen und aggregieren, bevor es ein pro-Gigabyte-Backend erreicht, sodass Sie dafür zahlen, Signal zu speichern, nicht Geplapper.
- Anbieter-Lock-in. Wenn jeder Agent direkt auf einen Anbieter zeigt, ist eine Migration ein flottenweites Umschreiben. Eine Pipeline entkoppelt Produzenten von Zielen: Ändern Sie eine Routing-Regel, und dieselbe Telemetrie geht anderswohin, ohne dass auf den Hosts etwas anzufassen ist.
- Routing zu mehreren Zielen. Reale Umgebungen sind selten Ein-Backend. Sie wollen vielleicht Traces in einem Tool, Logs aufgeteilt zwischen einem günstigen Archiv und einem heissen Index und eine Kopie sicherheitsrelevanter Ereignisse an ein SIEM weitergeleitet. Eine Pipeline fächert einen einzigen Stream per Regel an viele Ziele auf.
- PII und Compliance. Logs leaken Geheimnisse – E-Mails, Tokens, Kartennummern, IPs. Wenn Telemetrie direkt vom Host abgeht, sind diese Daten bereits weg. Eine Pipeline gibt Ihnen einen Kontrollpunkt auf Ihrer eigenen Infrastruktur, um sensible Felder zu maskieren oder zu verwerfen, bevor irgendetwas die Netzwerkgrenze überquert.
Wenn irgendetwas davon vertraut klingt, haben Sie bereits einen Nutzen für eine Telemetrie-Pipeline – ob Sie sie nun schon so genannt haben oder nicht.
Die Anatomie einer Telemetrie-Pipeline
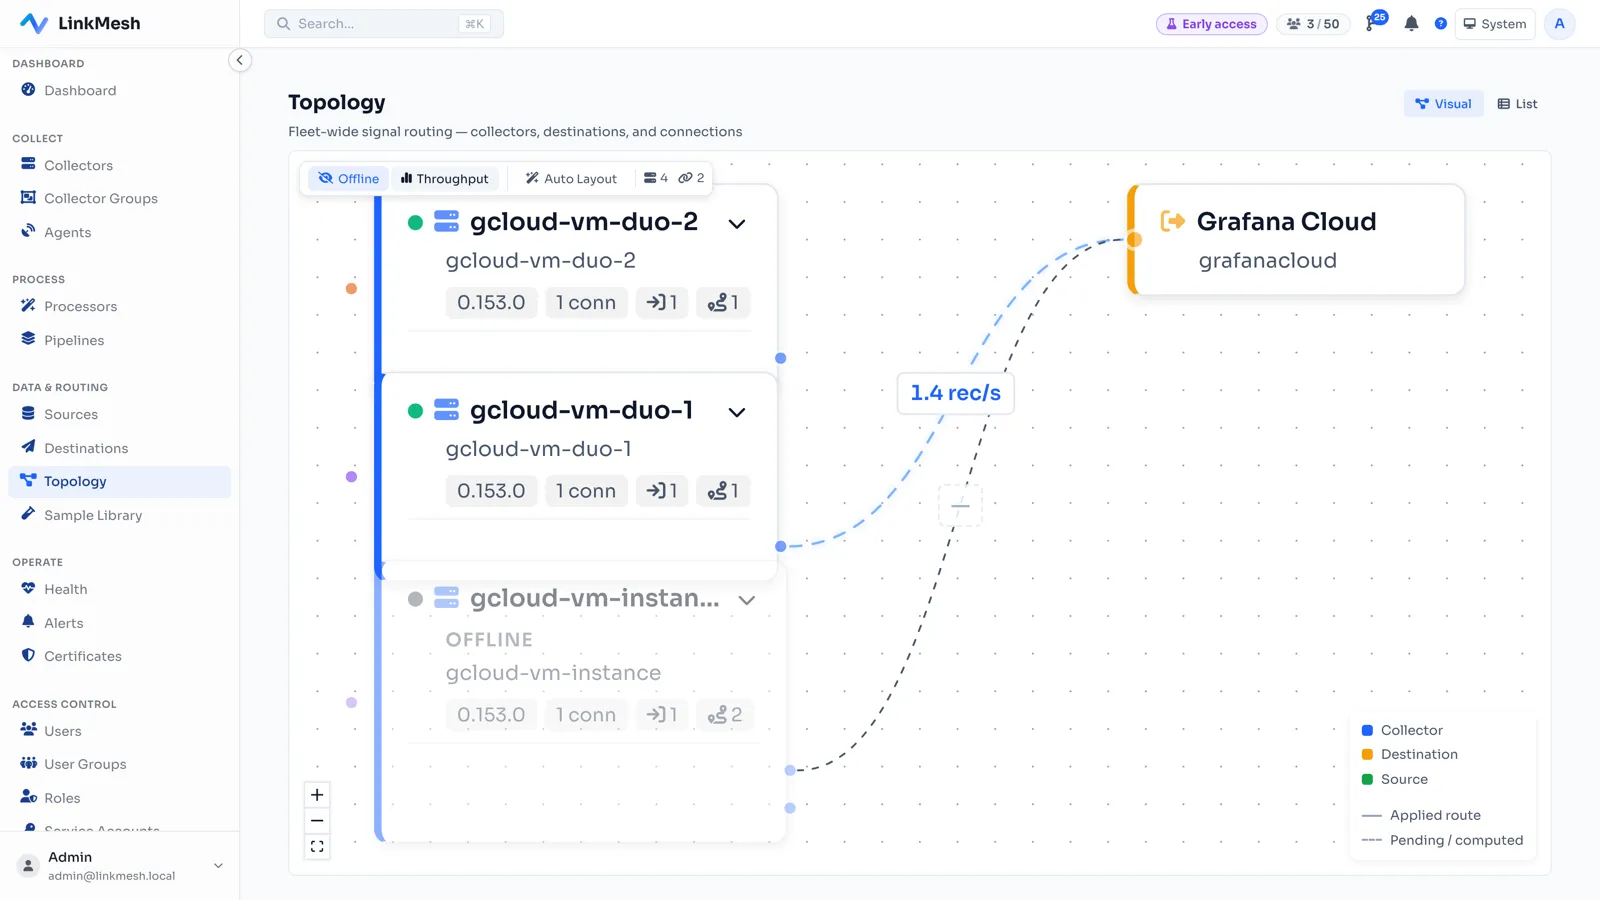
Jede Telemetrie-Pipeline, unabhängig vom Anbieter, ist aus denselben vier Stufen aufgebaut. Daten fliessen von links nach rechts:
Sources sind alles, was Telemetrie produziert: Anwendungs-SDKs, Host-Agents, Kubernetes-Workloads, Netzwerkgeräte, Cloud-Logs. In einer OpenTelemetry-nativen Pipeline emittieren diese über OTLP, das anbieterneutrale Wire-Format, wobei eine gute Pipeline auch Legacy-Formate wie syslog, Prometheus und einfache Logdateien aufnimmt.
Collectors empfangen diese Telemetrie und halten sie kurz – batchen, puffern gegen Backpressure und wiederholen bei Fehlern, sodass ein kurzzeitiger Backend-Ausfall keine Daten verwirft. Der OpenTelemetry Collector und Grafana Alloy sind die zwei gängigen Optionen.
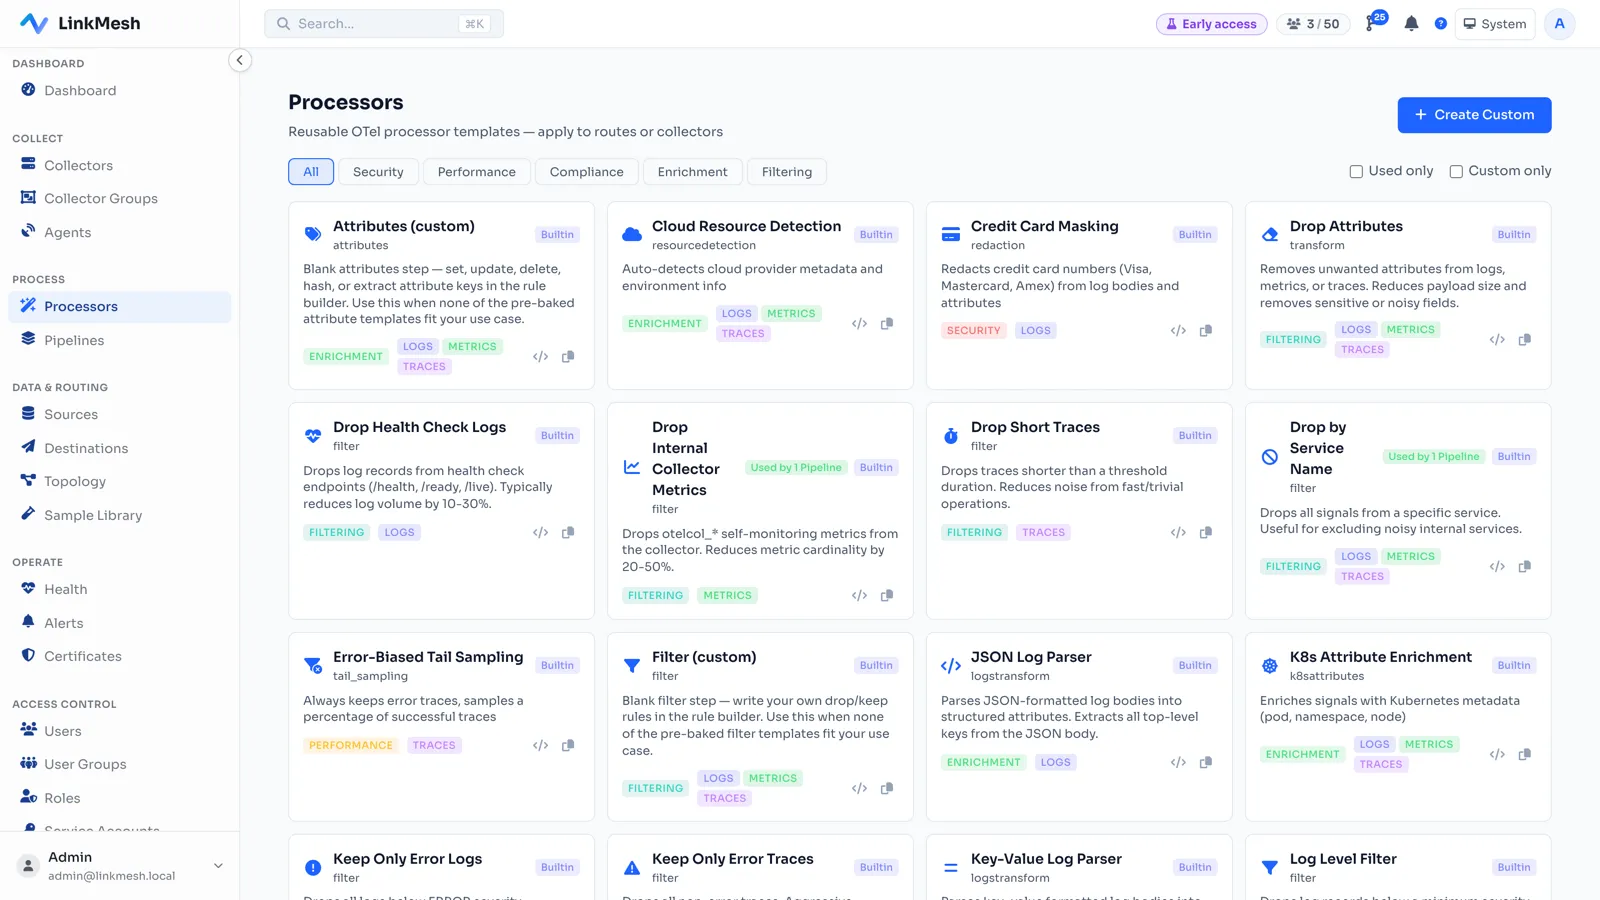
Processors sind der Ort, an dem sich die Pipeline ihr Geld verdient. Das ist die Stufe, die Rauschen herausfiltert, volumenstarke Traces sampelt, PII maskiert, Datensätze mit Metadaten (Umgebung, Team, Region) anreichert und Formate transformiert. Jede Kosten- und Compliance-Entscheidung lebt hier.
Destinations sind die Backends, in denen die verfeinerte Telemetrie landet: Grafana Cloud, Loki, Datadog, ein Object-Store für günstige Archivierung, ein SIEM für Sicherheitsereignisse. Eine Pipeline schreibt üblicherweise in mehrere und wählt pro Ziel, was jedes empfängt — die Mechanik hinter dieser Wahl ist Routing nach Attribut, ausführlich behandelt in Route Telemetry by Attribute (englisch).
Hier ist derselbe vierstufige Fluss als Live-Routing-Canvas – echte Collectors links, vermascht bis zu einem Ziel rechts, mit Durchsatz auf jeder Kante:
Die Processor-Stufe ist es wert, für sich betrachtet zu werden, denn dort wird der Rauschen-gegen-Signal-Kompromiss tatsächlich getroffen:
Worauf Sie bei Telemetrie-Pipeline-Tools achten sollten
Welches Produkt oder Projekt Sie auch evaluieren: Dieselbe Handvoll Fragen trennt eine Pipeline, die Sie jahrelang betreiben können, von einer, von der Sie in achtzehn Monaten wieder migrieren:
- Wo werden die Daten verarbeitet? Auf Ihrer eigenen Infrastruktur, oder durchläuft die Telemetrie zum Filtern die Cloud eines Anbieters? Wenn die Pipeline PII maskieren soll, bevor Daten Ihr Netzwerk verlassen, muss die Verarbeitung vorher stattfinden.
- Womit skaliert die Rechnung? Bei Pro-Gigabyte-Preisen für die Pipeline selbst wird jedes Byte, das Sie verwerfen, trotzdem einmal berechnet. Preise pro Node oder pro Collector bestrafen Sie nicht dafür, dass Sie Volumen reduzieren.
- Ist sie OpenTelemetry-nativ, eingangs wie ausgangs? OTLP auf beiden Seiten hält Sources und Backends austauschbar. Ein proprietärer Agent oder ein eigenes Wire-Format schafft den Lock-in neu, den die Pipeline beseitigen sollte.
- Wie erreichen Config-Änderungen die Flotte? Achten Sie auf versionierte Config, einen gestaffelten Rollout und einen Rollback in einem Schritt, dazu eine Sicht darauf, welcher Collector welche Version ausführt. YAML pro Host von Hand zu pflegen skaliert nicht über eine Handvoll Collectors hinaus.
- Sehen Sie, was ein Processor tun wird, bevor er ausgerollt wird? Eine Filter- oder Maskierungsregel, die gegen echte Records getestet wird, findet die Regel, die die falschen Daten verwirft, bevor sie das überall tut.
- Können Sie nach Attribut an mehrere Destinations routen? Traces in ein Backend, Logs aufgeteilt zwischen einem schnellen Index und einem günstigen Archiv, Security-Events in ein SIEM, alles aus einem Stream.
Nichts davon ist exotisch. Zusammen machen diese Punkte den Unterschied zwischen einer Pipeline und einer zweiten Kopie des Problems, das sie lösen sollte.
Build vs. SaaS vs. selbst gehostete Control Plane
Sobald Sie sich für eine Telemetrie-Pipeline entschieden haben, gibt es drei Wege, an eine zu kommen.
Selbst bauen. Sie können eine Pipeline aus rohen OpenTelemetry Collectors und Config-Dateien von Hand zusammenbasteln. Es ist kostenlos und vollständig unter Ihrer Kontrolle, aber jeder Collector wird zu einer Insel: eigene Config, eigene Version, eigene Art, aus der Reihe zu driften. Mehr als eine Handvoll von Hand zu verwalten – die Frage „welche Collectors laufen auf der Config der letzten Woche?“ zu beantworten – wird zu einer eigenen Betriebslast.
Eine SaaS-Pipeline kaufen. Verwaltete Observability-Pipeline-Anbieter übernehmen die Control Plane für Sie, aber Ihre Telemetrie fliesst meist durch ihre Infrastruktur, um verarbeitet zu werden. Für Daten, die PII tragen, ist das genau das Problem, das Sie zu vermeiden versuchten – plus eine Bepreisung, die oft mit dem Volumen skaliert, das Sie zu reduzieren versuchen.
Eine selbst gehostete Control Plane betreiben. Der Mittelweg: eine Control Plane, die Sie selbst hosten und die Ihre Collector-Flotte von einem Ort aus verwaltet – Config pushen, Health berichten und Durchsatz zeigen – während die Telemetrie selbst nie Ihr Netzwerk verlässt. Sie bekommen das zentrale Management von SaaS, ohne Ihre Daten (oder eine offene Rechnung) an einen Dritten zu geben.
Was richtig ist, hängt von Skala und Datensensibilität ab. Eine Drei-Collector-Einrichtung mag von Hand gebaut in Ordnung sein; eine regulierte Flotte aus Hunderten ist es meist nicht.
Wo LinkMesh hineinpasst
LinkMesh ist genau dafür eine selbst gehostete Control Plane. Sie richten einen beliebigen Collector – otelcol-contrib über OpAMP oder Grafana Alloy über remotecfg – mit einem Config-Block und einem Token auf LinkMesh aus. Von dort komponieren Sie Sources, Processors, Routen und Destinations einmal in der UI, und LinkMesh rendert die Collector-Config, validiert sie und pusht sie an die richtigen Collectors. Ihre Telemetrie bleibt die ganze Zeit auf Ihrer eigenen Infrastruktur; nur Config- und Health-Metriken fliessen zur Control Plane.
Das bedeutet, Sie bekommen die vier obigen Stufen als Dinge, die Sie editieren, nicht als YAML, das Sie pro Host von Hand pflegen – mit Pro-Kante-Durchsatz, sodass Sie sehen, wo Volumen eintritt und wo eine Route es abwirft, bevor die Rechnung es Ihnen sagt. Die Bepreisung ist pro verwaltetem Collector, nicht pro Gigabyte, sodass es Sie kein Geld kostet, Ihre Daten herunterzuformen.
Wenn Sie die Konzepte tiefer möchten, führt die Features-Seite durch das, was die Control Plane tut, und Sie können in ein paar Minuten eine aufsetzen und Ihren ersten Collector enrollen von linkmesh.io/install.
Weiterlesen
Jede Stufe einer Telemetrie-Pipeline hat auf diesem Blog ihren eigenen Leitfaden:
- Warum es die Schicht überhaupt gibt: Die fehlende Schicht der Observability
- Routing: Telemetrie nach Attribut routen
- Kosten und Volumen: Observability-Kosten beginnen am Edge und Tail Sampling und Sampling-Governance
- Die Collector-Flotte verwalten: OpenTelemetry Collector Fleet Management und OpAMP erklärt
- Wenn Daten fehlen: Telemetrie-Pipelines mit Live-Datenerfassung debuggen