
 LinkMeshObservability Data Collection Management
Telemetrie-Pipelines debuggen
Wenn der Collector läuft, aber keine Daten ankommen.
 Roman Hüsler← Zurück zum Blog
Es gibt eine besondere Art von Frust in der Telemetrie-Arbeit: Der Collector läuft, sein Prozess ist gesund, er meldet keine Errors — und trotzdem taucht nichts in Ihrem Backend auf. Daten gehen an einem Ende hinein, am anderen kommt nichts heraus, und die Logs schweigen fröhlich darüber, warum. Dieser Beitrag ist ein praktischer Leitfaden zum Debuggen genau dieser Situation: die häufigen Fehlerarten, warum der traditionelle Ansatz mühsam ist und wie Live-Datenerfassung „keine Ahnung” in Minuten zu „gefunden” macht. (Neu im Thema? Beginnen Sie mit Was ist eine Telemetrie-Pipeline.)
Der Debugging-Blindspot
Das Schwierige am Pipeline-Debugging ist, dass ein Collector vollkommen gesund sein und trotzdem still Ihre Daten verwerfen kann. Er ist nicht abgestürzt, es gibt also keinen Stacktrace. Er wirft keine Errors, die Logs sind also leer. Die Daten werden einfach gefiltert, fehlgeleitet oder weiter unten abgelehnt, und nichts davon dringt zu Ihnen durch. Sie müssen raten, welche von einem Dutzend Stufen der Übeltäter ist — blind.
Klassische Fehlerarten
Die meisten „keine Daten kommen an”-Incidents laufen auf eine Handvoll üblicher Verdächtiger hinaus:
- Exporter-Auth. Der Exporter wird vom Backend abgelehnt — ein falscher API-Token oder fehlerhafte Credentials geben ein 401 zurück, und je nach Config kann der Collector still wiederholen, statt Alarm zu schlagen.
- Signaltyp-Mismatch. Eine Route oder Pipeline, die für das falsche Signal verdrahtet ist — Logs, wo Metriken erwartet werden, oder eine Single-Signal-Route, in eine Multi-Signal-Kette eingefügt —, kann einen ungültigen Graphen erzeugen, den der Collector nicht einmal startet, oder einen Pfad, der still nichts trägt.
- Stille Drops durch Filter. Eine Filter- oder Sampling-Regel, die etwas zu aggressiv ist, verwirft mehr als beabsichtigt. Alles „funktioniert”; die Daten verschwinden einfach still.
- Schema-Überraschungen. Ein Attribut hat nicht den Typ, den ein nachgelagerter Processor erwartet, oder ein Feld, das der Exporter benötigt, fehlt, und Records werden auf dem Weg hinaus verworfen.
Jeder dieser Fälle ist von aussen unsichtbar. Die Liste zu kennen hilft — aber Sie müssen immer noch herausfinden, welcher davon, auf welchem Host, an welcher Stufe.
Der alte Weg: Debug-Exporter und Log-Höhlenforschung
Der traditionelle Ansatz ist, sich per SSH auf einen Host zu verbinden, einen Debug-/Logging-Exporter zur Collector-Config hinzuzufügen, ihn neu zu starten und die Logs zu verfolgen, um zu sehen, was fliesst. Es funktioniert, ist aber langsam und umständlich: Sie bearbeiten die Produktions-Config, um sie zu beobachten, starten genau das Ding neu, das Sie debuggen (was zeitabhängige Probleme verschleiern kann), tun es pro Host und lesen rohe Dumps in einem Terminal — oft mit sensiblen Feldern im Klartext vor Augen. Bis Sie es eingerichtet haben, ist das flüchtige Problem vielleicht schon weg.
Live Capture: echte Records inspizieren, ohne den Host anzufassen
Ein besserer Ansatz ist, eine Route abzugreifen — eine Probe dessen zu kopieren, was an einem Punkt der Pipeline tatsächlich fliesst, und sie in der UI zu inspizieren, ohne Config zu bearbeiten oder irgendetwas neu zu starten. Genau das macht LinkMeshs Live-Datenerfassung: Sie wählen eine Route, erfassen eine kurze Probe echter Records und schauen sie sich direkt an.
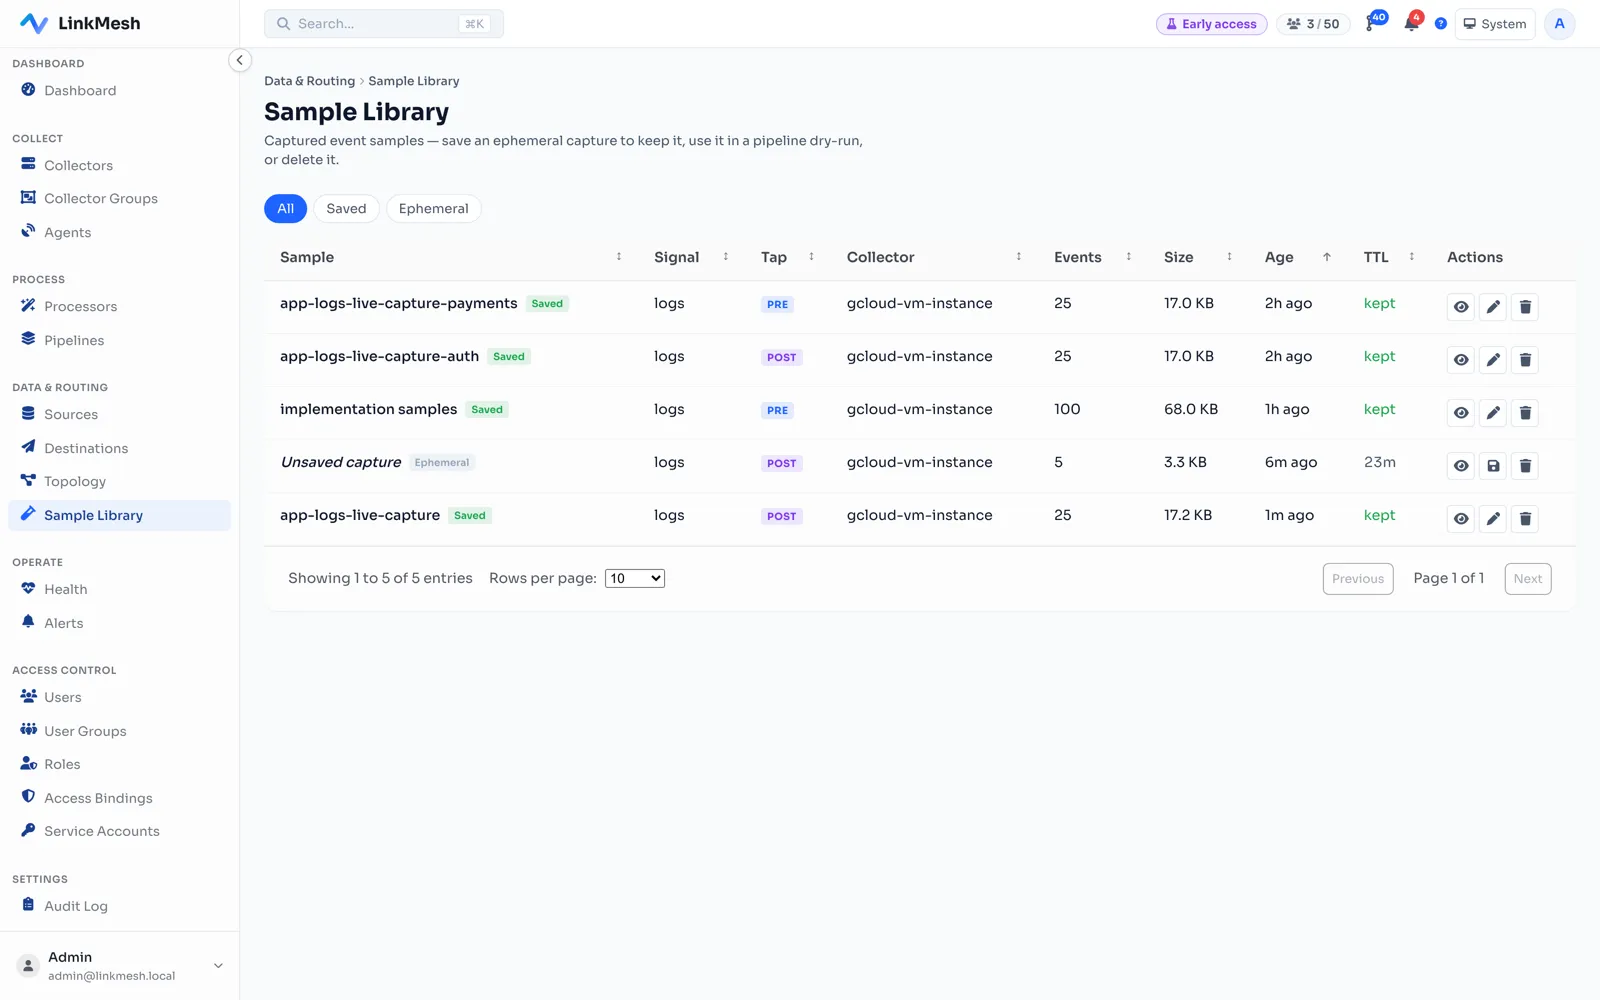
Drei Eigenschaften machen es sicher, es auf Produktions-Traffic anzuwenden:
- Redaction-safe. Die Erfassung läuft nach Ihren Redaction-Regeln, sensible Felder bleiben also maskiert — Sie können debuggen, ohne die PII wieder freizulegen, die Sie sorgfältig maskiert haben (siehe PII in Logs maskieren).
- Ephemer. Samples sind kurzlebig und gedeckelt, keine dauerhafte Kopie Ihrer Daten — sie existieren, um ein Problem zu debuggen, und laufen dann ab.
- Kein Restart. Sie beobachten die laufende Pipeline, statt sie zu bearbeiten und neu zu starten, stören also nicht das Ding, das Sie zu fassen versuchen.
Die tatsächlichen Records zu sehen beantwortet die Hälfte der Fragen sofort: Kommen die Daten an diesem Punkt überhaupt an? Haben sie die Felder, die Sie erwarten? Hat dieses Attribut den Typ, den Sie angenommen haben? Oft ist der Bug in dem Moment offensichtlich, in dem Sie einen echten Record sehen können.
Durchgehen: finden, welcher Processor Ihre Daten frisst
Die andere Hälfte des Debuggens ist, die genaue Stufe zu lokalisieren, an der Daten verschwinden. Statt zu raten, gehen Sie die Pipeline Processor für Processor durch und beobachten die Record-Zahl an jedem Schritt. Die Stufe, an der die Zahl auf null fällt, ist Ihr Übeltäter:
Records treten mit 100/s ein, überleben den Batch-Schritt mit 100/s und fallen direkt nach dem Filter auf 0/s — also ist der Filter der Übeltäter. Genau diese „vorher und nachher, einen Schritt nach dem anderen”-Ansicht gibt Ihnen LinkMeshs Processor-Vorschau. Öffnen Sie einen beliebigen Schritt in einer Pipeline und Sie bekommen drei Bereiche nebeneinander: die echten Records, die links hineingehen, die Konfiguration des Processors in der Mitte und das, was rechts herauskommt — gespeist von einem Dry-Run gegen ein Sample, sodass Sie es inspizieren können, ohne den laufenden Collector anzufassen.
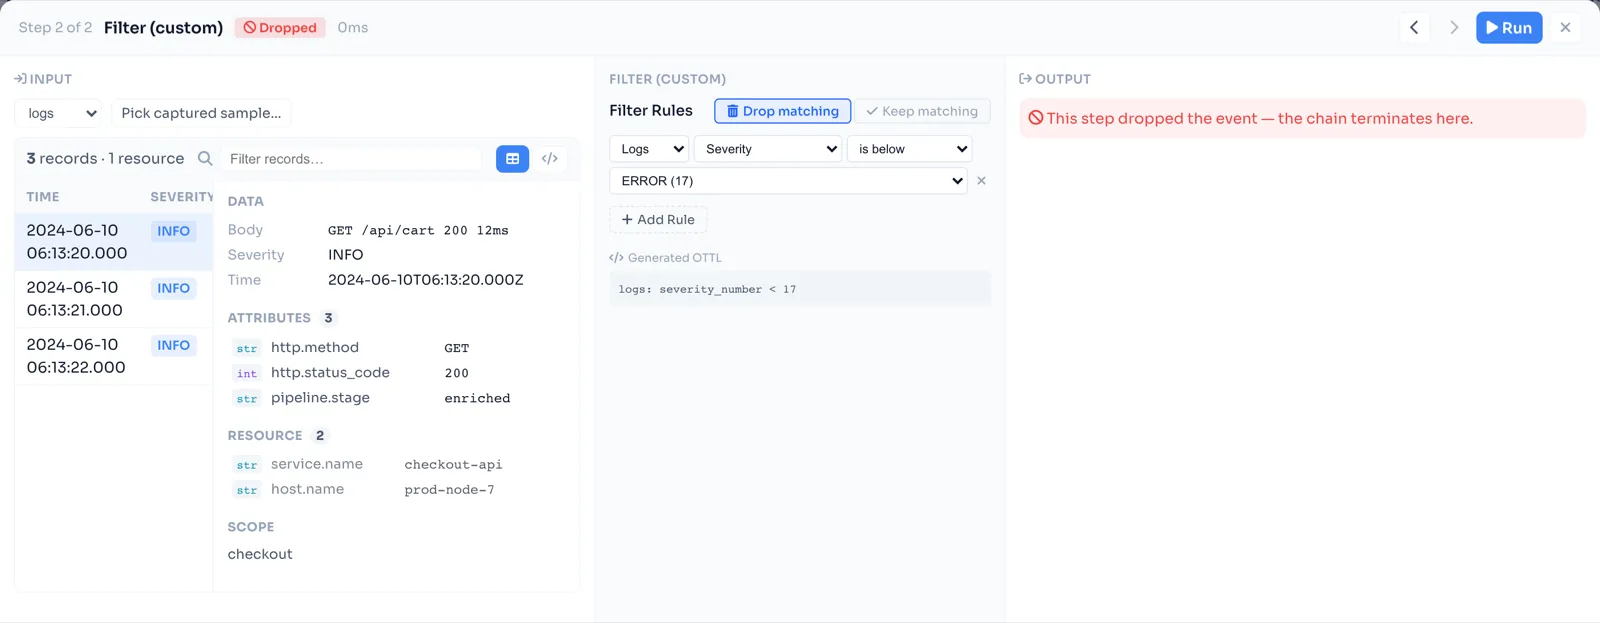
Hier erzählt sich die Geschichte von selbst. Drei Log-Records treten in den Schritt ein — Sie
können sie sehen, echt und intakt, bis hinunter zu ihren Attributen. Der mittlere Bereich
zeigt die Regel: matchende verwerfen — Severity ist unter ERROR. Und der Output ist leer,
markiert Dropped: „dieser Schritt hat das Event verworfen — die Kette endet hier.” Der
Filter sollte nur Errors behalten, aber jeder Record in diesem Stream ist INFO, also frisst
er still alle. Der Input-Bereich beweist, dass die Daten angekommen sind; der Output-Bereich
beweist, dass sie hier sterben; der mittlere Bereich zeigt genau warum — kein Raten, keine
Log-Höhlenforschung.
Von da an ist es mechanisch: Nutzen Sie die Vor-/Zurück-Pfeile, um die Kette Schritt für Schritt abzugehen, finden Sie den, an dem der Output leer wird, korrigiere seine Regel — hier, invertieren Sie die Bedingung oder entfernen Sie den Schritt — und lassen Sie dasselbe Sample erneut laufen, um zu bestätigen, dass die Records jetzt bis zum Ende überleben. Ein halber Tag Log-Höhlenforschung wird zu einem Blick.
Eine 10-Minuten-Pipeline-Triage
Wenn Daten nicht mehr ankommen, arbeiten Sie es in dieser Reihenfolge ab, statt zu raten:
- Ist es gesund? Bestätigen Sie, dass der Collector läuft und meldet — schliessen Sie „es ist einfach down” aus.
- An der Source erfassen. Greifen Sie die eingehende Route ab. Wenn nichts erfasst wird, liegt das Problem stromaufwärts (die Source oder der Sender), nicht in Ihrer Pipeline.
- Am Exporter erfassen. Wenn die Daten da sind, aber das Backend nicht erreichen, verdächtigen Sie Exporter-Auth oder das Ziel — prüfen Sie auf 401er.
- Die Mitte durchgehen. Wenn es eintritt, aber nicht austritt, gehen Sie Processor für Processor durch und finden Sie, wo die Zahl fällt.
- Einen echten Record inspizieren. Prüfen Sie Feldnamen und -typen gegen das, was die fehlschlagende Stufe erwartet — Schema-Mismatches verstecken sich hier.
Die meisten Incidents fallen in wenigen Minuten aus den Schritten 2–4 heraus, weil Sie die Daten anschauen, statt sie zu erschliessen. (Ihre Pipeline nach dem Funktionieren kostenoptimieren? Siehe Observability-Kosten senken.)
Das wiederkehrende Thema in diesem Blog gilt auch hier: Eine Pipeline, in die Sie hineinsehen können, ist eine Pipeline, die Sie betreiben können. LinkMesh erfasst echte Records pro Route, redaction-safe und ephemer, und geht durch Processors, sodass „keine Daten kommen an” zu einem Fünf-Minuten-Fix wird statt zu einem schlechten Nachmittag. Probieren Sie es aus unter linkmesh.io/install.