
 LinkMeshObservability Data Collection Management
Telemetrie nach Attribut routen
Die richtigen Daten ins richtige Backend.
 Roman Hüsler← Zurück zum Blog
Nicht jede Log-Zeile verdient dasselbe Backend. Logs der Stufe Error und die Traces hinter einem SLO gehören an einen Ort, der schnell und teuer abzufragen ist. Vollständige Access-Logs und Audit-Trails gehören an einen günstigen Ort, werden für die Compliance aufbewahrt und selten geöffnet. Debug-Rauschen aus einem gesprächigen Sidecar gehört nirgendwohin. Sich selbst überlassen, schicken die meisten Flotten trotzdem alles an ein Ziel — denn es von Hand aufzuteilen heisst, auf jedem Collector OTTL zu bearbeiten, die Kopien synchron zu halten und zu hoffen, dass niemand auf Host 14 einen Tippfehler in die Bedingung einbaut.
In diesem Beitrag geht es um attributbasiertes Routing von Telemetrie: auf das matchen, was tatsächlich im Datensatz steht — eine Severity, ein Namespace, ein Statuscode —, und verschiedene Treffer an verschiedene Orte schicken. Wir zeigen, wie der OpenTelemetry Collector das nativ macht, wie LinkMesh die Bedingung in etwas verwandelt, das Sie zusammenstellen statt von Hand schreiben, und eine zweite, leicht zu verwechselnde Mechanik — ein Ziel per Label an eine Route zu hängen, statt es von Hand zu verdrahten.
Was Routing nach Attribut tatsächlich bedeutet
Der routing-Connector des OpenTelemetry Collectors ist die OTel-native Mechanik: Ein
Receiver nimmt alles an, eine Tabelle von Bedingungen entscheidet, welche
nachgelagerte Pipeline jeder Datensatz nimmt, und was auf nichts passt, fällt in
einen Standardpfad. Denselben Connector haben wir für die Aufteilung nach Mandanten
in unserem Leitfaden zur mandantenfähigen
Collector-Architektur behandelt —
Routing nach Attribut ist derselbe Connector mit einer anderen Art von Bedingung:
nicht «welchem Mandanten gehört das», sondern «welches Ziel verdient der Inhalt
dieses Datensatzes».
connectors:
  routing:
    default_pipelines: [logs/fallthrough]
    table:
      - context: log
        condition: severity_number >= SEVERITY_NUMBER_ERROR
        pipelines: [logs/archive]

service:
  pipelines:
    logs/in:
      receivers: [otlp]
      exporters: [routing]
    logs/archive:
      receivers: [routing]
      exporters: [otlphttp/archive]
    logs/fallthrough:
      receivers: [routing]
      exporters: [otlphttp/default]
Das ist die ganze Mechanik: eine Bedingung, ein Ziel für Treffer, ein Auffangpfad für den Rest. Die Version, die LinkMesh erzeugt und an Ihre Flotte verteilt, ist reicher — mehr als eine Bedingung, der Reihe nach ausgewertet —, aber die Idee ist dieselbe: ein Strom hinein, Bedingungen in Prioritätsreihenfolge geprüft, ein Standard-Auffangpfad für alles, was auf nichts passt.
Schritt 1 — Routen werden nach Priorität ausgewertet, der erste Treffer gewinnt
Das ist der Punkt, den man sich richtig vorstellen muss, weil man ihn leicht überschätzt: Eine Routenliste ist keine deklarative Tabelle, in der jede Zeile geprüft wird und jeder Treffer auslöst. Sie ist eine priorisierte Kaskade — dasselbe Modell, das Cribl verwendet. Die Bedingung von Route 1 wird zuerst geprüft; passt sie, geht der Datensatz an das Ziel von Route 1, und die Auswertung endet. Passt sie nicht, wird Route 2 geprüft, dann Route 3 und so weiter, bis etwas passt oder der Datensatz in das fällt, was Sie als Standard festgelegt haben.
Diese Reihenfolge ist zugleich das Sicherheitsventil. Stellen Sie eine spezifische,
enge Bedingung an den Anfang (diesen einen lauten Namespace in einen Speicher
vergleichbar mit /dev/null routen) und einen breiten Auffangpfad ans Ende, und Sie
erhalten genau das erwartete Überschreibverhalten — ohne die Unklarheit «was passiert,
wenn zwei Zeilen passen», denn in einer Kaskade kommt immer nur die erste passende
zum Zug.
Schritt 2 — Den Filter bauen, ohne OTTL von Hand zu schreiben
Jede LinkMesh-Route trägt einen Filter, der unter der Haube zu OTTL kompiliert wird,
aber Sie beginnen nicht in einem Textfeld. Der Routen-Matcher ist eine Auswahl aus
Feld, Operator und Wert: Wählen Sie das Feld (ein Resource-Attribut, ein
Log-Attribut, die Severity, einen Statuscode …), einen Operator (gleich, enthält,
grösser als, existiert usw.) und einen Wert, und LinkMesh kompiliert das in dieselbe
Bedingungssyntax, die der routing-Connector auswertet.
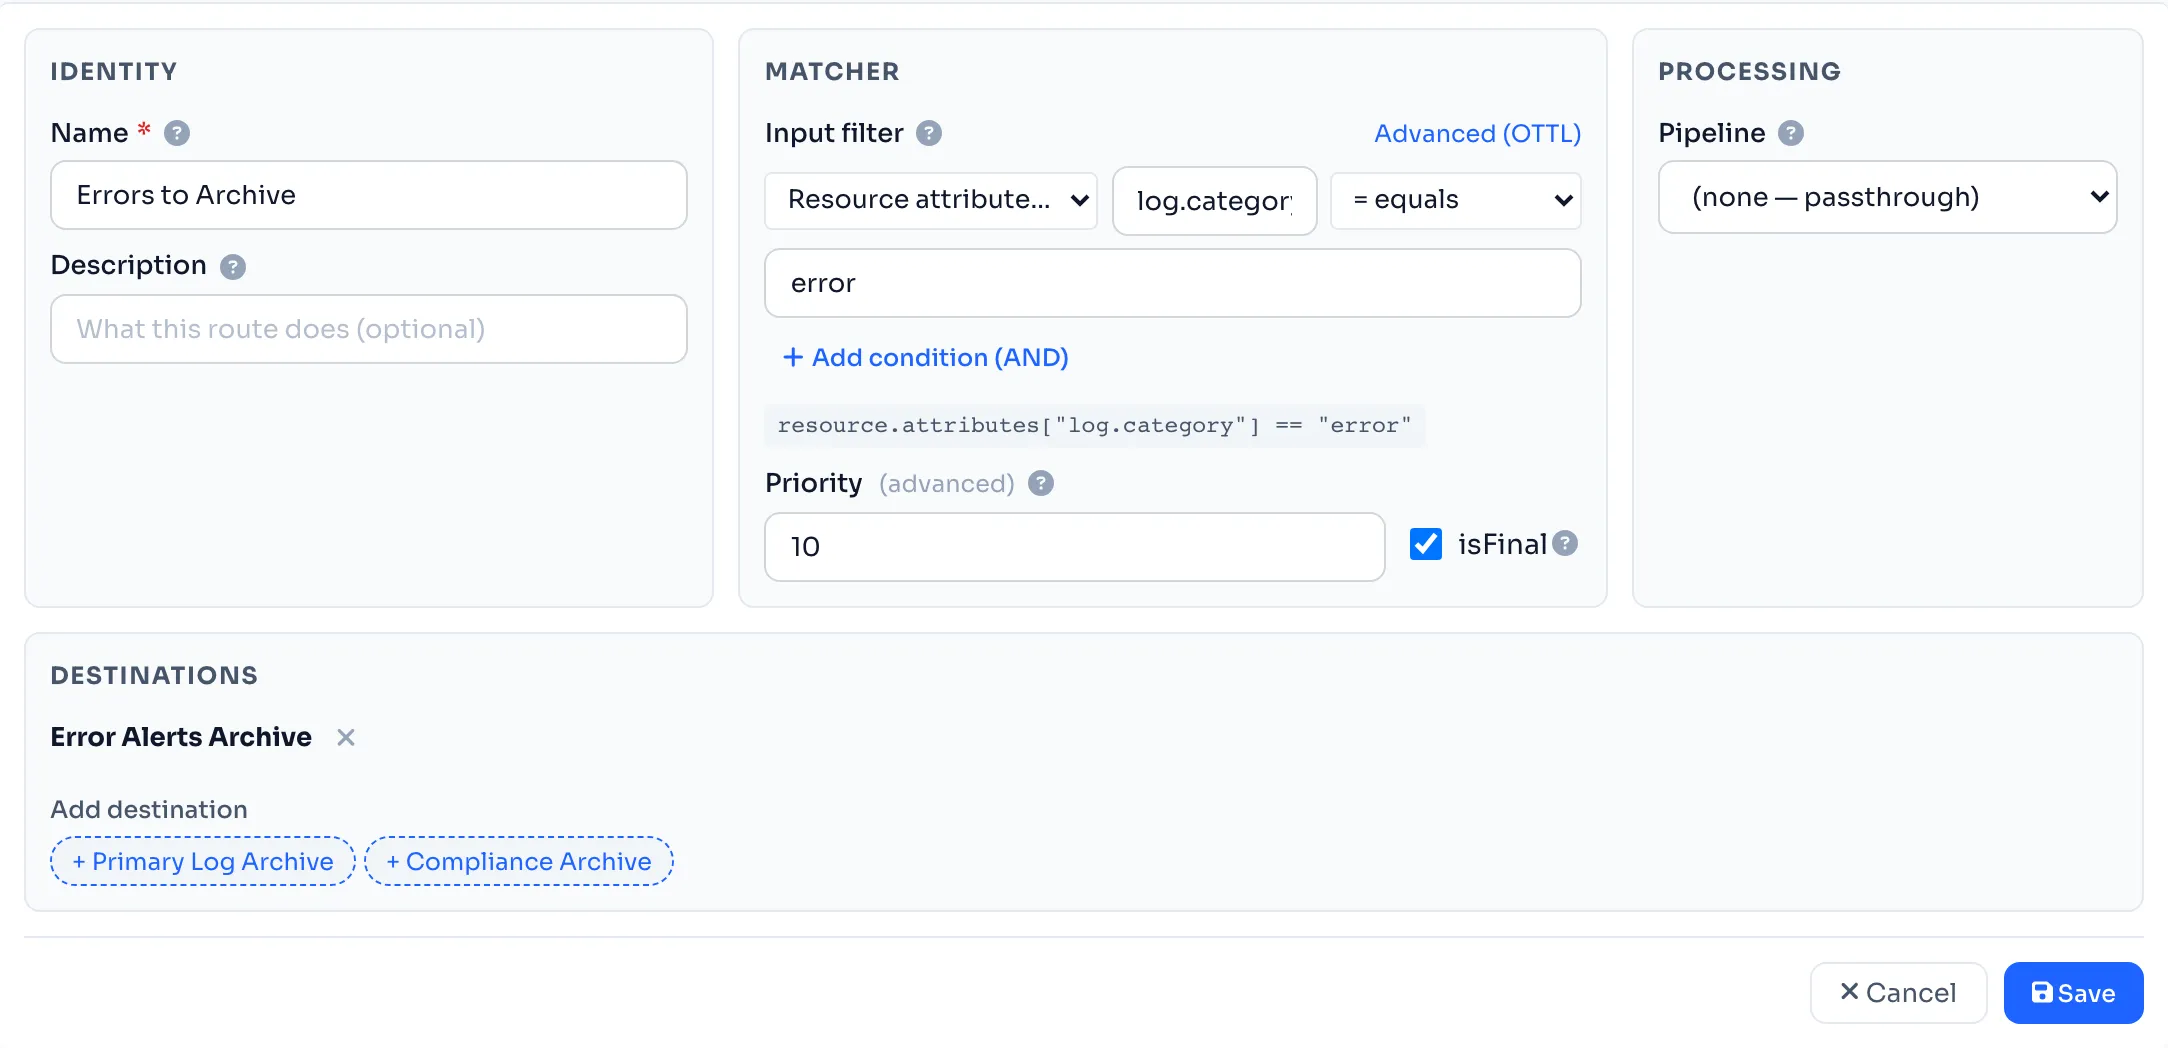
Einige Felder mit UND zu verknüpfen, deckt das meiste im Alltag ab — etwa
severity ≥ ERROR und service.namespace == "checkout". Für alles darüber hinaus —
ein ODER über mehrere Felder, eine Regex, ein verschachtelter boolescher Ausdruck — hat
der Builder einen Tab Advanced, der auf rohes OTTL umschaltet. Das ist ein
bewusster, ehrlicher Zielkonflikt: Der geführte Builder deckt den häufigen Fall mit
einer Bedingung oder mehreren UND-Bedingungen gut ab; er will kein vollständiger
visueller Ausdruckseditor sein, und Ausdrücke, die einen solchen bräuchten, laufen
weiterhin über Advanced.
Schritt 3 — Der Route ein Ziel geben
Eine Route ohne Ziel wertet nur aus und lässt den Treffer fallen. Das ist gelegentlich gewünscht (eine Route ohne Ziel dient zugleich als dokumentierte Verwerfungsregel), meistens aber nicht. Richten Sie eine Route auf ein oder mehrere Ziele, und ein Treffer wird dorthin geschickt; lassen Sie die letzte Route der Prioritätsliste einen breiten Auffangpfad zu Ihrem Standard-Backend sein, und nichts bleibt versehentlich ungeroutet.
Schritt 4 — Mit echtem Traffic überprüfen
Eine Config, die richtig aussieht, und eine Config, die sich richtig verhält, sind zwei verschiedene Aussagen. Der letzte Schritt ist also, zuzusehen, wie es funktioniert. Der Topologie-Canvas von LinkMesh zeigt den Durchsatz pro Kante — Datensätze pro Sekunde auf jedem Zweig —, sodass eine Aufteilung als Zahl erscheint, nicht als Hoffnung:
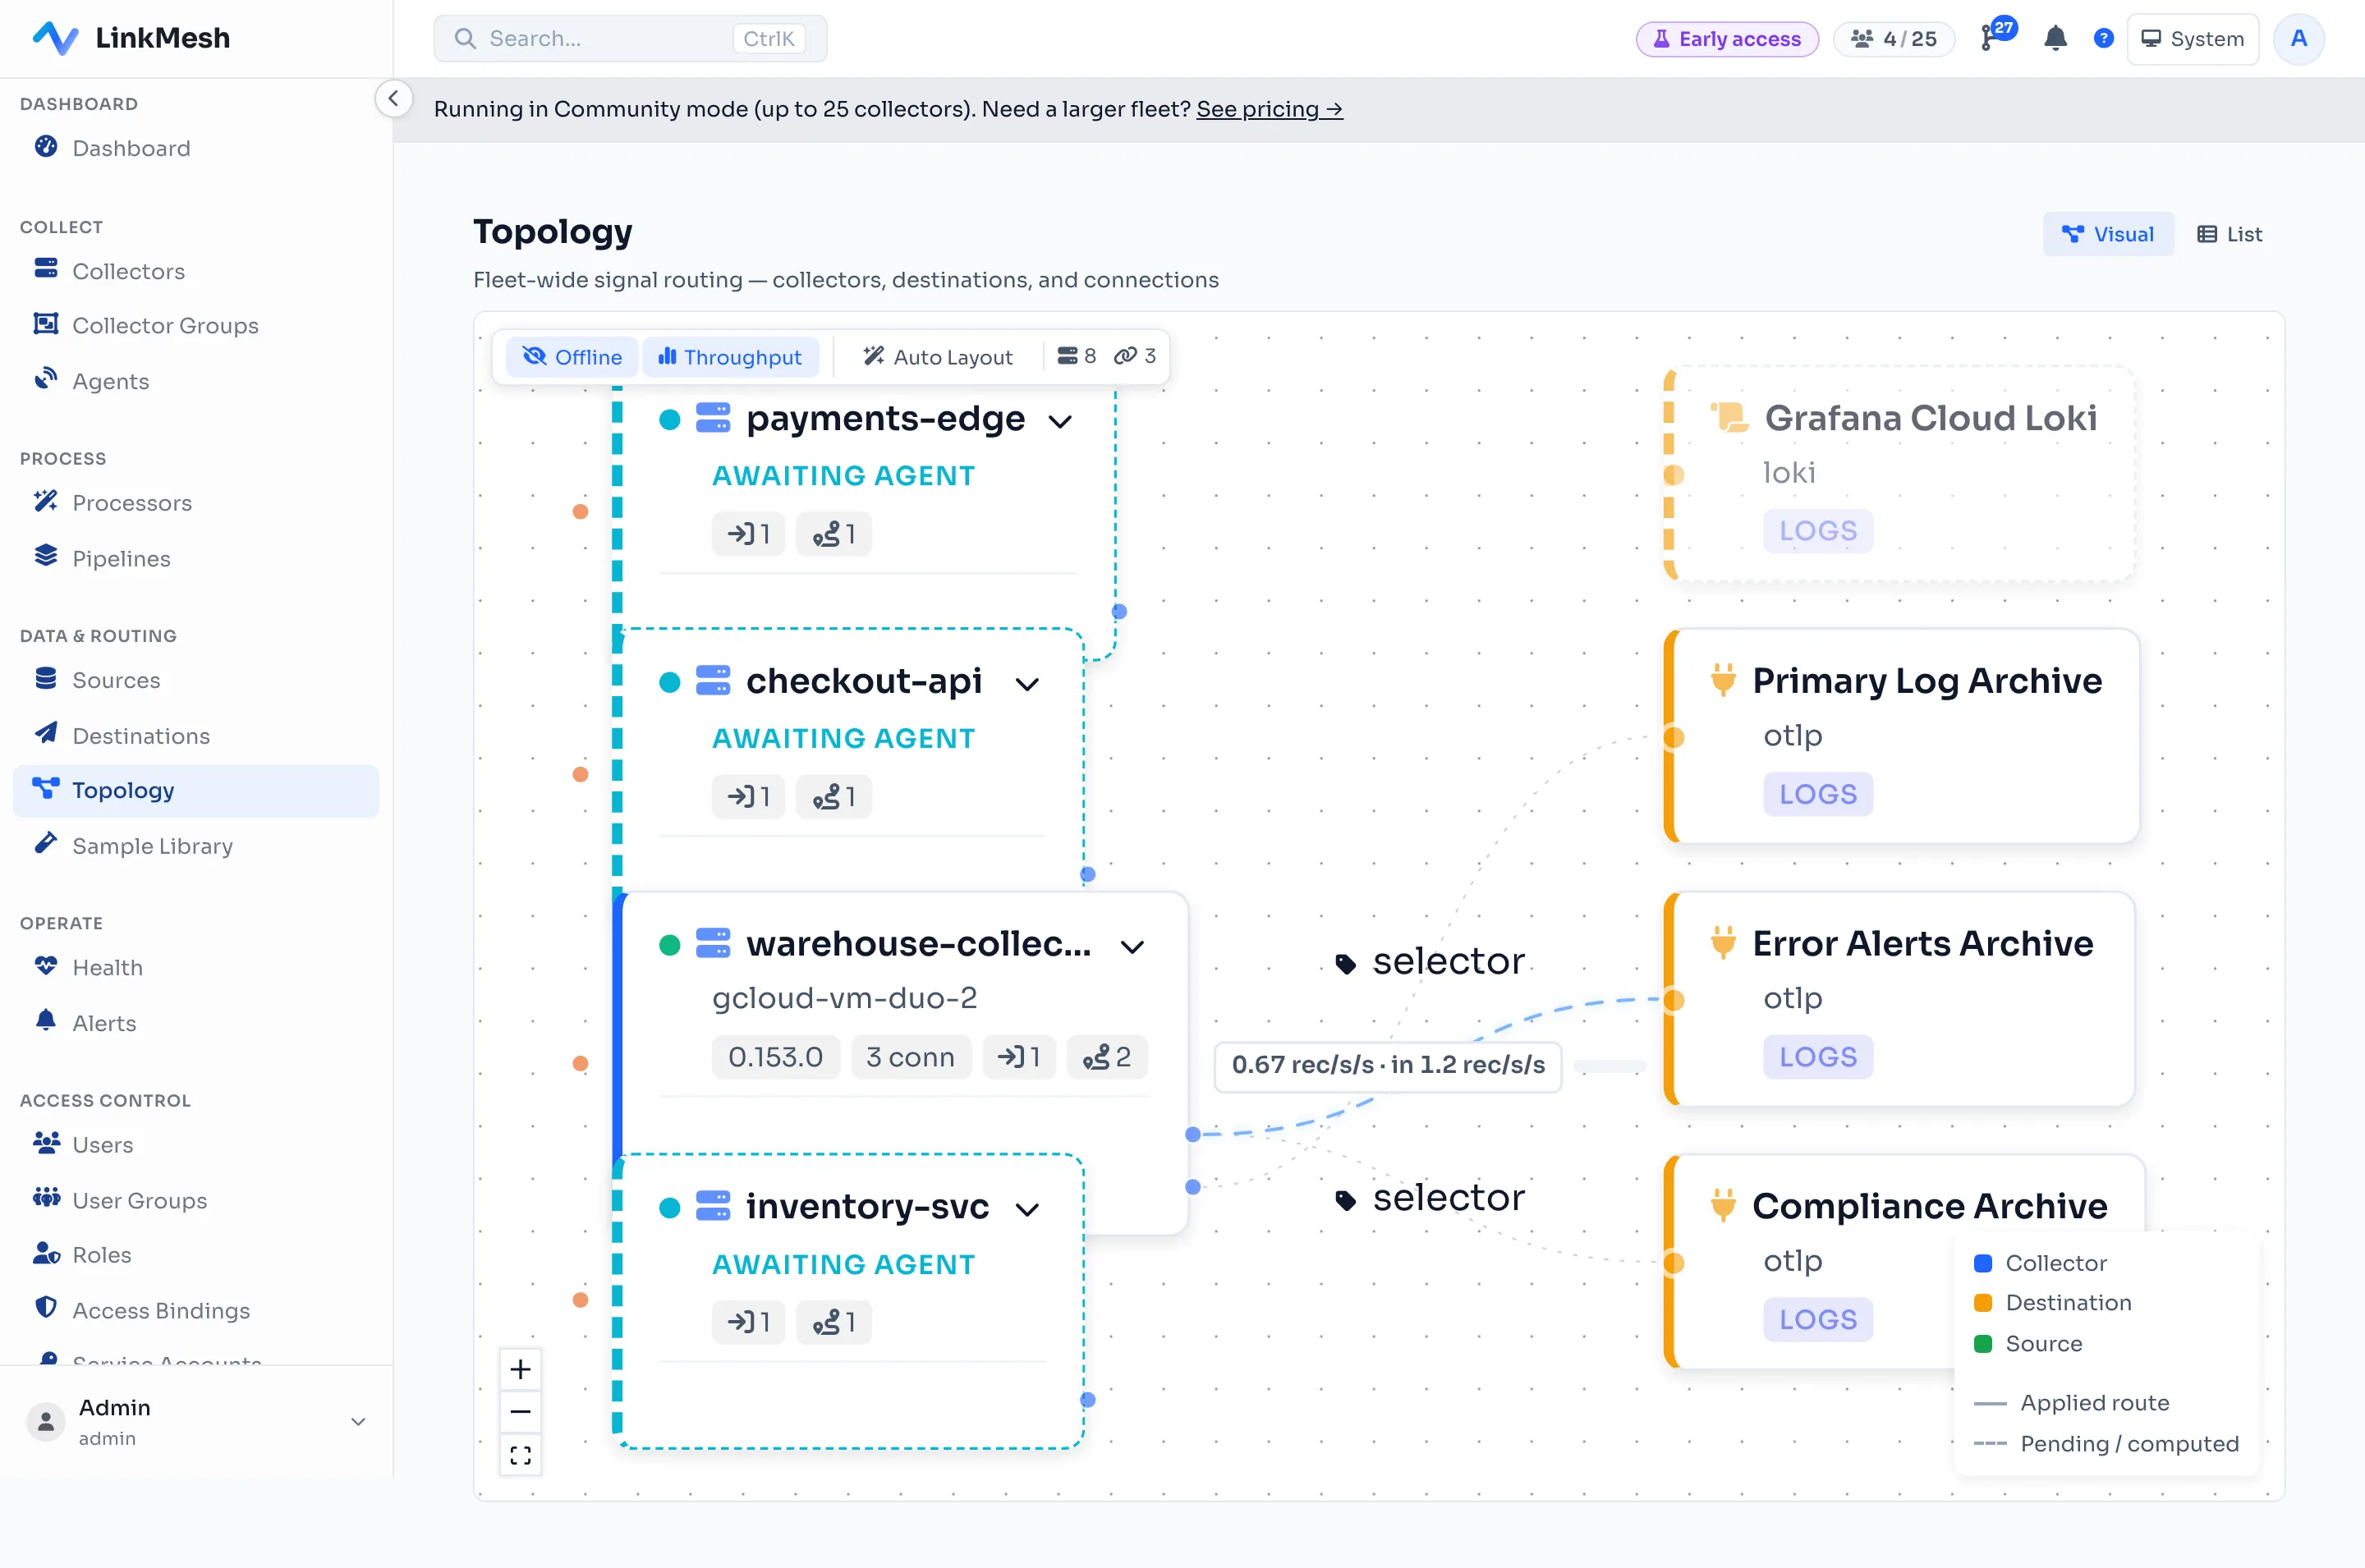
Schicken Sie echten Traffic durch, und Sie sehen es geschehen: Datensätze der Stufe Error nehmen den Archiv-Zweig, alles andere den Auffangpfad, und die beiden Kantenzähler belegen die Aufteilung, statt sie nur zu behaupten. (Auf dieselbe Ansicht des Durchsatzes pro Kante stützen wir uns, um zu messen, wohin die Observability-Ausgaben tatsächlich fliessen — Routing und Kostenkontrolle sind derselbe Muskel, auf unterschiedliche Ziele gerichtet.)
Schritt 5 — Eine zweite Achse: Ziele per Label verbinden
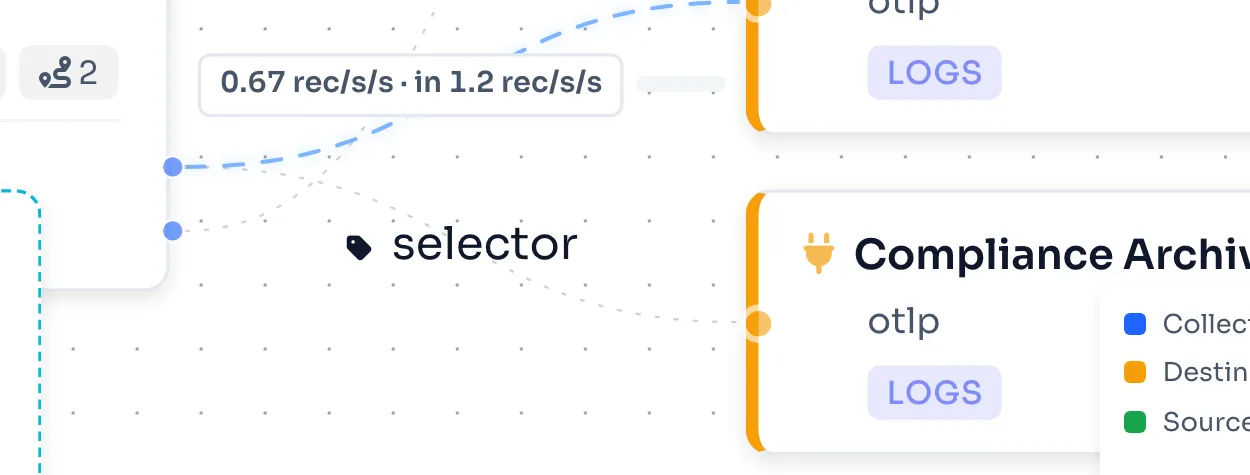
Alles oben ist eine Achse — welche Telemetrie wohin geht, entschieden durch Matching auf den Inhalt des Datensatzes. Es gibt eine zweite, getrennte Achse: welche Ziele die Treffer einer Route speisen, entschieden durch Matching auf die Tags eines Ziels statt auf die Telemetrie.
Versehen Sie ein Ziel einmal mit einem Tag —
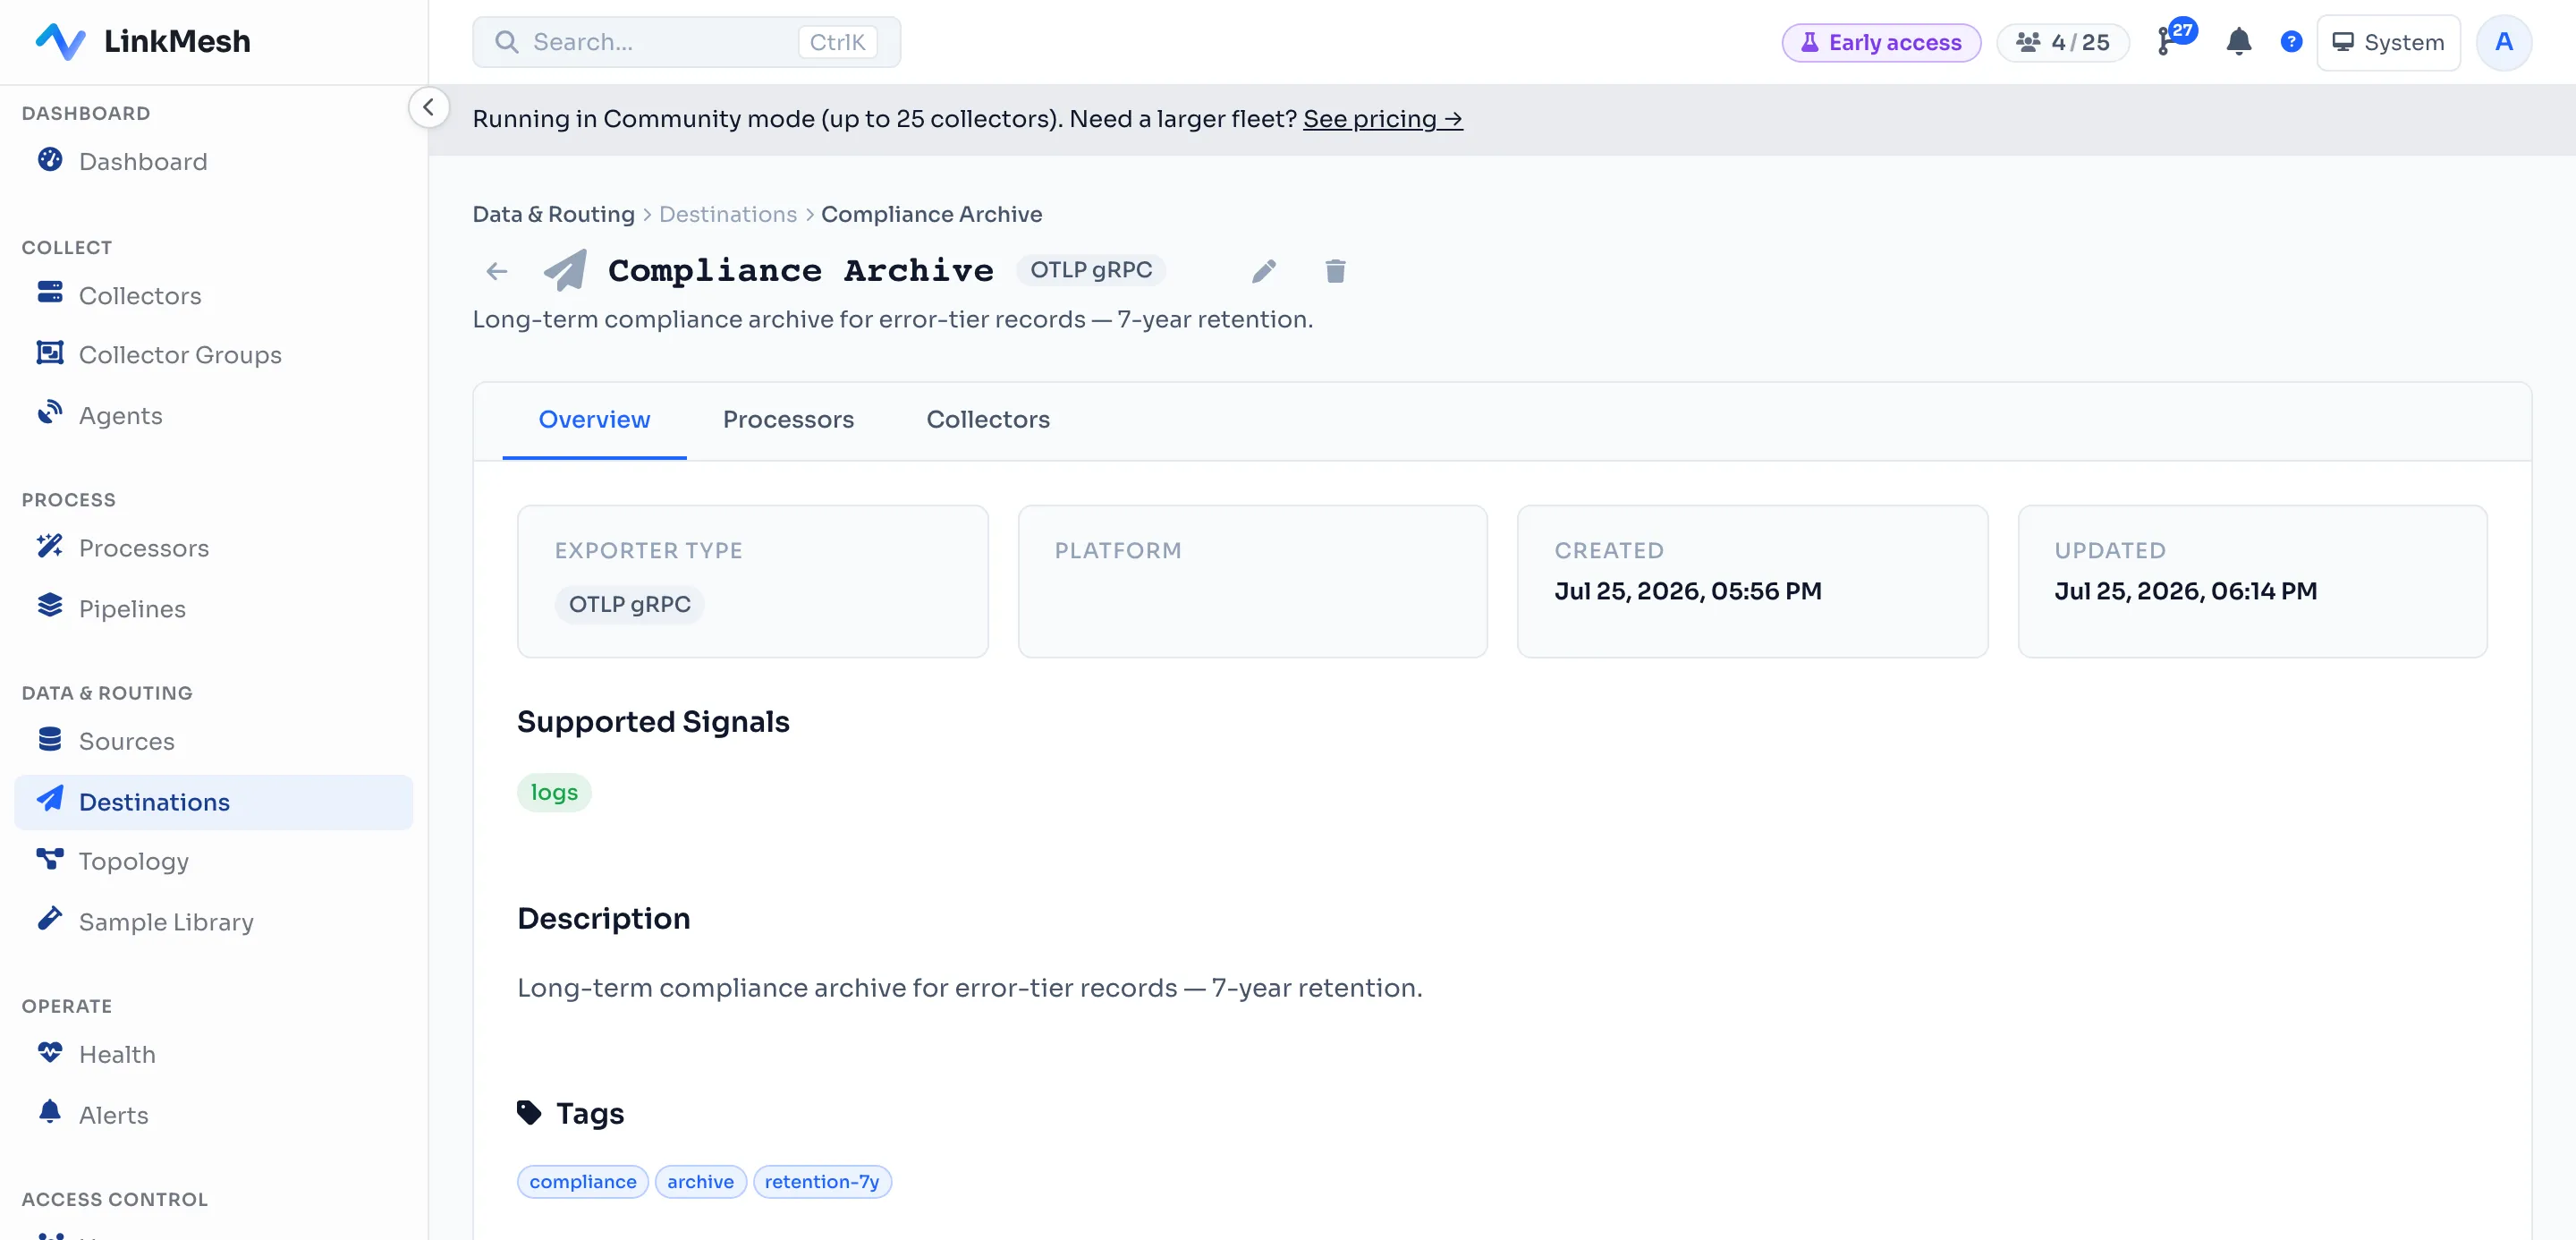
— und jede Route, deren destinationSelector auf dieses Tag passt, übernimmt es
automatisch, ohne dass Sie das Ziel von Hand in jede Route verdrahten müssen. Ein
neues Ziel mit demselben Tag wird an jede passende Route gehängt; ändern Sie das Tag,
fällt es heraus. Der Canvas stellt diese Verbindung als gestrichelte Geisterkante
dar, sodass Sie sie sehen, ohne in die Config zu schauen:
destinations:
  - name: cold-archive
    type: otlphttp
    endpoint: https://archive.internal:4318
    tags:
      tier: archive

routes:
  - name: errors-to-archive
    priority: 0
    match: 'severity_number >= SEVERITY_NUMBER_ERROR'
    destinationSelector:
      tier: archive
  - name: fallthrough
    priority: 1
    match: 'true'
    destinations: [default-egress]
Zwei ehrliche Grenzen, die Sie kennen sollten, bevor Sie sich darauf verlassen. Erstens
ist das Matching nur UND-Gleichheit — ein Selektor passt auf ein Ziel, dessen Tags
bei jedem angegebenen Schlüssel dem entsprechen, was Sie festgelegt haben. Es gibt
heute keinen Operator In, NotIn oder «Tag existiert». Zweitens gibt es noch keine
Oberfläche, um einen eigenen Selektor von Hand zu schreiben; Sie setzen ihn über die
API oder im YAML der Entität, und die Aufgabe des Canvas ist es, die entstehende
Verbindung darzustellen, nicht sie zu bauen. Wenn Sie etwas Aufwendigeres brauchen
als «Route X will jedes Ziel mit tier=archive», ist das heute noch eine Config-Datei,
kein Formular.
Verwechseln Sie die beiden Achsen nicht
Man vermischt die beiden leicht, weil beide das Wort «Route» verwenden, deshalb klar gesagt: Der Filter entscheidet, welche Telemetrie eine Route annimmt; der Ziel-Selektor entscheidet, an welche Ziele die getroffene Telemetrie dieser Route verteilt wird. Das eine liest den Inhalt des Datensatzes, das andere die Tags eines Ziels. Eine Route kann einen engen Inhaltsfilter und eine breite, per Label gewählte Verteilung haben oder umgekehrt — es sind unabhängige Stellschrauben, nicht zwei Namen für dasselbe.
Wo Sie anfangen
- Ordnen Sie Ihre Ziele nach Wert, nicht nach Gewohnheit — welche Telemetrie wird tatsächlich abgefragt, und welche muss für die Compliance nur günstig irgendwo liegen?
- Schreiben Sie zuerst die engen Routen, den Auffangpfad zuletzt — die Prioritätsreihenfolge ist das ganze Sicherheitsmodell, also gehören spezifische Bedingungen vor die breiten.
- Bauen Sie den Filter mit der Auswahl aus Feld, Operator und Wert; greifen Sie nur dann zu Advanced-OTTL, wenn eine Bedingung es wirklich braucht.
- Versehen Sie Ziele mit Tags, statt sie von Hand in jede Route zu verdrahten, die sie erreichen soll, und lassen Sie sich das Ergebnis von den Geisterkanten auf dem Canvas zeigen.
- Beobachten Sie den Durchsatz pro Kante, nachdem Sie ausgerollt haben — eine Route, die auf dem Papier richtig aussieht, muss sich noch in Datensätzen pro Sekunde bewähren.
Telemetrie danach aufzuteilen, was sie tatsächlich ist — statt alles an ein Backend zu schicken, weil das der Weg des geringsten Widerstands ist —, ist der grösste Teil dessen, was eine Pipeline von einem durchreichenden Draht zu etwas macht, das seinen Platz zwischen Ihren Diensten und Ihrer Rechnung verdient. (Wo Routing unter den übrigen Aufgaben einer Pipeline steht, zeigt unser Leitfaden zu Telemetrie-Pipelines; wie sich LinkMesh speziell mit dem Routing-Modell von Cribl vergleicht, lesen Sie in unserem Überblick über Cribl-Alternativen.)
LinkMesh routet Telemetrie nach Attribut mit einem Builder aus Feld, Operator und Wert (Advanced-OTTL, wenn Sie es brauchen), verbindet Ziele per Label mit Routen statt per Handverdrahtung und zeigt Ihnen den Durchsatz pro Kante, sodass eine Aufteilung eine Zahl ist, die Sie überprüfen können, und keine Hoffnung. In wenigen Minuten aufsetzen oder ansehen, was es kann.