
 LinkMeshObservability Data Collection Management
OTel-Architektur für Unternehmen
Agents, Gateways und eine Control Plane — das Muster, das skaliert.
 Philippe Braxmeier← Zurück zum Blog
Ein einzelner OpenTelemetry Collector ist einfach. Ein Binary, eine YAML-Datei, Receiver links, Exporter rechts. Es funktioniert auf Ihrem Laptop und auf einem Host. Dann haben Sie dreitausend Hosts, vierzig Teams, fünf Backends, eine Compliance-Regel zu PII und ein Finance-Team, das fragt, warum sich die Ingest-Rechnung verdoppelt hat — und das mentale Modell des einzelnen Collectors hilft nicht mehr.
In diesem Massstab hat OpenTelemetry eine Referenzarchitektur, und es lohnt sich, sie zu kennen, bevor Sie eine eigene improvisieren. Sie hat drei bewegliche Teile: Agent-Collectors nahe der Last, eine Gateway-Ebene in der Mitte und eine Control Plane, die beide konfiguriert. Dieser Leitfaden geht jeden Teil durch, den Datenfluss dazwischen, wohin Verarbeitung gehört und welche Sicherheitsgrenzen Ihre Telemetrie Ihre bleiben lassen.
Platform Engineers, SREs und Architekten, die ein OpenTelemetry-Deployment entwerfen, das echten Massstab überstehen muss — viele Hosts, viele Teams, mehrere Backends und eine Sicherheits- oder Compliance-Grenze. Voraussetzungen: Sie verstehen, was ein Collector-Receiver, -Processor und -Exporter tun; hier fügen wir sie zu einer Topologie zusammen statt zu einer einzelnen Config.
Die zwei Collector-Rollen
Die Kernidee der Referenzarchitektur ist, dass ein Collector je nach Standort eine von zwei Rollen spielt, und die beiden Rollen wollen Unterschiedliches:
- Agent-Collectors laufen nahe der Telemetrie — als DaemonSet auf jedem
Kubernetes-Node oder als Prozess auf jeder VM. Ihre Aufgabe ist lokale Erfassung:
hostmetricsscrapen,filelogtailen,journaldlesen, OTLP von der App auf localhost empfangen. Sie sind zahlreich, sie sind ressourcenbeschränkt (sie teilen sich den Host mit Ihrer eigentlichen Last), und sie sollten günstig bleiben. - Gateway-Collectors laufen als zentrale, eigenständige Ebene — ein horizontal skaliertes Deployment, an das jeder Agent liefert. Sie sind wenige, unabhängig skalierbar und dort erledigen Sie die teure, flottenweite Arbeit: Aggregation, Tail Sampling, schwere Redaction, Routing zu mehreren Backends.
Sie können OTel nur mit Agents, nur mit Gateways betreiben oder — das Muster, bei dem die meisten Unternehmen landen — beides. Die Deployment-Mechanik jedes einzelnen (DaemonSet, Sidecar, Gateway) ist ein eigenes Thema; siehe Collector-Deployment-Patterns für das Wie. In diesem Beitrag geht es darum, warum die zweistufige Form existiert und wie die Teile zusammenhängen.
Warum zwei Ebenen statt einer
Wenn ein Agent auf jedem Host direkt zu Ihrem Backend exportieren kann, warum ein Gateway dazwischenschieben? Vier Gründe, die mit zunehmendem Massstab jeweils überzeugender werden:
- Aggregation und Tail Sampling brauchen einen Engpass. Die Spans eines Traces treffen auf verschiedenen Agents auf verschiedenen Hosts ein. Tail-basiertes Sampling — die langsamen Traces behalten, die Fehler, eine Stichprobe des Rests — muss den ganzen Trace sehen, und dafür müssen die Spans irgendwo zusammenlaufen. Dieses Irgendwo ist das Gateway.
- Egress-Kontrolle. Sie wollen nicht, dass dreitausend Hosts jeweils eine Verbindung zu einem Drittanbieter-Backend über Ihre Netzgrenze öffnen. Trichtern Sie durch eine Gateway-Ebene, und Egress passiert von einem kleinen, bekannten Satz Nodes, den Sie per Firewall schützen, überwachen und dessen Credentials Sie rotieren können.
- Backend-Fan-out gehört an eine Stelle. Denselben Stream an zwei Backends zu routen oder Logs an günstigen Speicher und Traces an Ihren APM-Anbieter aufzuteilen, ist Config, die Sie einmal am Gateway ändern wollen, nicht an jeden Agent verteilen.
- Agents bleiben leicht. Schwere Verarbeitung von den Hosts fernzuhalten hält den CPU- und Memory-Fussabdruck des Agents klein und vorhersehbar — was zählt, wenn er sich einen Node mit der Last teilt, die Ihnen wirklich wichtig ist.
Der Trade-off ist ehrlich: Die Gateway-Ebene ist Infrastruktur, die Sie nun betreiben, skalieren und hochverfügbar halten müssen. Es ist eine Komponente, die ausfallen kann, und wenn sie das tut, sitzt sie zwischen Ihrer Telemetrie und Ihrem Backend. Das ist ein echter Preis — behandelt in Collector High Availability — und es ist der Preis für den Hebel, den die Ebene bietet.
Der Datenfluss
Von Anfang bis Ende bewegt sich Telemetrie in eine Richtung durch die Architektur:
Sources → Agent-Ebene → Gateway-Ebene → Backends.
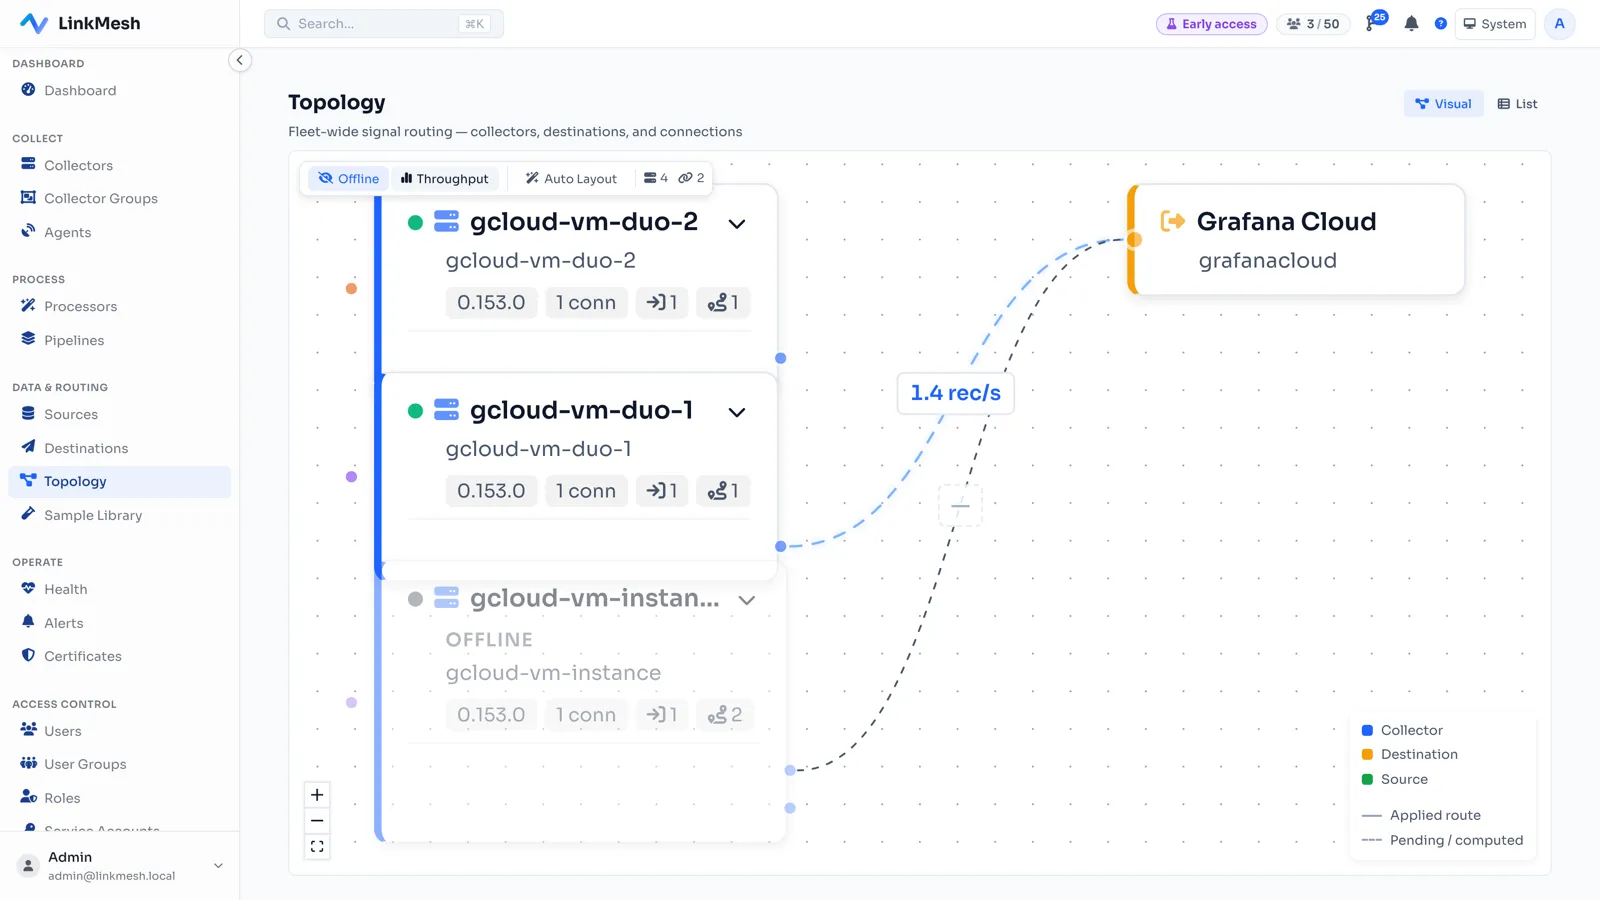
Sources sind Ihre Hosts, Pods und instrumentierten Anwendungen. Agents erfassen lokal und erledigen leichte, günstige Arbeit — Resource-Attribute setzen, offensichtliches Rauschen verwerfen — und leiten dann über OTLP an das Gateway weiter. Das Gateway erledigt die teure, zustandsbehaftete Arbeit — aggregieren, Tail Sampling, redacten, routen — und exportiert an ein oder mehrere Backends. Über allem konfiguriert eine Control Plane jeden Collector in beiden Ebenen, ohne dass die Telemetrie je durch sie hindurchläuft.
Wohin Verarbeitung gehört: Edge vs. Gateway
Die immer wiederkehrende Design-Frage ist, wo jeder Processor laufen soll — auf den Agents am Edge oder zentral am Gateway. Die Antwort lautet nicht “immer an einer Stelle”; sie hängt davon ab, was der Processor braucht.
Am Edge (Agent) erledigen:
- Resource-Attribution. Setzen Sie
service.name,deployment.environment.nameundk8sattributesdort, wo der Kontext ist — auf dem Node, der weiss, welcher Pod die Daten erzeugt hat. Tun Sie es spät, ist der lokale Kontext verloren. - Offensichtliche, günstige Rausch-Drops. Health-Check-Spam oder Sub-INFO-Logs früh zu verwerfen bedeutet, dass Sie nie dafür bezahlen, sie zum Gateway zu schicken.
- Redaction der sensibelsten Felder, wenn Ihre Grenze verlangt, dass PII maskiert wird, bevor sie den Host verlässt — mehr dazu unten.
Am Gateway erledigen:
- Tail-basiertes Sampling. Es braucht den ganzen Trace zusammengesetzt, was erst passiert, wenn die Spans zusammenlaufen. Am Edge kann es nicht funktionieren.
- Cross-Stream-Aggregation und alles Zustandsbehaftete, das davon profitiert, Traffic von vielen Hosts gleichzeitig zu sehen.
- Schwere oder CPU-teure Transforms, weg von den geteilten Last-Hosts.
- Backend-Routing und Fan-out, sodass eine Ziel-Änderung ein Edit in einer Ebene ist.
# Agent: light, local, cheap — set context and forward
receivers:
  filelog: { include: [/var/log/pods/*/*/*.log] }
processors:
  resourcedetection: { detectors: [env, system] }
  k8sattributes:
  filter/drop_health: { logs: { log_record: ['IsMatch(attributes["url.path"], "/healthz")'] } }
exporters:
  otlp/gateway: { endpoint: "otel-gateway.internal:4317" }
service:
  pipelines:
    logs: { receivers: [filelog], processors: [k8sattributes, resourcedetection, filter/drop_health], exporters: [otlp/gateway] }
# Gateway: expensive, stateful, fleet-wide — sample, redact, route
receivers:
otlp: { protocols: { grpc: { endpoint: "0.0.0.0:4317" } } }
processors:
tail_sampling:
policies:
- name: errors
type: status_code
status_code: { status_codes: [ERROR] }
redaction/pii:
allow_all_keys: true
blocked_values: ['\d{3}-\d{2}-\d{4}']
exporters:
otlphttp/primary: { endpoint: "https://backend-a.internal:4318" }
otlphttp/archive: { endpoint: "https://backend-b.internal:4318" }
service:
pipelines:
traces: { receivers: [otlp], processors: [tail_sampling, redaction/pii], exporters: [otlphttp/primary, otlphttp/archive] }Der zu benennende Trade-off: Edge-Redaction ist sicherer (sensible Daten verlassen nie den Host), kostet aber CPU auf jedem Node und ist über eine grosse Flotte hinweg schwerer konsistent zu halten. Gateway-Redaction ist einheitlich leichter durchzusetzen, bedeutet aber, dass die Rohdaten Ihr internes Netz durchqueren, um das Gateway zu erreichen. Welche Sie wählen, ist eine Grenz-Entscheidung, kein Default — siehe Sampling-Governance und PII-Maskierung in Logs für die Details.
Die Control Plane: OpAMP
Zeichnen Sie die Agent- und Gateway-Ebenen, und Sie haben die Daten-Ebene gezeichnet. Das fehlende Stück ist die Control Plane: das, was entscheidet, welche Config jeder dieser Collectors ausführt, und sie aktuell hält. Im OpenTelemetry-Ökosystem ist das OpAMP — das Open Agent Management Protocol — ein Standard dafür, dass ein zentraler Server die Konfiguration jedes Collectors besitzt und Updates an die Flotte verteilt.
Das zählt im Unternehmensmassstab aus einem simplen Grund: YAML auf dreitausend Nodes von Hand zu bearbeiten ist kein Betriebsmodell. Ohne Control Plane bekommen Sie Config-Drift, keinen Audit-Trail und keinen sicheren Weg, eine Änderung vorzuschauen, bevor sie die Produktion trifft. Mit einer wird die Konfiguration der Flotte zu einem einzigen kontrollierten Artefakt — gerendert, validiert, verteilt und versioniert. Die entscheidende Eigenschaft: die Control Plane verwaltet Config, nicht Daten — sie sitzt nie im Telemetrie-Pfad.
Sicherheitsgrenzen
Die Referenzarchitektur ist zugleich eine Sicherheitsarchitektur, und ihre zentrale Eigenschaft ist klar auszusprechen: Ihre Telemetrie bleibt auf Ihrer Infrastruktur. Sie fliesst Sources → Agent → Gateway → Backend, alles in Ihrem Netz, und Egress zu einem externen Backend passiert nur von der Gateway-Ebene, die Sie kontrollieren.
- Egress ist zentralisiert. Nur Gateways reden mit externen Backends. Das ist ein kleiner, auditierbarer Satz Nodes zum Absichern per Firewall und zum Rotieren von Credentials — nicht jeder Host.
- PII wird vor dem Egress redactet. Was Ihre Grenze verlässt, hat bereits die Redaction-Processors passiert. Wo genau das passiert (Edge vs. Gateway) ist der obige Trade-off, aber dass es vor dem Egress passiert, ist die Regel.
- Die Control Plane liegt ausserhalb des Datenpfads. Eine Control Plane wie LinkMesh konfiguriert die Flotte über OpAMP, aber die Telemetrie fliesst nie durch sie — sie bleibt auf Ihrer Infrastruktur und wandert direkt von den Collectors zu Ihrem Backend. Die Management-Schicht ist kein neuer Ort, an dem sensible Daten liegen, und keine neue externe Abhängigkeit im heissen Pfad.
Auf diesen letzten Punkt sollten Unternehmen bei der Bewertung jedes Management-Tools am härtesten drücken: Wenn seine Einführung bedeutet, Ihre Telemetrie durch die Cloud eines Anbieters zu leiten, haben Sie genau die Abhängigkeit wieder eingeführt, zu deren Beseitigung die Architektur existiert.
Skalierung und HA am Gateway
Die Gateway-Ebene ist der Ort, an dem sich Availability-Engineering konzentriert, weil sie die
geteilte Komponente ist, von der jeder Agent abhängt. Die Kurzfassung: Betreiben Sie Gateways
als horizontal skaliertes, lastverteiltes Deployment; nutzen Sie die memory_limiter- und
Queued-Retry-Einstellungen des Collectors, damit Backpressure nicht kaskadiert; und stellen
Sie einen Load Balancer davor (trace-aware, wenn Sie Tail Sampling machen), damit die Spans
eines Traces auf derselben Instanz landen. Die Agents dagegen skalieren trivial — einer pro
Host — und ihre Fehlerdomäne ist ein einzelner Node.
Das ist die Skizze; das Gateway-HA-Design hat genug Tiefe, um eine eigene Behandlung zu verdienen, inklusive Load-Balancing für Tail Sampling und was während eines Rollouts passiert. Sie steht in Collector High Availability, und der sichere Weg, Gateway-Config ohne Ausfall zu ändern, in Config-Rollout und Rollback.
Alles zusammengesetzt
Die OpenTelemetry-Unternehmensarchitektur besteht aus drei Teilen und einer Regel:
- Agents erfassen lokal, formen günstig und leiten weiter — zahlreich und leicht.
- Gateways aggregieren, sampeln, redacten und routen — wenige und unabhängig skaliert.
- Eine Control Plane (OpAMP) konfiguriert beide, ohne die Daten zu berühren.
- Die Regel: Telemetrie bleibt auf Ihrer Infrastruktur; Egress ist zentralisiert; die Management-Schicht betritt nie den Datenpfad.
Bringen Sie diese Beziehungen richtig hin, und Skalierung wird zur Frage, einer bekannten Form Kapazität hinzuzufügen, statt die Topologie jedes Mal neu zu erfinden, wenn der Bestand wächst. Das mentale Modell des einzelnen Collectors war nie falsch — es war nur nicht das ganze Bild.
Für Bestände unter einer Souveränitätsanforderung — Schweizer Banken, Versicherungen, öffentlicher Sektor — steht dieselbe Form mit festgelegtem Standort, Klassifizierung und Egress jeder Ebene in Eine souveräne Schweizer Telemetrie-Architektur bauen.
Die Architektur besteht aus drei Ebenen; sie zu betreiben ist ein Problem der Flottenkonfiguration. LinkMesh ist eine selbstgehostete OpAMP-Control-Plane, die Collector-Config für Ihre Agent- und Gateway-Ebenen komponiert, validiert und verteilt — mit Durchsatz pro Edge, sodass der Datenfluss eine Zahl ist, die Sie beobachten können, kein Diagramm, auf dessen Bestand Sie hoffen. Telemetrie bleibt auf Ihrer Infrastruktur; berechnet pro Collector, nicht pro GB. Stellen Sie eine auf in Minuten, oder sehen Sie, was sie kann.