
 LinkMeshObservability Data Collection Management
Collector-Deployment-Patterns
Agent, Sidecar, Gateway, Hybrid — und wann welches passt.
 Roman Hüsler← Zurück zum Blog
“Einen Collector deployen” ist täuschend vage. Ein OpenTelemetry Collector ist dasselbe Binary, ob er einmal pro Host, einmal pro Pod oder als zentrales Cluster läuft — aber wo Sie ihn betreiben, ändert, worin er gut ist, was er kostet und was ausfällt, wenn er kaputtgeht. Wählen Sie das falsche Muster, und Sie hungern entweder Ihre Workloads an CPU aus oder trichtern die Telemetrie Ihres gesamten Bestands durch einen einzelnen Point of Failure.
Dieser Leitfaden legt die konkreten Deployment-Patterns dar, wann jedes passt und die Kubernetes-Besonderheiten, die einige davon leicht machen. Er ist der praktische Begleiter zur Enterprise-Architektur-Übersicht — jener Beitrag erklärt, warum die Agent-und-Gateway-Form existiert; dieser ist das Wie Sie die Collectors tatsächlich deployen.
Platform Engineers und SREs, die entscheiden, wie sie OpenTelemetry Collectors deployen — auf VMs, in Kubernetes oder beidem. Voraussetzungen: Sie wissen, was ein Collector tut (empfangen, verarbeiten, exportieren) und können einen Container oder einen Prozess in Ihre Umgebung deployen. Hier vergleichen wir die Topologien, nicht die Receiver-Config.
Die Muster auf einen Blick
Es gibt fünf Deployment-Formen, die man kennen sollte — plus die Kein-Collector-Basislinie, direkt aus dem SDK zu exportieren. Die meisten echten Deployments nutzen zwei davon zusammen.
| Muster | Wo es läuft | Am besten für | Trade-offs |
|---|---|---|---|
| Agent pro Host | Ein Prozess auf jeder VM / jedem Host | VM-Flotten; lokales hostmetrics, filelog, journald |
Eine Config × N Hosts zu verwalten; teilt Host-Ressourcen |
| DaemonSet | Ein Pod pro Kubernetes-Node | Node- + Pod-Telemetrie in K8s; der Standard-K8s-Agent | Blast Radius auf Node-Ebene; konkurriert um Node-Ressourcen |
| Sidecar | Ein Container pro Anwendungs-Pod | Strikte Pod-Isolation; Config pro App; kurzlebige Jobs | Vervielfacht die Collector-Zahl; Overhead pro Pod |
| Gateway / Aggregation | Zentrales eigenständiges Deployment | Tail Sampling, Egress-Kontrolle, Backend-Fan-out | Neue Ebene zu betreiben und HA zu halten; sitzt im Datenpfad |
| Hybrid (Agent + Gateway) | Beide Ebenen zusammen | Enterprise-Massstab; Trennung lokaler vs. Flottenarbeit | Die meisten beweglichen Teile; zwei Ebenen zu betreiben |
| Kein Collector (SDK direkt) | Nichts — SDK exportiert zum Backend | Prototypen, Serverless, winzige Fussabdrücke | Kein lokales Buffering, Formen oder Backend-Flexibilität |
Der Rest dieses Beitrags handelt davon, wann man zu welchem greift.
Agent pro Host / DaemonSet
Das Agent-Muster betreibt einen Collector so nah an der Telemetrie wie möglich — einen pro Host. Auf VMs ist das ein Prozess (etwa eine systemd-Unit) auf jeder Maschine. In Kubernetes ist das Äquivalent ein DaemonSet: Der Scheduler garantiert genau einen Collector-Pod pro Node, und er lebt und stirbt mit dem Node.
Das ist das Arbeitspferd für lokale Erfassung. Der Agent scrapet hostmetrics, tailt
filelog und journald, liest die kubeletstats des Kubelets und empfängt OTLP von
Anwendungen auf localhost. Weil er auf dem Node ist, hat er den lokalen Kontext —
k8sattributes, Host-Identität — um Daten an der Quelle korrekt zu taggen.
# DaemonSet agent — collect node + pod telemetry, forward to the gateway
receivers:
  hostmetrics: { collection_interval: 30s, scrapers: { cpu: , memory: , disk: , network: } }
  filelog: { include: ["/var/log/pods/*/*/*.log"] }
  otlp: { protocols: { grpc: { endpoint: 0.0.0.0:4317 } } }
processors:
  k8sattributes:
exporters:
  otlp/gateway: { endpoint: "otel-gateway.internal:4317" }
service:
  pipelines:
    metrics: { receivers: [hostmetrics, otlp], processors: [k8sattributes], exporters: [otlp/gateway] }
    logs: { receivers: [filelog], processors: [k8sattributes], exporters: [otlp/gateway] }
Der Trade-off ist das Teilen von Ressourcen: Das DaemonSet konkurriert mit Ihren Workloads um
Node-CPU und -Memory, also halten Sie es leicht (setzen Sie memory_limiter, schieben Sie
schwere Arbeit nach unten), und sein Blast Radius ist ein Node — stirbt es, verlieren Sie die
Erfassung auf diesem Node, bis es neu startet, nicht flottenweit.
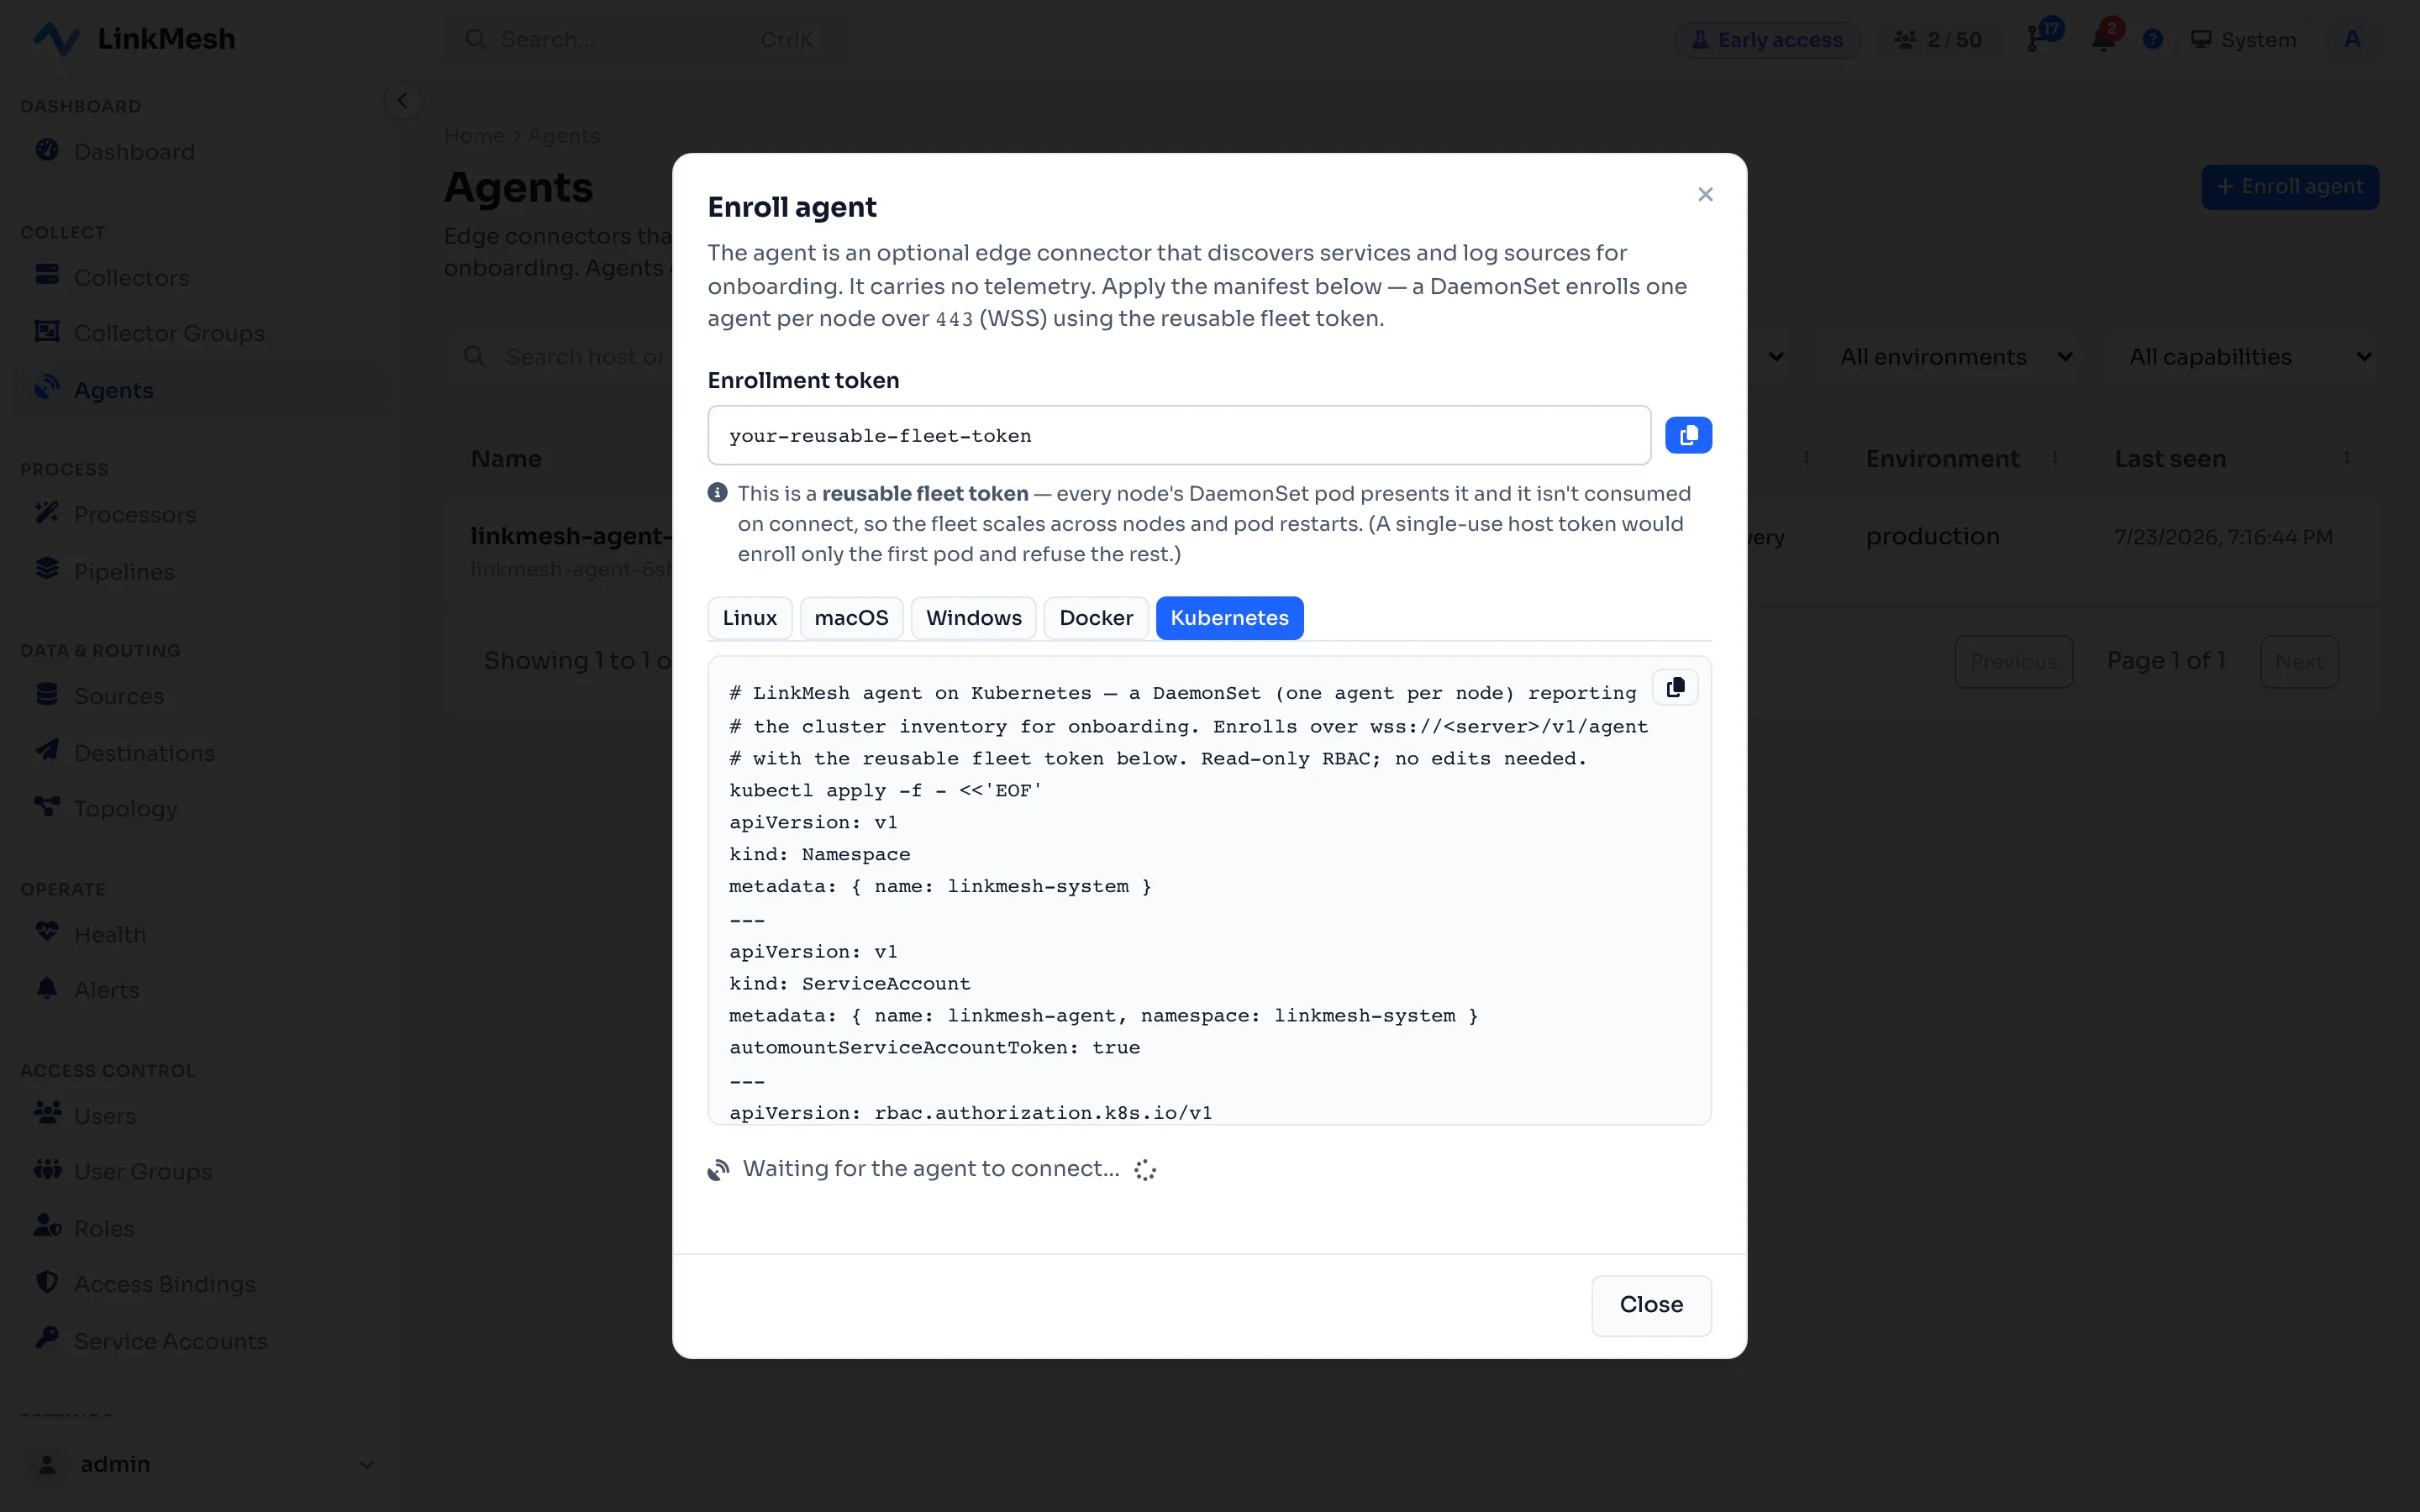
Eine Control Plane macht daraus einen Einzeiler. In LinkMesh liefert der Enroll-Agent-Assistent ein direkt anwendbares DaemonSet-Manifest — ein Agent pro Node, wiederverwendbares Flotten-Token vorausgefüllt, Read-only-RBAC und Pod-Log-Mounts bereits verdrahtet:
Sidecar
Das Sidecar-Muster betreibt einen Collector innerhalb jedes Anwendungs-Pods, als extra
Container neben der App. Die App exportiert an localhost, und das Sidecar erledigt den Rest.
Es ist die engste verfügbare Kopplung.
Greifen Sie dazu, wenn Sie Isolation oder Config pro Anwendung brauchen — der laute Collector eines Teams kann den eines anderen nicht beeinträchtigen — oder wenn der Workload kurzlebig ist und Sie seine Telemetrie geflusht haben wollen, bevor der Pod terminiert, was ein geteilter Node-Agent verpassen könnte. Batch-Jobs und Workloads pro Tenant sind die klassischen Fälle.
Der Preis ist Vervielfachung. Ein Sidecar pro Pod bedeutet, dass Ihre Collector-Zahl Ihrer Pod-Zahl folgt, jeder mit eigenem Memory-Overhead, und jeder ist eine Config zu verwalten. Für die meisten Teams deckt ein DaemonSet-Agent ab, was ein Sidecar täte, zu einem Bruchteil des Fussabdrucks — nutzen Sie Sidecars also dort, wo die Isolation eine echte Anforderung ist, nicht als Default.
Gateway- / Aggregations-Ebene
Das Gateway-Muster betreibt Collectors als zentrales, eigenständiges Deployment, an das Agents (oder Apps) liefern — ein horizontal skalierter, lastverteilter Dienst, einmal fürs Cluster oder die Region deployt statt einmal pro Host.
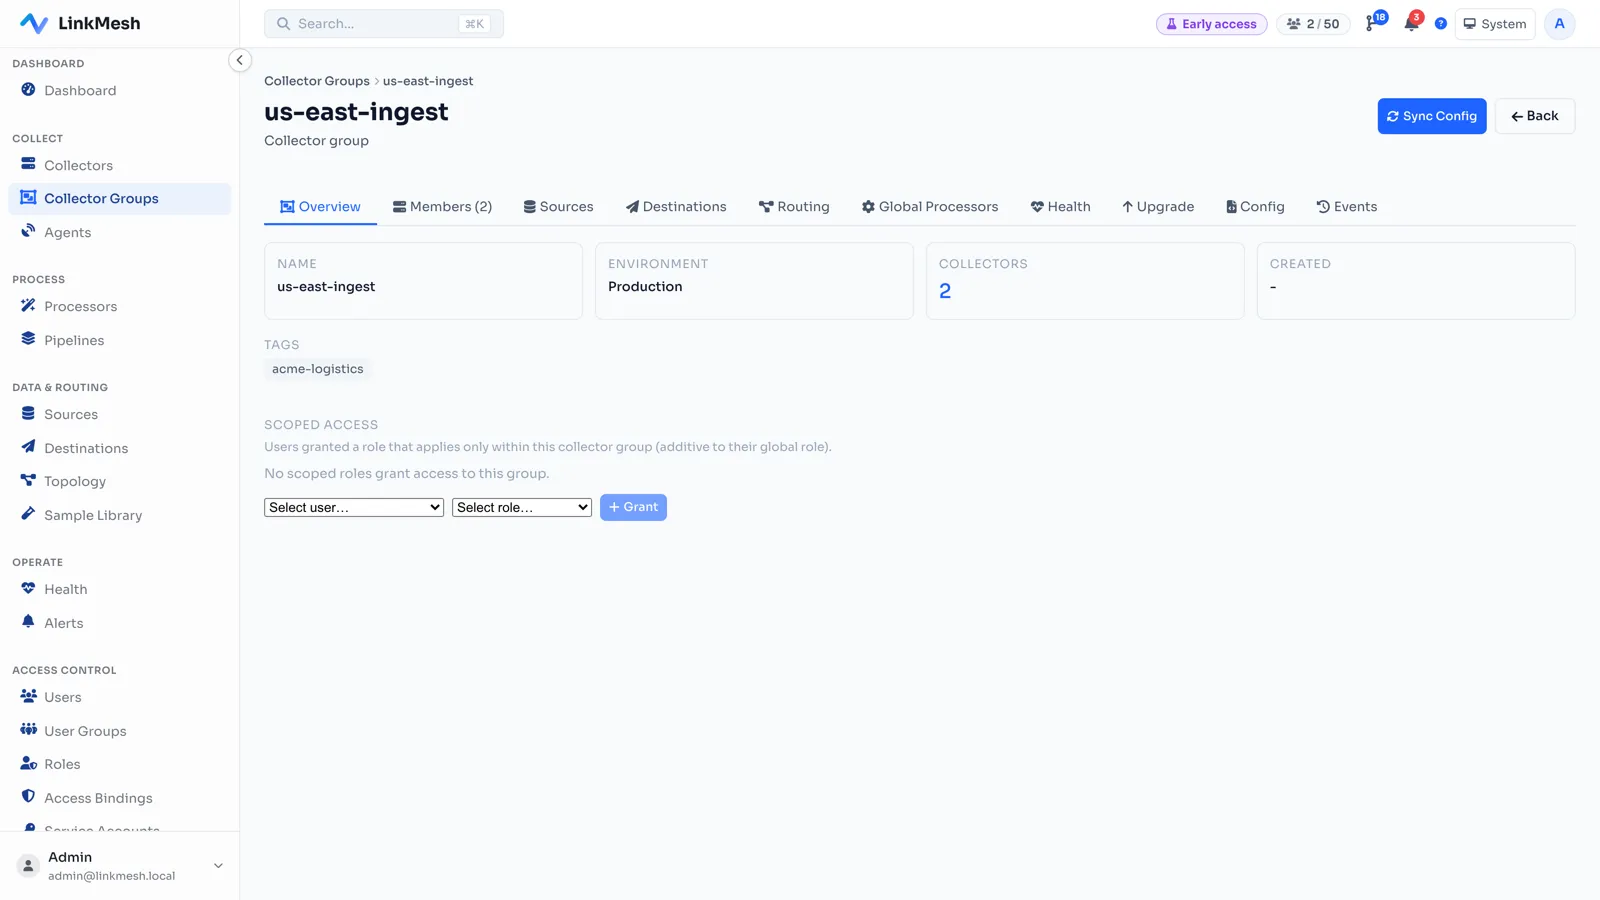
In LinkMesh ist eine Gateway-Ebene eine Collector-Gruppe: Fügen Sie die Nodes als Mitglieder hinzu, und alle führen dieselben gruppen-skopierten Sources, Pipelines und Destinations aus — Sie konfigurieren die Ebene einmal, nicht einmal pro Node, und neue Mitglieder erben sie beim Beitritt.
Das Gateway ist der Ort, an den die flottenweite, teure und zustandsbehaftete Arbeit gehört:
- Tail-basiertes Sampling, das ganze Traces an einer Stelle zusammengesetzt braucht.
- Egress-Kontrolle — ein kleiner, per Firewall geschützter Satz Nodes redet mit externen Backends, statt dass jeder Host seine eigene Verbindung öffnet.
- Backend-Fan-out — denselben Stream an mehrere Destinations routen, hier einmal geändert statt auf jedem Agent.
# Gateway — receive from agents, sample, and fan out to backends
receivers:
  otlp: { protocols: { grpc: { endpoint: 0.0.0.0:4317 } } }
processors:
  tail_sampling: { policies: [{ name: errors, type: status_code, status_code: { status_codes: [ERROR] } }] }
exporters:
  otlphttp/primary: { endpoint: "https://backend-a.internal:4318" }
  otlphttp/archive: { endpoint: "https://backend-b.internal:4318" }
service:
  pipelines:
    traces: { receivers: [otlp], processors: [tail_sampling], exporters: [otlphttp/primary, otlphttp/archive] }
Der ehrliche Trade-off: Das Gateway ist eine neue Ebene, die Sie betreiben, skalieren und verfügbar halten müssen, und es sitzt direkt im Telemetrie-Pfad — ist es unten, stauen sich Daten oder gehen verloren. Deshalb sind Gateway-High-Availability und sicherer Config-Rollout eigene Disziplinen.
Hybrid: Agent + Gateway
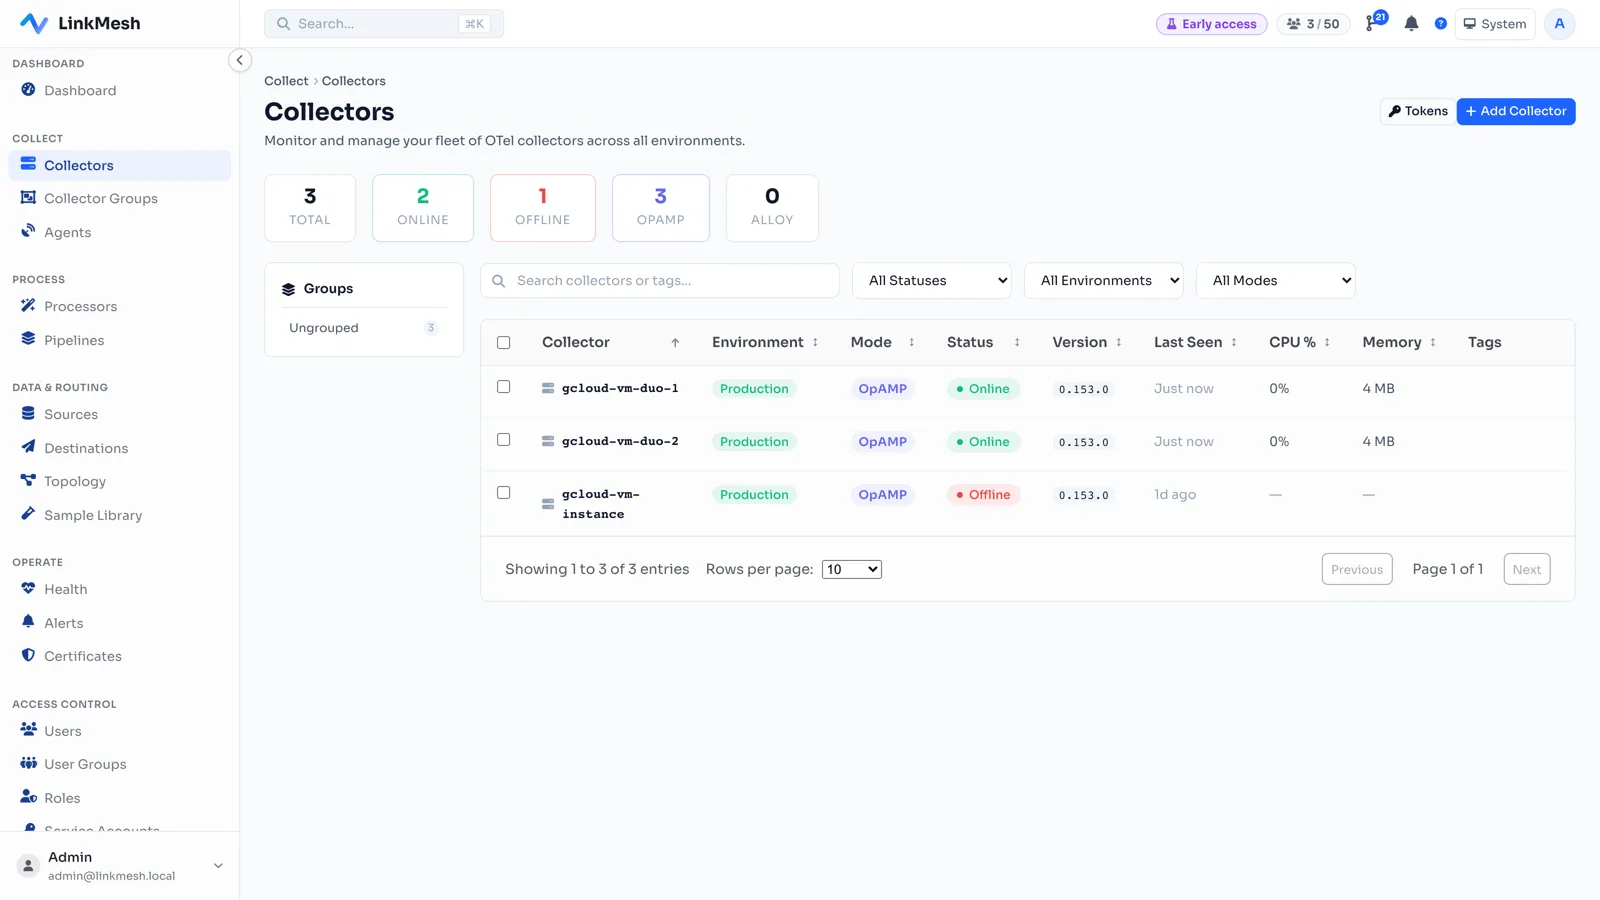
Das Muster, das die meisten Unternehmen tatsächlich betreiben, ist beides: Agents auf jedem Host für lokale Erfassung, die an eine zentrale Gateway-Ebene für Aggregation und Egress weiterleiten. Leichte Arbeit am Edge, schwere Arbeit in der Mitte, Telemetrie, die dort zusammenläuft, wo sie muss.
Kein Collector — und warum Sie meist trotzdem einen wollen
Sie können den Collector ganz weglassen: OpenTelemetry-SDKs können OTLP direkt zu einem Backend exportieren. Für einen Prototyp, eine Demo oder eine Serverless-Funktion, bei der ein Sidecar umständlich ist, ist das eine legitime Wahl — weniger bewegliche Teile, nichts extra zu deployen.
Aber in der Produktion wollen Sie fast immer trotzdem einen Collector zwischen App und Backend, aus Gründen, die das SDK nicht abdecken kann:
- Buffering und Retries. Ein Collector puffert und wiederholt, wenn das Backend kurz nicht erreichbar ist. Direkt aus dem SDK verwirft ein Backend-Aussetzer Daten oder blockiert die App.
- Formen und Redaction. Rauschen filtern, sampeln und PII maskieren gehören in die Pipeline, nicht in den Code jedes Dienstes eingebacken.
- Backend-Flexibilität. Ein Backend ändern oder hinzufügen, indem Sie Collector-Config bearbeiten, nicht indem Sie jede Anwendung neu deployen.
- Die App entlasten. Export-Batching und Egress sind Aufgabe des Collectors, nichts, was auf dem kritischen Pfad Ihres Dienstes laufen sollte.
Das SDK-direkt-Muster tauscht all das gegen Einfachheit ein. Früh in Ordnung; im Massstab eine Belastung. Das ist dasselbe Thema wie wofür eine Telemetrie-Pipeline da ist — der Collector ist die Naht, die Instrumentierung und Backends unabhängig hält.
Kubernetes-Besonderheiten
Kubernetes macht zwei dieser Muster erstklassig:
- DaemonSet ist der native Weg, einen Agent pro Node zu bekommen — der Scheduler übernimmt Platzierung und Lifecycle für Sie.
- Der OpenTelemetry Operator verwaltet Collector-Deployments als CRD und kann Sidecars automatisch injizieren in annotierte Pods, plus SDK-Auto-Instrumentierung übernehmen. Er verwandelt “einen Collector deployen” in eine deklarative Ressource statt handgestrickter Manifeste.
Ein gängiges, sauberes Layout: ein Operator-verwaltetes DaemonSet für Node- und
Pod-Telemetrie, das an ein Gateway im Deployment-Modus für Sampling und Egress
weiterleitet — das Hybrid-Muster, ausgedrückt in zwei Kubernetes-Ressourcen. Wenn Sie den
Collector gegen Grafanas Agent abwägen, behandelt der Vergleich
Alloy vs. OpenTelemetry Collector diese
Wahl; beide passen in dieselben Topologien.
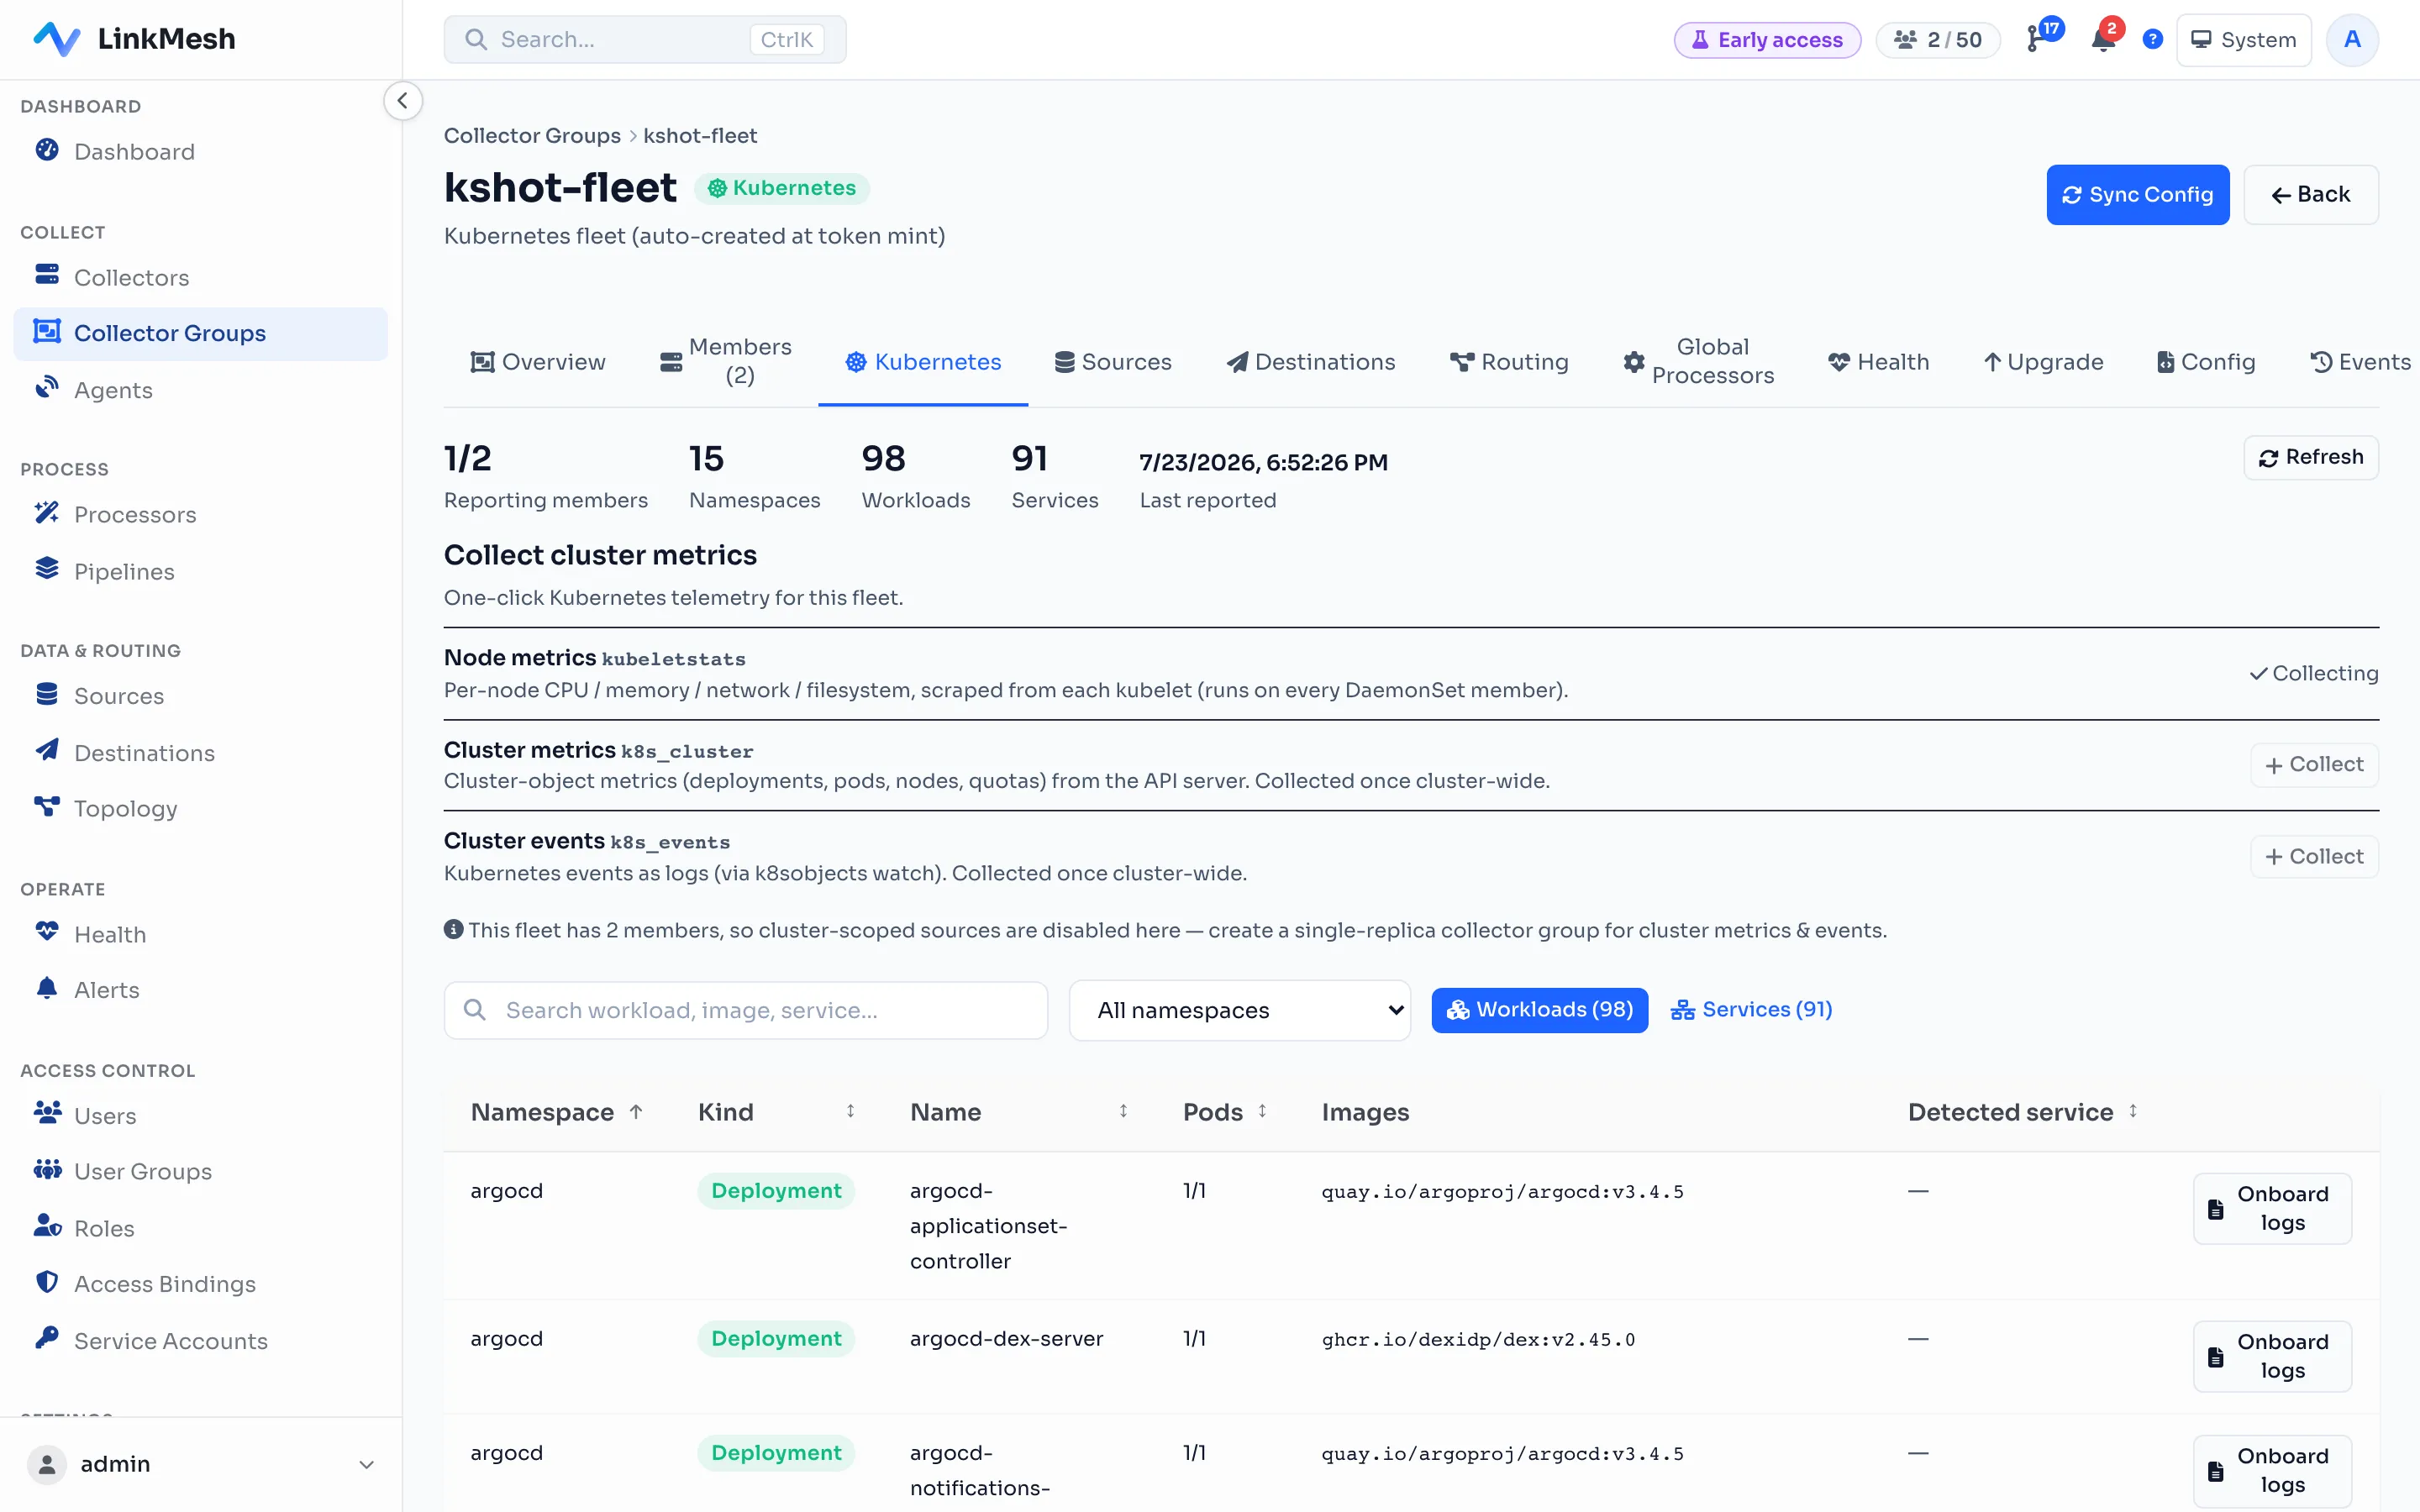
Sobald eine DaemonSet-Flotte läuft, kann eine Control Plane den Cluster lesen, in dem
sie lebt. In LinkMesh listet der Kubernetes-Tab der Flotte jeden Namespace, Workload
und Service auf, den die Agents entdeckt haben — und die Logs eines Workloads
anzubinden oder Node- und Cluster-Metriken einzuschalten ist ein Klick statt
handgeschriebener filelog-Globs und kubeletstats-Config:
Wählen, in einem Absatz
Beginnen Sie mit einem Agent (DaemonSet oder pro Host) — er ist der Default und deckt die meiste lokale Erfassung ab. Fügen Sie ein Gateway hinzu, wenn Sie Tail Sampling, zentralisierten Egress oder Backend-Fan-out brauchen; diese Kombination ist das Hybrid-Muster, und dort landen die meisten Unternehmen. Nutzen Sie ein Sidecar nur, wo Pro-Pod-Isolation eine echte Anforderung ist. Greifen Sie zu keinem Collector nur in Prototypen oder Serverless-Ecken, wo der Overhead sich wirklich nicht lohnt. Das Binary ist jedes Mal dasselbe — Sie wählen Platzierung, Blast Radius und wo die teure Arbeit läuft.
Welche Mischung Sie auch wählen, die operative Frage ist identisch: viele Collectors, eine konsistente Konfiguration, keine Drift. Das ist ein Flottenmanagement-Problem, und dort verdient eine Control Plane auf OpAMP ihr Geld — eine Stelle, um jeden Agent, jedes Sidecar und jedes Gateway zu konfigurieren und zu belegen, was auf jedem tatsächlich läuft.
Betreibt der Cluster regulierte Workloads, ist das Deployment-Muster die einfache Hälfte — was der Collector mit Namespaces, Pod-Logs und dem Audit-Log tut, steht in Kubernetes- und OpenShift-Observability in regulierter IT.
Jedes Muster hier vervielfacht sich zu einer Flotte, und eine Flotte braucht eine Source of Truth für Config. LinkMesh ist eine selbstgehostete OpAMP-Control-Plane, die Collector-Config für Ihre Agents, Sidecars und Gateways gleichermassen komponiert, validiert und verteilt — mit Durchsatz pro Edge und Version-für-Version-Audit, sodass Sie genau sehen, was jeder Node ausführt. Berechnet pro Collector, nicht pro GB. Stellen Sie eine auf in Minuten, oder sehen Sie, was sie kann.