
 LinkMeshObservability Data Collection Management
OpenTelemetry Collector Sizing
CPU folgt dem Durchsatz, RAM der Kardinalität – Sizing nach GB pro Tag trifft nur die halbe Wahrheit.
 Roman Hüsler← Zurück zum Blog
Fragen Sie fünf Personen, wie gross ein OpenTelemetry-Collector-Gateway sein muss, und vier werden in Gigabyte pro Tag antworten. Diese Zahl sagt fast nichts darüber aus, ob die Maschine in die Knie geht – denn die beiden Ressourcen, die ein Collector tatsächlich verbraucht, CPU und Arbeitsspeicher, werden von zwei unterschiedlichen Dingen getrieben, und nur eines davon ist der Durchsatz.
TL;DR — CPU skaliert mit dem Durchsatz: Spans, Log-Zeilen und Datenpunkte pro Sekunde. RAM skaliert mit der Kardinalität: der Anzahl eindeutiger aktiver Zeitreihen, die die Pipeline vorhält – und die hat keinen festen Bezug zur Datenmenge pro Sekunde. Ein Collector kann bei der CPU nahezu im Leerlauf sein und trotzdem am Speicher per OOM-Kill sterben. Die übliche Lösung – mehr Instanzen – löst das erste Problem, aber nicht das zweite, weil Round-Robin-Load-Balancing jede Instanz weiterhin fast der vollen Zeitreihenzahl aussetzt. Es folgt eine durchgerechnete Methode: reale Verhältniszahlen, eine vollständige Ableitung von diesen Zahlen zu VM-Grössen und Instanzanzahlen, benannte Reservefaktoren statt eines impliziten Puffers, Failover-Mathematik und eine Rescale-Regel mit konkreten Schwellenwerten.
Dies ist ein kleines, verallgemeinertes Kostenmodell – keine Zahlen eines bestimmten Kunden und kein Produkt eines bestimmten Anbieters: vier Formeln, vier benannte Reservefaktoren und die Rechenschritte, um aus einer nominalen Ingest-Rate VM-Grössen, Instanzanzahlen und Load-Balancer-Bandbreite abzuleiten. Passen Sie es auf Ihr eigenes Gateway an, statt eine einzelne Zahl hier als Konstante zu behandeln.
Warum die GB/Tag-Zahl Sie im Stich lässt
„Wie viele Gigabyte pro Tag” ist eine sinnvolle Frage für ein
Log-Storage-Budget. Für ein Collector-Gateway ist sie fast nutzlos, denn der
Speicherbedarf eines Collectors ist nicht proportional zur Datenmenge – er
ist proportional dazu, wie viele unterschiedliche Dinge gleichzeitig
verfolgt werden. Zehntausend Log-Zeilen pro Sekunde aus einer wohlerzogenen
Anwendung sind eine leichte Speicherlast. Zehntausend Datenpunkte pro
Sekunde, verteilt auf zweihunderttausend eindeutige Label-Kombinationen –
pod, container, endpoint, eine Kunden-ID, die sich in ein Label
verirrt hat – sind bei gleichem Durchsatz eine schwere.
Sizing nach GB/Tag beantwortet die CPU-Frage einigermassen gut und überspringt die Speicherfrage stillschweigend komplett. Genau in dieser Lücke wird ein unterdimensioniertes Gateway entdeckt – um 2 Uhr nachts, als OOM-Kill.
Die zwei Ressourcen, auf die es wirklich ankommt
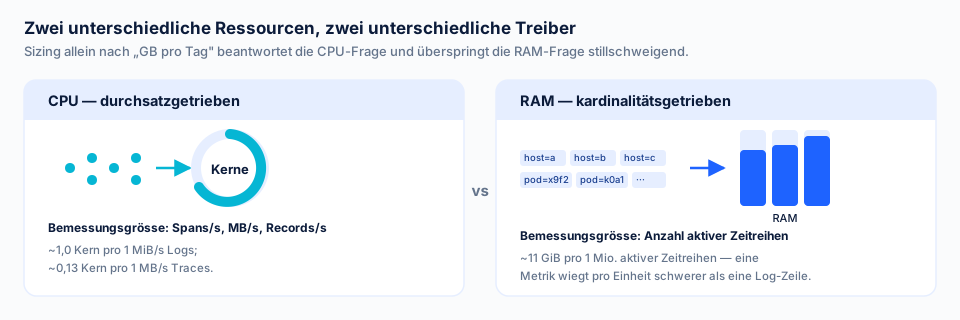
Ein praxistaugliches Set an Verhältniszahlen für das Sizing eines OTel-basierten Collector-Gateways, jeweils pro Einheit Durchsatz oder Kardinalität:
- Logs – etwa 1,0 CPU-Kern und 120 MiB RAM pro 1 MiB/s Ingest. Pro Byte CPU-lastiger als die anderen Signale, weil Log-Verarbeitung (Parsing, Regex, Multiline-Handling) CPU-Arbeit ist.
- Metriken – etwa 0,4 CPU-Kern und 11 GiB RAM pro 1 Million aktiver Zeitreihen. RAM-lastig, und zwar strukturell: Jede aktive Zeitreihe ist ein lebendes Objekt, für das die Pipeline den Zustand vorhalten muss, solange sie aktiv bleibt – unabhängig davon, wie oft sie abgefragt wird.
- Traces – etwa 0,13 CPU-Kern pro 1 MB/s Span-Daten; bei vergleichbarem Volumen auf beiden Achsen leichter als die anderen beiden Signale.
Vergleicht man die drei, springt eines sofort ins Auge: Metriken kosten pro Einheit „durchfliessendes Zeug” mehr als das Tausendfache an Speicher wie Logs. Eine Workload, die überwiegend aus Metriken besteht, wird speichergebunden sein, lange bevor sie CPU-gebunden ist – und eine Sizing-Übung, die nur nach „wie viele MB/s” fragt, wird die CPU richtig und den Speicher um eine Grössenordnung falsch bemessen.
Die Falle: horizontales Skalieren behebt die Kardinalität nicht
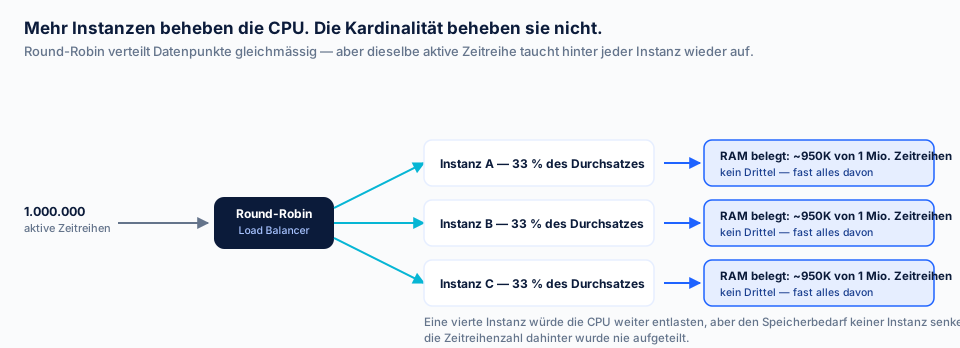
Das ist der Teil, der Leute erwischt, die die Verhältniszahlen gelesen und für eine einzelne Instanz korrekt bemessen haben – und dann beim Skalieren gegen eine Wand laufen. Der Reflex lautet: Der Speicher ist auf einer Maschine zu hoch, also stellen wir drei Maschinen hinter einen Load Balancer, und jede trägt ein Drittel der Last.
Für die CPU funktioniert das. Round-Robin verteilt einzelne Datenpunkte, nicht ganze Zeitreihen – und weil dieselbe Zeitreihe in fast jedem Scrape oder Batch wiederkehrt, sieht am Ende jede Instanz fast die volle Anzahl aktiver Zeitreihen, nicht einen Bruchteil davon. Drei Instanzen hinter einem Round-Robin-Balancer, jede für „ein Drittel der Metrik-Last” dimensioniert, nähern sich unabhängig voneinander alle dem Speicherbedarf der gesamten Workload an. Eine vierte Instanz entlastet die CPU weiter und bewirkt beim Speicher nichts, weil das Kardinalitätsproblem nie geteilt wurde – nur der Durchsatz.
Die praktische Lösung ist, den Traffic so zu routen, dass eine bestimmte Zeitreihe konsistent auf derselben Instanz landet (Consistent Hashing auf eine stabile Identität statt Round-Robin), sodass sich die Zeitreihenzahl tatsächlich über die Flotte aufteilt, statt über sie repliziert zu werden. Das ist ein anderes Sizing-Gespräch als „wie viele Maschinen” – und eines, das sich lohnt, bevor die Flotte wächst, nicht nach dem dritten OOM-Kill.
Von Verhältniszahlen zu Instanzen: ein durchgerechnetes Sizing-Modell
Mit vier Formeln werden aus den Verhältniszahlen pro Einheit vollständige VM-Zuschnitte. Jede Formel enthält einen benannten Reservefaktor statt einer versteckten Schätzzahl:
- CPU (Kerne) = Logs[MiB/s] × 1,0 × 1,5 (DLP-Overhead) + Traces[MB/s] × 0,13 + Serien[Millionen] × 0,4 + 1 (Baseline)
- RAM (GiB) = (Logs[MiB/s] × 0,12 + Traces[MB/s] × 0,17 + Serien[Millionen] × 11 + 2 (Baseline)) × 1,25 (Speicher-Headroom)
- Load-Balancer-Bandbreite = nominale Ingest-Rate × 8 (MB/s → Mb/s) × 1,5 (Burst-Reserve)
- Queue-Disk = Egress-Peak × Überbrückungszeit (bewusst konservative 90 Minuten) × 1,3 (Queue-Reserve)
Wendet man das auf fünf Ingest-Stufen an, ergibt sich ein kleines Set an Zuschnitten, in die eine Workload eingeordnet wird, statt jedes Mal von vorne zu bemessen:
| Stufe | Nominale Rate | vCPU / Instanz | RAM / Instanz | Queue-Disk | Instanzen | LB-Bandbreite |
|---|---|---|---|---|---|---|
| Default | 5 MB/s | 8 | 16 GiB | 40 GB | 2 | 60 Mb/s |
| Small | 10 MB/s | 16 | 32 GiB | 70 GB | 2 | 120 Mb/s |
| Medium | 20 MB/s | 24 | 64 GiB | 140 GB | 2 | 240 Mb/s |
| Big | 30 MB/s | 24 | 64 GiB | 210 GB | 3 | 360 Mb/s |
| Super | 50 MB/s | 24 | 128 GiB | 350 GB | 4 | 600 Mb/s |
Ein paar Dinge, die man aus der Tabelle lesen sollte, statt daran vorbeizulesen:
- Die vCPU- und RAM-Werte sind bewusst runde Zahlen – Zweierpotenzen, die Sie auf jeden beliebigen Instanzkatalog abbilden können, nicht die SKU-Liste eines bestimmten Anbieters. Verstehen Sie sie als Zuschnitte zum Einpassen, nicht als Einkaufsliste.
- Die Instanzanzahl folgt nicht einfach „mehr Durchsatz, mehr Maschinen”. Big und Super erhöhen die Instanzanzahl genauso stark wie die Grösse pro Instanz, weil eine einzelne Instanz ab einer gewissen Grösse einen grösseren Blast Radius bei einem Ausfall bedeutet – siehe N+1 weiter unten.
- Diese Tabelle bemisst CPU und Durchsatz. Sie teilt keine Kardinalität. Die Anzahl aktiver Zeitreihen einer Flotte schrumpft nicht, nur weil die Flotte mehr Instanzen hat – siehe die Falle oben. Ist die Kardinalität einer Workload für ihren Durchsatz ungewöhnlich hoch, wächst sie aus der RAM-Spalte dieser Tabelle heraus, bevor sie aus der CPU- oder Bandbreiten-Spalte herauswächst – und die Lösung ist Consistent-Hash-Routing, keine weitere Instanz.
Verstehen Sie die Formeln als Startpunkt der Ableitung, nicht als Ersatz für einen Lasttest der eigenen Workload – gerade die Kardinalität schwankt von Umgebung zu Umgebung enorm. Was die Tabelle bringt, ist ein gemeinsames Vokabular: „Diese Flotte ist ungefähr ein Medium” ist ein Satz, den ein ganzes Team benutzen kann – „gebt ihr so ungefähr 20 Gig, glaube ich” ist keiner.
Ihre Reservefaktoren benennen
In den meisten Sizing-Gesprächen steckt irgendwo ein impliziter Puffer – „wir runden mal ein bisschen auf” –, auf den später niemand mehr zeigen kann. Das Modell oben benennt stattdessen jeden einzelnen, damit eine Zahl geprüft statt nur geglaubt werden kann:
- DLP-Overhead (×1,5 auf den CPU-Logs-Term) – Headroom für inline durchgeführte Data-Loss-Prevention (Masking, Redaction) auf dem Log-Pfad; echte CPU-Arbeit, die die Basis-Verhältniszahl nicht enthält.
- Speicher-Headroom (×1,25 auf die gesamte RAM-Zahl) – der Abstand zwischen dem gesetzten Speicherlimit und dem tatsächlich benötigten Speicher, damit der Memory Limiter eingreifen kann, bevor es der OOM-Killer des Betriebssystems tut.
- Burst-Reserve (×1,5 auf die Load-Balancer-Bandbreite) – Headroom über dem Steady-State-Peak für Traffic-Spitzen, die normal sind, keine Vorfälle (ein Deploy-Sturm, ein Batch-Job zur vollen Stunde).
- Queue-Reserve (×1,3 auf die Queue-Disk) – Marge über der reinen Überbrückungszeit-Rechnung, weil ein Ausfall während einer Traffic-Spitze der Fall ist, der in der Praxis tatsächlich eintritt.
Vier benannte Zahlen statt einer vagen bedeuten: Wenn die Flotte sechs Monate später grösser ist als geplant, kann jemand fragen „welche Reserve wurde aufgebraucht”, statt das gesamte Sizing wieder von null herzuleiten.
N+1: was Failover wirklich kostet
Muss die Flotte den Ausfall einer Instanz überstehen, ohne Daten zu
verlieren, dimensionieren Sie für N+1, nicht für N. Bei n Instanzen,
die eine Workload tragen, übernehmen die verbleibenden n − 1 Instanzen im
Ausfallfall jeweils Peak ÷ (n − 1) der Gesamtlast – nicht Peak ÷ n, was
ein für den Steady State gebautes Spreadsheet standardmässig annimmt. Die
Instanzen-Spalte der Tabelle berücksichtigt das bereits: Big und Super
erhöhen die Instanzanzahl gezielt, damit die Failover-Rechnung überlebbar
bleibt, nicht nur um Durchsatz hinzuzufügen.
Je kleiner die Flotte, desto stärker schlägt das durch: Bei 3 Instanzen schiebt der Ausfall einer Instanz jede verbleibende von einem Drittel des Peaks auf die Hälfte. Bei 10 verschiebt sich das für jede Überlebende von einem Zehntel auf etwa ein Elftel – kaum spürbar. N+1-Sizing ist im grossen Massstab günstig und genau dort teuer, wo Teams versucht sind, es auszulassen: bei kleinen Flotten, wo „50 % zusätzliche Kapazität für Failover” im Verhältnis zum bereits Bereitgestellten wie eine grosse Zahl aussieht.
N+1 verteilt CPU und Durchsatz auf die verbleibenden Instanzen. Für den Speicher bewirkt es nichts. Die Anzahl aktiver Zeitreihen, die jede Überlebende unter Round-Robin bereits gehalten hat, ändert sich nicht, wenn eine Instanz ausfällt – weil sie von Anfang an nie durch die Instanzanzahl geteilt wurde. Die Kardinalitäts-Warnung von oben gilt für den Failover-Fall genauso wie für den Steady State.
Die Queue für Backend-Ausfälle dimensionieren
Dimensionieren Sie die Export-Queue eines Collectors in Zeit, die Sie überbrücken können, nicht in einer willkürlichen Anzahl Einträge. Das Modell oben verwendet eine bewusst konservative Überbrückungszeit von 90 Minuten: Queue-Disk = Egress-Peak × 90 Minuten × 1,3 (Queue-Reserve). Eine Queue, die am durchschnittlichen statt am Peak-Durchsatz bemessen ist, ist eine Queue, die genau unter den Bedingungen versagt, die einen Ausfall noch schlimmer machen – bemessen Sie sie am Peak und legen Sie die Reserve obendrauf.
Ein Rescale-Regelwerk statt „behalten wir mal im Auge”
Das Sizing oben beantwortet „wie gross heute”. Die operative Hälfte besteht darin zu wissen, wann die heutige Grösse nicht mehr reicht – und das funktioniert nur mit fest vorab entschiedenen Schwellenwerten:
- Skalieren, wenn: der Speicher über ein definiertes Zeitfenster hinweg (nicht bei einem einzelnen Spike) über der Ziel-Auslastung liegt, oder die Anzahl aktiver Zeitreihen in die nächsthöhere Stufe der Tabelle oben wechselt.
- Vor, nicht nach einem bekannten Ereignis skalieren: ein grosses Onboarding, ein neu angebundener Kubernetes-Cluster, ein Black-Friday-artiges Traffic-Muster – alles mit einem bekannten Kardinalitäts- oder Durchsatzsprung wird vorab dimensioniert, nicht nachträglich beantwortet.
- Auf den Frühindikator alarmieren, nicht auf den Ausfall: Ein auf das Limit zulaufender Speicher ist das Signal; der OOM-Kill ist das, was das Signal verhindern soll – nicht der Anlass, endlich hinzuschauen.
Welche Zahlen für eine bestimmte Flotte tatsächlich gelten, ist zweitrangig – sie als Schwellenwerte schriftlich festzuhalten, statt „wir merken es schon, wenn es schlimm wird” als Plan stehen zu lassen, macht aus Sizing eine operative Praxis statt einer einmaligen Übung.
Betriebshygiene, die in dieser Grössenordnung zählt
Drei Gewohnheiten zählen genauso viel wie die Rechnerei oben, und alle drei folgen aus derselben Tatsache: Die Ressource unter echtem Druck meldet sich selten als „über Budget” – sie zeigt sich als Latenz oder als Kill, wenn die Limits nicht bereits entschieden und getestet sind.
- Kein hartes CPU-Limit setzen. Ein CPU-Limit versagt nicht laut – es drosselt, und Drosselung sieht wie Tail-Latenz aus, was sich viel schwerer auf „unterdimensioniert” zurückführen lässt als ein sauberer Fehler.
GOMEMLIMITauf etwa 80 % des Speicherlimits setzen. Das gibt dem Garbage Collector der Go-Runtime Raum einzugreifen, bevor es der OOM-Killer des Betriebssystems tut – der Unterschied zwischen einer kontrollierten Verlangsamung und einem harten Kill.- Vor jedem Produktivgang mit dem 2- bis 3-Fachen des erwarteten Peaks lasttesten. Die Formeln oben sind eine erste Ableitung; der Lasttest bestätigt, ob die Reservefaktoren für die tatsächliche Burstiness einer konkreten Workload ausreichen.
Wo LinkMesh ansetzt
Nichts von der Methode oben braucht ein bestimmtes Produkt – es ist Mathematik und gemessene Verhältniszahlen, und sie funktioniert, ob Sie einen Collector von Hand betreiben oder tausend über einen Fleet-Manager. Wo eine zentrale Control Plane ihren Platz verdient, ist nach der Sizing-Entscheidung: Wissen Sie, dass eine Flotte etwa ein Medium-Deployment hinter Consistent-Hash-Routing wird, verteilt LinkMesh diese Konfiguration von einer Stelle aus auf jede Instanz, und die Fleet-Health-Ansicht zeigt Ihnen die realen Werte für CPU, Speicher und Durchsatz pro Instanz, die dieser Artikel Sie zu beobachten gebeten hat – und genau das verrät Ihnen, ob die N+1-Reserve gerade aufgebraucht wird, statt es aus einem Incident zu erfahren.
Betreiben Sie bereits eine nach Gefühl dimensionierte Collector-Flotte, ist der schnellste Weg herauszufinden, ob sie eine Stufe zu klein ist, ein Blick darauf, was sie tatsächlich vorhält: Werfen Sie einen Blick auf die Fleet-Ansicht von LinkMesh für Ihre eigenen Collectors und prüfen Sie reale Zahlen gegen die Tabelle oben – statt gegen eine GB/Tag-Schätzung.
Für die Fleet-Management-Seite davon – die getroffene Sizing-Entscheidung konsistent auszurollen – zeigt Bindplane vs LinkMesh: Where Your Control Plane Runs, wie sich die Config-out-Hälfte der Aufgabe vergleicht. Für die Kostenseite derselben Zahlen deckt Observability-Kosten senken ab, wie Filtern und Sampling reduzieren, wofür Sie überhaupt erst dimensionieren müssen.
Quellen: Estimating collector resource usage und Scaling a central telemetry gateway: capacity planning, load testing and production lessons – die CPU/RAM-Verhältniszahlen und Betriebspraktiken oben sind aus veröffentlichter Forschung zu einem weit verbreiteten OTel-kompatiblen Collector übernommen; die Stufentabelle, die Formeln und die Reservefaktoren sind die eigene Ableitung dieses Beitrags.