
 LinkMeshObservability Data Collection Management
Was OTel ersetzen kann (und was nicht)
Die ehrliche Grenze zwischen Pipeline und Backend.
 Philippe Braxmeier← Zurück zum Blog
Lesen Sie genug Migrations-Blogposts, und Sie würden denken, OpenTelemetry einzuführen bedeutet, Ihren Observability-Anbieter zu löschen. Das tut es nicht – und Teams, die es glauben, entdecken die Lücke auf die harte Tour, meist wenn ein Dashboard eine Woche nachdem sie den alten Agent deinstalliert haben, leer wird. OpenTelemetry ist transformativ, aber nur, wenn Sie präzise darüber sind, was es tatsächlich ist.
OpenTelemetry ist ein Standard zum Produzieren, Sammeln und Transportieren von Telemetrie. Es ist kein Observability-Backend: Es speichert keine Daten, indexiert sie nicht, führt keine Query-Sprache aus, zeichnet keine Dashboards und wertet keine Alert-Regeln aus. Die ehrliche Einordnung jeder OTel-Migration lautet also: Ersetzen Sie die linke Seite der Pipeline, behalten oder bauen Sie die rechte Seite neu. Dieser Leitfaden zieht diese Grenze klar, sodass Sie eine Migration zuschneiden können, die nichts dunkel lässt.
Jeder, der plant, OpenTelemetry einzuführen oder von einem proprietären Agent wegzumigrieren – Platform-/SRE-Teams und Architekten, die vor Beginn der Arbeit realistische Erwartungen mit Stakeholdern setzen müssen. Lesen Sie zuerst dies, greifen Sie dann zu den anbieterspezifischen Playbooks. Voraussetzungen: keine; dies ist die konzeptionelle Landkarte.
Die drei Schichten, die OpenTelemetry tatsächlich standardisiert
OTel ersetzt die Teile des Stacks, die früher proprietär und an einen Anbieter geschweisst waren:
- Instrumentierung – OTel-SDKs und Zero-Code-Auto-Instrumentierung produzieren Spans, Metriken und Logs in einer anbieterneutralen Form und ersetzen das SDK eines Anbieters.
- Sammeln – der OTel Collector empfängt, verarbeitet und exportiert Telemetrie und ersetzt den Agent eines Anbieters.
- Das Wire-Format – OTLP ist ein offenes Protokoll für alle drei Signale und ersetzt das proprietäre Protokoll eines Anbieters.
Alles nachgelagert von OTLP – Speicherung, Indexierung, Query, Visualisierung, Alerting, Analytics – ist die Aufgabe des Backends, und OTel tut es bewusst nicht. Das ist keine Lücke in OpenTelemetry; es ist die Grenze, die es zu einem Standard statt zu einem Produkt macht.
Was OpenTelemetry ersetzt – die ehrliche Matrix
Hier ist die Grenze, Fähigkeit für Fähigkeit. „Meist“ heisst, es funktioniert für die meisten Teams mit Validierung; „Teilweise“ heisst, ein Teil davon wandert und ein Teil nicht; „Nein“ heisst, es ist schlicht nicht das, was OTel tut.
| Fähigkeit | Zu OTel verschieben? | Was es in der Praxis bedeutet |
|---|---|---|
| Host- & Infrastruktur-Metriken | Meist | hostmetrics / kubeletstats decken das Standard-Set ab; validiere anbieterspezifische Metriken. |
| Anwendungs-Traces | Meist | OTel-SDKs / Auto-Instrumentierung emittieren OTLP; die Instrumentierungstiefe kann von einem proprietären Agent abweichen. |
| Log-Sammlung & -Weiterleitung | Oft | filelog / journald sammeln; Parsing- und Routing-Regeln müssen als Processors neu erstellt werden. |
| Custom-/StatsD-Metriken | Meist | statsd- und Prometheus-Receiver nehmen die meisten Custom-Metriken auf. |
| PII-Redaktion & Datenformung | Ja | transform- / redaction- / filter-Processors – oft besser als ein geschlossener Agent und vor dem Egress. |
| Ressourcen-Attribution / Tagging | Ja | resource- / k8sattributes-Processors setzen service.name, Umgebung, Ownership. |
| Dashboards | Nein | Im neuen Backend neu bauen oder das alte behalten. Keine OTel-Angelegenheit. |
| Alerting / Monitore | Nein | Alert-Regeln leben im Backend; migriere sie separat. |
| RUM / Session-Replay | Meist nicht | OTel hat Browser-/Mobile-Signale, aber keine Feature-Parität mit Anbieter-RUM. |
| Continuous Profiling | Aufkommend | OTel-Profiling ist jung; behandeln Sie Anbieter-Profiler als noch nicht ersetzt. |
| Service-Topologie / Abhängigkeitskarten | Teilweise | Aus Traces ableitbar, aber auto-entdeckte proprietäre Karten übertragen sich nicht 1:1. |
| KI-Root-Cause / Anomalie-Analytics | Nein | Anbieter-Analytics (Davis, Watchdog usw.); das neue Backend liefert seine eigenen, falls überhaupt. |
| Network-Performance-Monitoring | Meist nicht | eBPF/anbieterspezifisch; keine OTel-native Fähigkeit. |
| Backend-Speicherung & Query-Sprache | Nein | OTel ist kein Backend – hier lebt echtes Rest-Lock-in. |
Das Muster hinter der Matrix
Betrachte die „Ja/Meist“-Zeilen gegenüber den „Nein“-Zeilen, und eine saubere Trennung wird sichtbar: OpenTelemetry besitzt alles bis einschliesslich der Leitung und nichts dahinter. Deshalb ist es ein so gutes Geschäft – die Schicht, die es ersetzt (Agents, SDKs, Protokoll), ist genau die Schicht, deren Wechsel früher am teuersten war, weil sie auf jedem Host deployt und in jedem Service eingebettet war.
Die „Nein“-Zeilen sind real, und etwas anderes vorzugeben, ist der Fehler. Aber beachte, welche Art von Arbeit sie sind: Ein Dashboard neu zu bauen oder einen Alert neu zu verfassen ist portabler Aufwand – Sie machen es einmal, in einem Backend, das Sie gewählt haben, und Sie sind nie wieder daran gehindert zu gehen. Vergleichen Sie das mit dem Neu-Instrumentieren von tausend Services, was die Wand war, die Sie zuvor eingesperrt hielt. OTel eliminiert keine Wechselkosten; es verwandelt eine technische Unmöglichkeit in einen Projektplan.
Wie man eine Migration so zuschneidet, dass nichts dunkel wird
Der Fehlermodus ist, den alten Agent zu deinstallieren, bevor Sie eine „Nein“-/„Teilweise“-Fähigkeit berücksichtigt haben, von der Sie tatsächlich abhingen. Vermeiden Sie ihn mit einer einfachen Disziplin:
- Inventarisieren Sie, was Sie tatsächlich nutzen. Nicht, was der Anbieter anbietet – was Ihr Team während eines Vorfalls öffnet. Dashboards, die drei Alerts, die Sie pagen, die Topologie-Ansicht, RUM, falls Sie sich wirklich darauf verlassen.
- Klassifizieren Sie jedes gegen die Matrix. Sammelschicht-Elemente wandern zu OTel; Backend-Schicht-Elemente werden neu gebaut oder behalten.
- Dual-Run. Halten Sie den Bestand am Leben, während OTel parallel ausgerollt wird, und validieren Sie die Parität, bevor Sie irgendetwas abschalten. (Jedes Anbieter-Playbook unten führt dies durch.)
- Behalten Sie bewusst. Wo eine Fähigkeit nicht wandert – RUM, Synthetics, Profiling –, entscheiden Sie bewusst, ein Tool genau dafür zu behalten, es zu ersetzen oder es fallen zu lassen. „Vergessen“ ist keine Entscheidung.
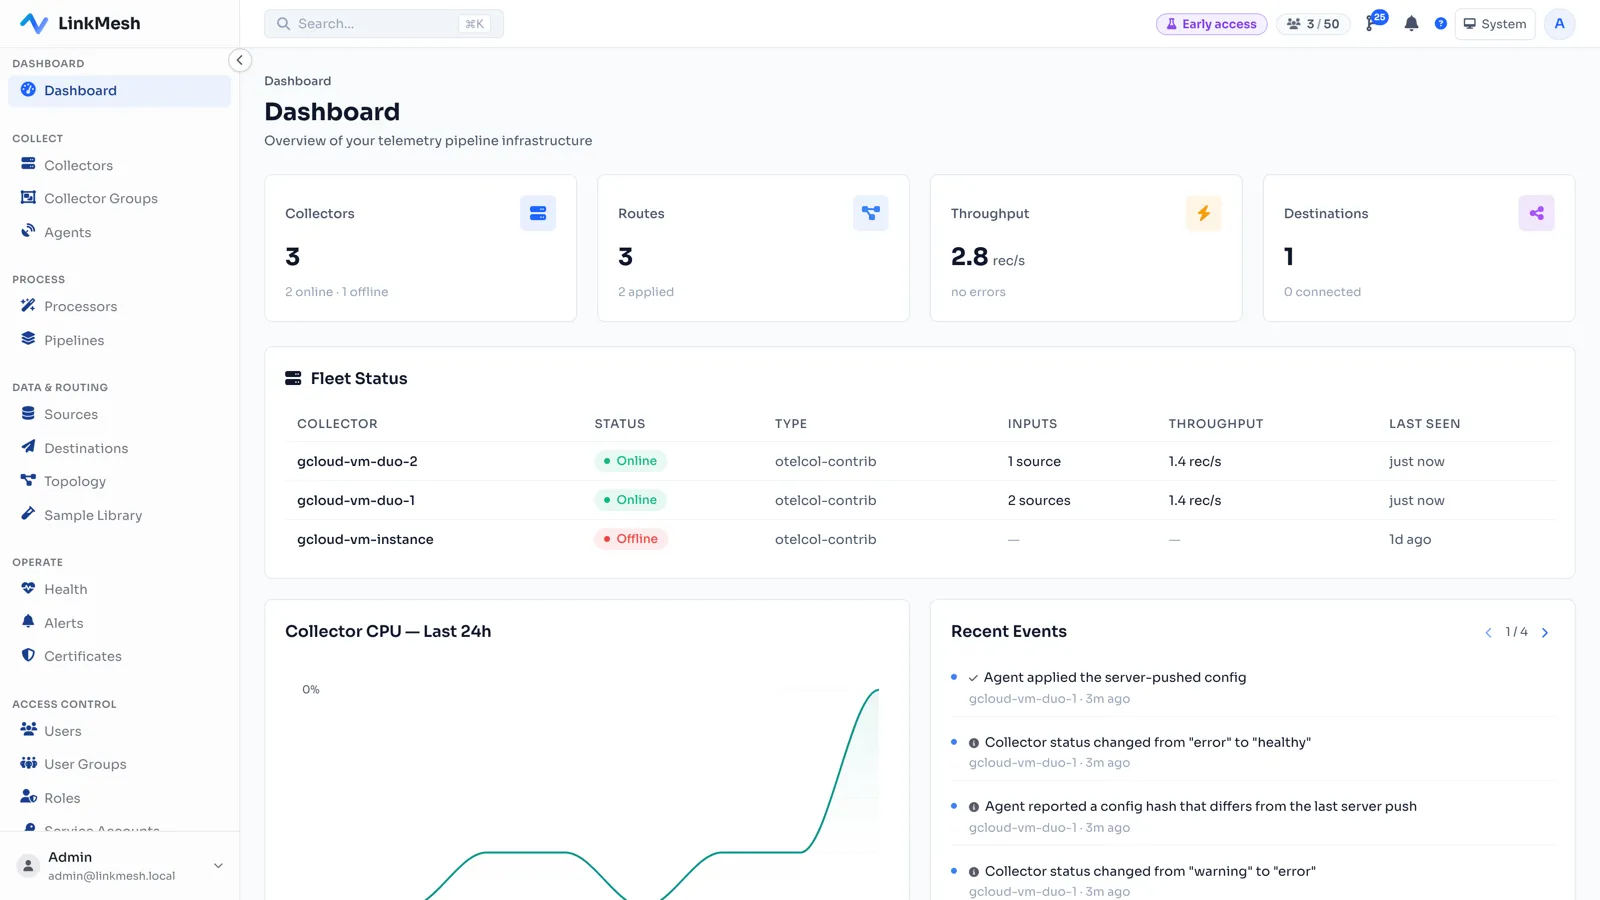
Das ist auch der Punkt, an dem sich eine Control Plane ihren Platz verdient: Sie verwaltet die Sammelschicht, die OTel tatsächlich ersetzt, sodass der Teil, den Sie migrieren, im grossen Massstab tatsächlich betreibbar ist.
Wo das hineinpasst
Wenn die Sammelschicht das ist, was OTel ersetzt, sind die nächsten Fragen, wie man sie betreibt und wie man seinen aktuellen Anbieter verlässt:
- Anbieter-Lock-in mit OpenTelemetry reduzieren – der strategische Fall.
- OpenTelemetry-Architektur für Unternehmen – wie die Agent-/Gateway-/Control-Plane-Teile zusammenpassen.
- Anbieter-Playbooks: Datadog, Dynatrace, Splunk Enterprise, New Relic, Elastic Agent.
OpenTelemetry wird Ihre Dashboards nicht neu bauen und die Analytics Ihres Backends nicht ersetzen – und ein Leitfaden, der Ihnen etwas anderes erzählt, verkauft Ihnen etwas. Was es tut, ist, Ihnen die Sammelschicht als offenen Standard in die Hand zu geben, den Sie besitzen – das eine Ding, das Ihr Backend von einer lebenslangen Strafe in eine Wahl verwandelt.
Auf der Anwendungsseite ist der Java Agent das Artefakt, das den Grossteil des Ersetzens leistet — mit Standardwerten, die vor dem Go-live geändert gehören: Der OpenTelemetry Java Agent in Produktion.
Diese Schicht – eine Flotte von OpenTelemetry Collectors – muss immer noch gebaut, validiert und betrieben werden. LinkMesh ist genau dafür eine selbst gehostete Control Plane: Pipelines komponieren, Config über OpAMP pushen und Durchsatz auf jeder Kante sehen. Pro Collector bepreist, nicht pro Gigabyte. Richten Sie eines ein in Minuten, oder sehen Sie sich an, was es kann.