
 LinkMeshObservability Data Collection Management
Dual-Shipping ohne Duplikate
An zwei Backends gleichzeitig senden — einmal zählen.
 Roman Hüsler← Zurück zum Blog
Jede sorgfältige Observability-Migration durchläuft eine Phase, in der Telemetrie gleichzeitig an zwei Backends fliesst: den Platzhirsch, den Sie verlassen, und den OpenTelemetry-Stack, zu dem Sie wechseln. Es ist das Richtige — so beweisen Sie Parität, bevor Sie irgendetwas abschalten. Aber es ist auch der Punkt, an dem sich die Rechnung still verdoppelt und, schlimmer, an dem die beiden Systeme anfangen, sich über grundlegende Zahlen uneinig zu sein, weil eines dieselben Daten doppelt zählt.
Dual-Shipping (manchmal „Dual-Write” oder „Shadow Shipping”) ist im Prinzip einfach und in der Praxis voller Fallen. In diesem Leitfaden geht es darum, es sauber zu machen: eine Pipeline, zwei Exporter, keine doppelt gezählten Hosts, keine duplizierten Logs und ein klares Signal dafür, wann das Überlappungsfenster enden sollte.
Platform Engineers und SREs, die eine Migration oder Backend-Evaluierung durchführen und beide Systeme lange genug live brauchen, um sie zu vergleichen — ohne Host-Zahlen aufzublähen, Metrik-Volumen zu verdoppeln oder doppelt für das Vergnügen zu zahlen. Voraussetzungen: ein OpenTelemetry Collector im Pfad (oder ein Plan für einen) und zwei Ziele, die Sie vergleichen wollen.
Warum überhaupt Dual-Shipping
Es gibt nur ein paar gute Gründe, zwei Backends parallel zu betreiben, und sie drehen sich alle darum, eine Änderung zu entrisiken:
- Migrations-Validierung. Bevor Sie dem neuen Stack vertrauen, wollen Sie dieselben Dashboards, dieselben Alert-Schwellen und dieselben Zahlen an beiden Stellen sehen. Parität, die Sie beobachten können, schlägt Parität, die Sie annehmen.
- Schrittweiser Cutover. Verschieben Sie Dashboards und Alerts nach und nach auf das neue Backend, während das alte noch funktioniert, sodass eine Lücke im neuen Setup nie bedeutet, dass Sie blind sind.
- Backend-Evaluierung. Zwei Ziele ehrlich zu vergleichen bedeutet, ihnen identischen Input über dasselbe Fenster zuzuführen, nicht zwei verschiedene Samples.
Der gemeinsame Faden: Dual-Shipping ist ein temporärer, bewusster Zustand, der existiert, um Vertrauen aufzubauen, und dann endet. Behandeln Sie es als dauerhaft, und es wird zu doppelten Kosten und doppelter operativer Oberfläche ohne fortlaufenden Nutzen. Zur strategischen Einordnung der Migration selbst siehe was OpenTelemetry ersetzen kann und was nicht und die Datadog- und Splunk-Enterprise-Playbooks.
Die Fallen: wie Dual-Shipping doppelt zählt
Die Gefahr ist nicht, an zwei Stellen zu senden. Es ist, dasselbe Signal durch zwei unabhängige Erfassungspfade zu senden, sodass jedes Backend — und oft Ihr Billing — es zweimal sieht.
- Zwei Agents auf einem Host. Der klassische Fehler: Lassen Sie den alten Vendor-Agent laufen und deployen Sie einen Collector auf demselben Host, beide senden Host-Metriken. Jetzt meldet sich jeder Host doppelt. Backends, die pro überwachtem Host abrechnen, zählen diesen Host doppelt, und Ihre Infrastruktur-Dashboards zeigen die doppelte Flotte.
- Metriken doppelt gezählt. Wenn beide Pfade denselben Prometheus-Endpoint scrapen oder
beide
hostmetricssenden, werden kumulative Counter und Gauges doppelt ingestiert. Rates sehen innerhalb jedes Backends richtig aus, aber Volumen (und Kosten) ist verdoppelt, und jede Cross-Backend-Abstimmung ist um den Faktor 2 daneben. - Logs dupliziert. Zwei Log-Agents, die dieselbe Datei tailen, verschicken jede Zeile doppelt. Wenn sie später zusammenlaufen — etwa beide an ein gemeinsames Kafka-Topic oder einen einzelnen Index weiterleiten —, bekommen Sie duplizierte Log-Events, die Zählungen und dedup-sensible Alerts zerstören.
- Traces falsch aufgefächert. Spans durch zwei separate SDK-Export-Pfade zu senden kann zwei Kopien desselben Traces mit unterschiedlichen Resource-Attributen erzeugen, sodass Span-Zählungen und Service-Maps sich zwischen Backends uneinig sind.
Die Grundursache ist in jedem Fall zwei Erfassungspfade für eine Quelle. Der Fix ist ein Pfad, der sich am Ende auffächert.
Sauber Dual-Shipping: eine Pipeline, zwei Exporter
Der OpenTelemetry Collector ist genau dafür gebaut. Erfassen Sie jede Quelle einmal, verarbeiten Sie sie einmal und fächern Sie dann am Ende einer einzelnen Pipeline zu zwei Exportern auf. Dieselben Daten, dieselbe Verarbeitung, an zwei Ziele geliefert — einmal gezählt, weil sie einmal erfasst wurden.
receivers:
  hostmetrics:
    collection_interval: 30s
    scrapers:
      cpu:
      memory:
      filesystem:
      network:

processors:
  resourcedetection:
    detectors: [env, system]
  batch:
    send_batch_size: 8192
    timeout: 5s

exporters:
  # Incumbent backend (leaving)
  datadog:
    api:
      key: ${env:DD_API_KEY}
  # New OpenTelemetry-native backend (arriving)
  otlphttp/grafana:
    endpoint: https://otlp-gateway.example.net
    headers:
      # Grafana Cloud expects Basic auth: base64(instance_id:api_token)
      authorization: "Basic ${env:GRAFANA_OTLP_AUTH}"

service:
  pipelines:
    metrics:
      receivers: [hostmetrics]
      processors: [resourcedetection, batch]
      exporters: [datadog, otlphttp/grafana]
Die Schlüsselzeile ist exporters: [datadog, otlphttp/grafana]. Eine receivers-Liste, eine
processors-Liste, zwei Exporter. Der Host wird einmal gescrapet, also zählt er einmal; die
Metriken werden einmal gebatcht, also ist das Volumen auf beiden Seiten identisch; und jeder
Record, der ein Backend erreicht, erreicht das andere, was den Vergleich gültig macht.
Die Metrik-Doppelzählung vermeiden
Der mit Abstand teuerste Fehler ist, den alten Agent und den Collector nebeneinander laufen zu lassen, beide dieselben Host-Metriken sendend. Tun Sie das nicht. Wählen Sie einen Erfassungs-Agent pro Host und lassen Sie ihn auffächern. Konkret:
- Nehmen Sie die Metrik-Erfassung des alten Agents ausser Betrieb, wenn der Collector übernimmt. Wenn das Platzhirsch-Backend während der Überlappung weiter Host-Metriken empfangen soll, sende sie vom Exporter des Collectors — nicht von einem zweiten Agent.
- Ein Scrape pro Prometheus-Target. Wenn der Collector ein Target scrapet, scrape es nicht
zusätzlich von einem Legacy-Prometheus. Zwei Scraper an einem
/metrics-Endpoint verdoppeln die Series. - Tail jede Log-Datei nur von einem Agent. Verschieben Sie die
filelog-Erfassung in den Collector und stoppen Sie den alten Log-Shipper auf diesem Pfad, sodass keine Zeile zweimal gelesen wird.
Zielspezifische Unterschiede (ein Backend braucht andere Resource-Attribute, oder eines will
nur Errors) können Sie mit dem filter-Processor oder dem routing-Connector routen — immer
noch vom einzelnen Erfassungspfad gespeist —, sodass Sie keinen zweiten Erfassungs-Agent
brauchen, um jedem Backend andere Daten zu senden.
Das Überlappungsfenster kurz halten
Dual-Shipping ist ein Kostenmultiplikator und eine operative Steuer, solange es läuft: zwei Sätze Egress, zwei Rechnungen, zwei Dinge, die gesund zu halten sind. Der Sinn ist, genug Belege zu sammeln, um dem Cutover zu vertrauen, nicht beide für immer zu betreiben. Disziplin hier:
- Legen Sie das Fenster fest, bevor Sie beginnen. „Zwei Wochen, die einen vollen Abrechnungs- zyklus und eine On-Call-Rotation abdecken” ist ein Plan. „Bis wir ein gutes Gefühl haben” ist keiner.
- Definieren Sie Parität explizit. Welche Dashboards, welche Alerts, welche Zahlen innerhalb welcher Toleranz übereinstimmen müssen. Schreiben Sie die Checkliste zuerst.
- Cutover ein Signal nach dem anderen. Metriken erreichen vielleicht Parität vor Logs. Stoppen Sie das Dual-Shipping eines Signals in dem Moment, in dem seine Checkliste grün ist, statt auf alle drei zu warten.
Entscheiden, wann Schluss ist
Sie sind mit dem Dual-Shipping eines Signals fertig, wenn das neue Backend die Dashboards und Alerts reproduziert, die Sie während eines Incidents tatsächlich nutzen, die Zahlen innerhalb der Toleranz übereinstimmen und Ihr Team reflexartig zum neuen Backend greift. An diesem Punkt entfernen Sie den Platzhirsch-Exporter aus der Pipeline, bestätigen, dass das neue Backend weiterhin alles empfängt, und erst dann nehmen Sie den alten Agent ausser Betrieb und hörst auf, für den alten Ingest zu zahlen. Den zweiten Exporter „nur für den Fall” drinzulassen, ist der Weg, wie aus einer temporären Überlappung eine dauerhafte Doppelrechnung wird — und die Kostenarbeit aus Observability-Kosten senken ist zunichtegemacht, bevor sie beginnt.
Weil der ganze Sinn der Übung Vertrauen ist, hilft es, zu sehen, dass beide Routen dasselbe Volumen tragen. Wenn der Durchsatz pro Edge auf den beiden Exportern einander folgt, wissen Sie, dass die Auffächerung treu ist; wenn einer hinterherhinkt, haben Sie ein Lieferproblem gefunden, bevor es zu einem Paritäts-Rätsel wird.
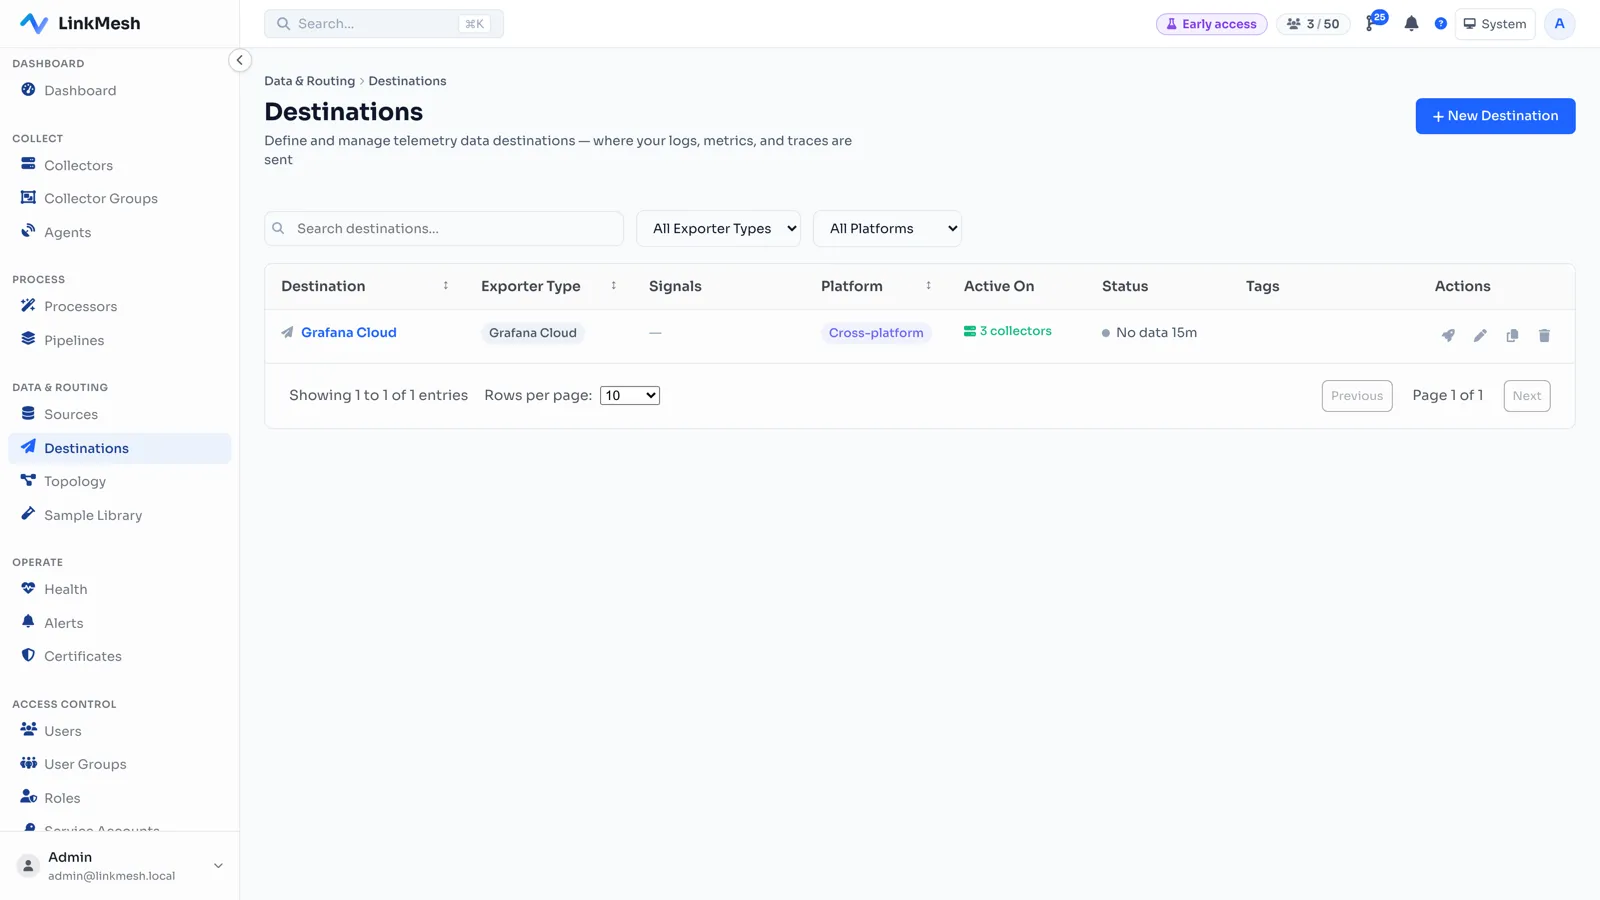
LinkMesh stellt eine validierte Pipeline zusammen und fächert sie aus einem einzelnen Erfassungspfad an mehrere Ziele auf — Grafana Cloud, Loki, Prometheus, Datadog, Kafka — mit Durchsatz pro Edge auf jeder Route, sodass Sie bestätigen können, dass beide Backends dasselbe Volumen sehen. Selbst gehostet, pro Collector bepreist. Jetzt loslegen in Minuten, oder ansehen, was es kann.