
 LinkMeshObservability Data Collection Management
Storage-Monitoring mit OTel
Die 10 Metriken, die zählen – Kapazität, Performance, Health – aus einem Collector.
 Roman Hüsler← Zurück zum Blog
Storage ist der Ort, an dem sich Ausfälle verstecken. Ein Volume läuft voll und eine Datenbank geht in den Read-only-Modus; eine Disk beginnt zu versagen und Latenz kaskadiert durch jeden Service auf ihr; ein Snapshot-Zeitplan frisst still das Array. Nichts davon ist dramatisch, bis es das ist – und Storage-Monitoring ist meist die fragmentierteste Ecke des Stacks, aufgeteilt über Array-Konsolen, Pro-Host-Tools, Cloud-Dashboards und eine Tabellenkalkulation.
Sie können es mit demselben OpenTelemetry Collector zusammenführen, den Sie ohnehin schon für alles andere betreiben. Nachfolgend stehen die 10 Storage-Metriken, die es wert sind, verfolgt zu werden – gruppiert in Kapazität, Performance und Health – und wie man jede von Servern und Storage-Arrays in ein Backend (Grafana oder irgendetwas OTLP) sammelt, mit Alerting über die gesamte Flotte.
Platform-, Sysadmin- und Infrastruktur-Teams, die für Storage auf Servern, VMs und Arrays zuständig sind und eine konsolidierte, anbieterneutrale Sicht statt einer Konsole pro Anbieter wollen. Voraussetzungen: ein OpenTelemetry Collector auf Ihren Hosts (oder ein Gateway) und ein Metrik-Backend wie Prometheus/Mimir + Grafana.
Die Storage-Monitoring-Matrix
Zehn Metriken beantworten die Fragen, die Sie tatsächlich alarmieren. Jede bildet auf etwas ab,
das der OpenTelemetry Collector sammeln kann – meist die disk- und filesystem-Scraper des
hostmetrics-Receivers, mit einem prometheus- oder snmp-Receiver für physische Health und
Arrays.
| # | Metrik | Warum sie zählt | Woher OTel sie bekommt |
|---|---|---|---|
| 1 | Belegte Kapazität % | Die klassische Ausfallursache – voll = read-only oder Absturz. | hostmetrics filesystem |
| 2 | Freier Speicher & Zeit bis voll | Der Trend schlägt den Schwellenwert; sagen Sie die Wand voraus, bevor Sie sie treffen. | hostmetrics filesystem (Rate) |
| 3 | Inode-/Metadaten-Nutzung | Läuft bei Workloads mit vielen kleinen Dateien vor den Bytes leer. | hostmetrics filesystem inodes |
| 4 | IOPS (read/write) | Die Einheit, nach der die meisten Arrays und Cloud-Disks provisioniert sind. | hostmetrics disk operations |
| 5 | Durchsatz (read/write) | Bytes/Sek. – Bandbreitensättigung und Backup-Fenster. | hostmetrics disk io |
| 6 | I/O-Latenz | Die Zahl, die aus „langsame App“ ein „langsame Disk“ macht. | abgeleitet aus disk operation_time |
| 7 | Queue-Tiefe | Ausstehende I/O – das frühe Zeichen der Sättigung. | hostmetrics disk pending_operations |
| 8 | Disk-Auslastung / Sättigung | % der Zeit, in der das Gerät beschäftigt ist. | hostmetrics disk io_time |
| 9 | Disk-Health / SMART | Sagt physisches Versagen voraus, bevor es Daten kostet. | smartctl_exporter via prometheus-Receiver |
| 10 | Array-/RAID-Zustand | Degradiertes RAID oder Array-Controller = ein Ausfall von Datenverlust entfernt. | snmp-Receiver / Anbieter-Exporter |
Kapazität — Metriken 1–3
Der hostmetrics-filesystem-Scraper deckt die Kapazität für jedes gemountete Volume ab,
einschliesslich der Inode-Nutzung:
receivers:
  hostmetrics:
    collection_interval: 30s
    scrapers:
      filesystem:
        metrics:
          system.filesystem.utilization:
            enabled: true      # % used per mount, not just bytes
      disk:
Das gibt Ihnen system.filesystem.usage (Bytes nach state=used|free|reserved),
system.filesystem.utilization (der %-Wert, auf den Sie alarmieren) und
system.filesystem.inodes.usage (Metrik 3 – die, die Fileserver vor den Bytes beisst). Zeit
bis voll (Metrik 2) ist keine rohe Metrik; sie ist eine Query – extrapoliere den
Freiraum-Trend in Ihrem Backend (z. B. ein lineares predict_linear über die letzten paar
Stunden), um vor der Wand zu alarmieren, nicht an ihr.
Performance — Metriken 4–8
Der hostmetrics-disk-Scraper (oben aktiviert) trägt das Performance-Set:
- IOPS (4) →
system.disk.operationsnachdirection(read/write) – nimm die Rate. - Durchsatz (5) →
system.disk.io(Bytes) nach direction – nimm die Rate. - Queue-Tiefe (7) →
system.disk.pending_operations. - Sättigung (8) →
system.disk.io_time(Zeit, in der das Gerät beschäftigt war) – bilden Sie die Rate für ein Auslastungsverhältnis. - Latenz (6) ist abgeleitet, nicht roh: durchschnittliche Service-Zeit ≈
rate(system.disk.operation_time) / rate(system.disk.operations). Es ist die Metrik, die „die App ist langsam“ zu „die Disk ist langsam“ umdeutet, also lohnt es sich, sie als Recording-Rule in Ihrem Backend zu berechnen.
Health — Metriken 9–10
Host-Metriken wissen nicht, dass eine Disk stirbt, nur dass sie beschäftigt ist. Für
physische Health fügen Sie eine Source hinzu und scrapen sie mit dem prometheus-Receiver des
Collectors:
- SMART (9): führen Sie
smartctl_exporterauf jedem Host aus – er exponiert reallozierte Sektoren, ausstehende Sektoren, Wear-Level und das übergreifende SMART-Pass/Fail. Scrapen Sie ihn:
receivers:
  prometheus/smart:
    config:
      scrape_configs:
        - job_name: smartctl
          scrape_interval: 60s
          static_configs:
- targets: ["localhost:9633"]- Array-/RAID-Zustand (10): Storage-Arrays und SAN/NAS (NetApp, Pure, Dell usw.) sind nicht
auf Host-Ebene. Sammeln Sie sie mit dem
snmp-Receiver des Collectors gegen die MIBs des Arrays oder scrapen Sie einen Anbieter-Prometheus-Exporter mit demprometheus-Receiver. So oder so landen Kapazität, Controller und RAID-/Pool-Zustand des Arrays im gleichen Backend wie Ihre Host-Metriken – eine Sicht, nicht eine Konsole pro Anbieter.
Alarmiere auf die drei, die Sie pagen
Die meisten Storage-Vorfälle laufen auf drei Alerts hinaus, und mit allem in einem Backend sind sie je eine Regel, flottenweit:
- Zeit bis voll – der projizierte Freiraum erreicht innerhalb von N Stunden null (Metrik 2). Schlägt ein statisches „90 % voll“, das auf einem schnell wachsenden Volume zu spät feuert.
- Latenz-SLO – p99-I/O-Latenz über Schwellenwert (Metrik 6) auf einem Produktions-Volume.
- Vorhergesagtes Versagen – SMART-Pass→Fail oder steigende Anzahl reallozierter Sektoren (Metrik 9) oder RAID degradiert (Metrik 10). Das ist die, die Daten rettet, nicht nur Verfügbarkeit.
Ausrollen — und bezahlbar halten
Zwei praktische Anmerkungen bei Flottenskala. Erstens, Kardinalität: Disk- und Filesystem-Metriken sind pro Gerät und pro Mountpoint, sodass eine grosse Flotte schnell multipliziert. Verwerfen Sie Loopback- und tmpfs-Mounts und aggregieren Sie dort, wo Sie keine Pro-Gerät-Details brauchen – dieselbe Kostensenkungs-Disziplin, die jede Telemetrie bezahlbar hält. Zweitens, Config-Konsistenz: Server, VMs und Array-scrapende Gateways brauchen unterschiedliche Receiver, und das über eine Flotte hinweg von Hand zu editieren ist der Aufwand, der verhindert, dass Storage-Monitoring überhaupt geschieht.
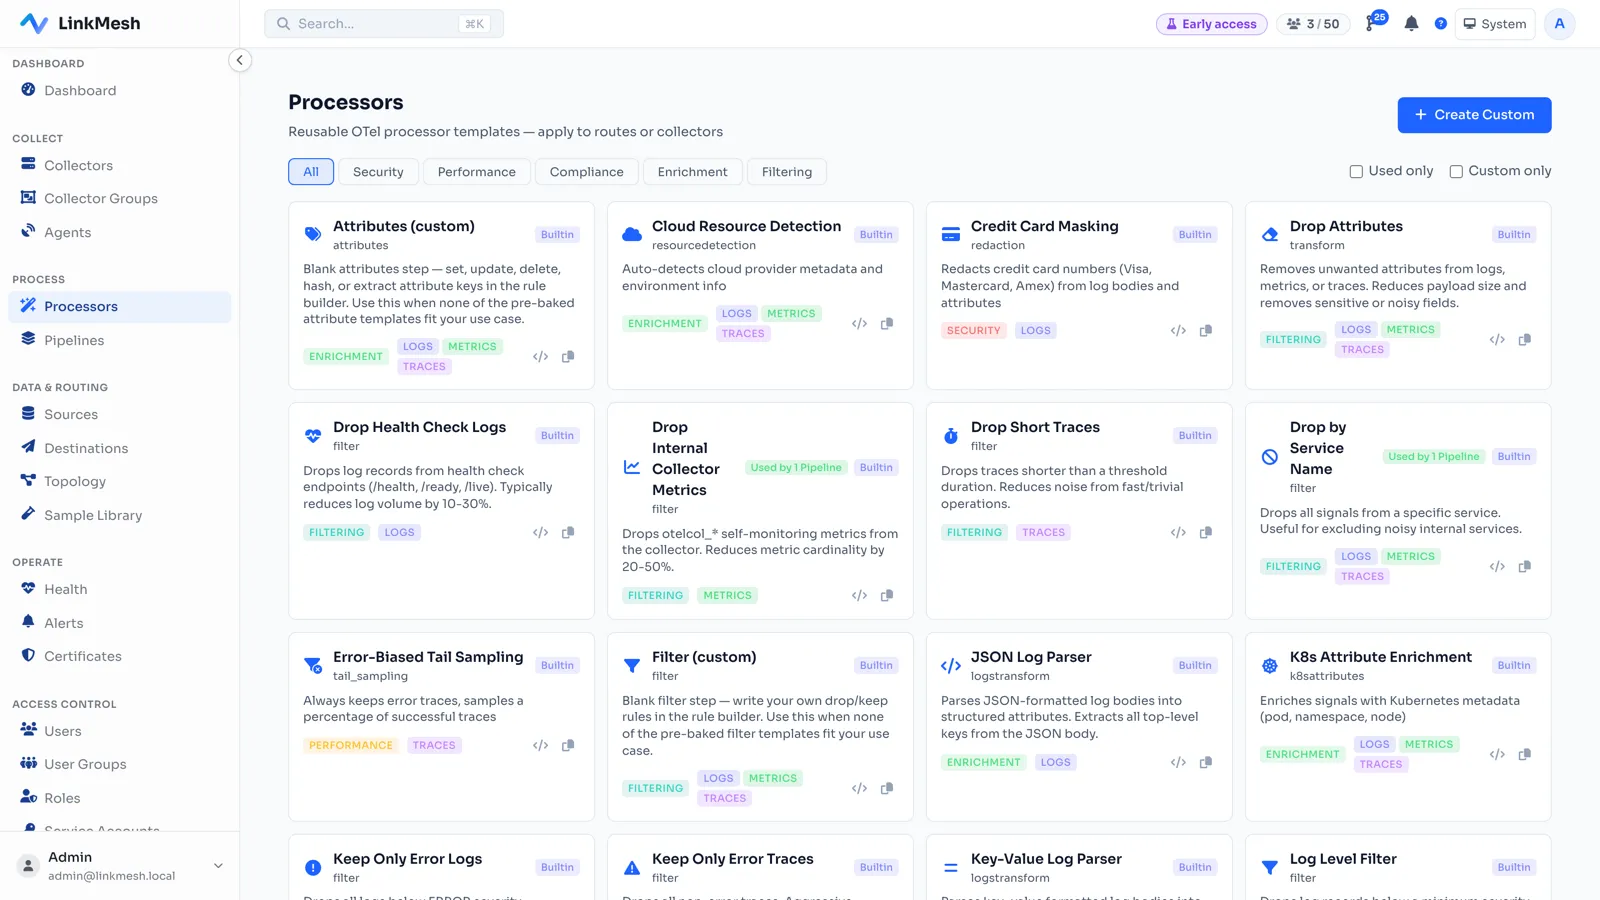
Da passt eine Control Plane hinein. LinkMesh verwaltet die Collector-Config auf
jedem Host und Gateway über OpAMP – pushen Sie das Host-hostmetrics-
smartctl-Profil auf Server und dassnmp-Array-Profil auf Gateways, zeigen Sie jede Änderung in der Vorschau und halten sie versioniert und auditiert. Telemetrie fliesst direkt zu Ihrem Backend und bleibt in Ihrem Netzwerk; LinkMesh verwaltet nur Konfiguration, und es ist pro verwaltetem Collector bepreist, nicht pro Gigabyte – sodass eine storage-lastige Flotte nicht zu einer Volumen-Rechnung wird.
Wo anfangen
- Schalten Sie
hostmetricsein (disk+filesystem, mit aktiviertemutilization) – das sind die Metriken 1–8 aus einem Receiver, den Sie vielleicht schon betreiben. - Fügen Sie SMART hinzu mit
smartctl_exporter+ demprometheus-Receiver für Metrik 9. - Bringen Sie Arrays herein über den
snmp-Receiver oder einen Anbieter-Exporter für Metrik 10. - Bauen Sie die drei Alerts (Zeit bis voll, Latenz, vorhergesagtes Versagen) über die Flotte.
- Rollen Sie die pro-Rolle-Config über OpAMP aus, sodass jeder neue Host und jedes neue Array automatisch berichtet.
Storage braucht kein eigenes Monitoring-Silo. Die zehn Metriken, die zählen – Kapazität, Performance und Health – kommen aus derselben OpenTelemetry-Pipeline, die Sie ohnehin schon betreiben, in ein Backend, für Server und Arrays gleichermassen.
LinkMesh pusht pro-Rolle-Collector-Config – Host-Metriken, SMART und SNMP-Array-Scraping – an jeden Host und jedes Gateway aus einer selbst gehosteten Control Plane über OpAMP, pro Collector statt pro Gigabyte bepreist. Richten Sie eines ein in Minuten, oder sehen Sie sich an, was es kann.