
 LinkMeshObservability Data Collection Management
Proxmox VE → Grafana
Nodes, Gäste, Storage und Ceph – ein Collector pro Node. Self-hosted oder Grafana Cloud.
 Roman Hüsler← Zurück zum Blog
Proxmox VE zeigt einem bereits alles – pro Node. Die Summary-Graphen, das Task-Log, das Ceph-Dashboard: alles da, direkt im Web-UI. Das Problem beginnt, sobald man einen Cluster betreibt: Die eingebauten RRD-Graphen liegen auf dem jeweiligen Node mit fester Aufbewahrung, es gibt kein Alerting auf „Storage zu 90 % voll”, und um „VM 104 ist langsam geworden” mit „OSD 7 hat angefangen zu flattern” zu korrelieren, braucht es vier Browser-Tabs und eine Vermutung.
Der OpenTelemetry Collector läuft als ganz normaler systemd-Dienst auf jedem Proxmox-Node – darunter steckt schließlich Debian. Und seit Proxmox VE 9.0 kommt einem die Plattform entgegen: Ein natives OpenTelemetry-Metric-Server-Plugin pusht Node-, Gast- und Storage-Metriken per OTLP/HTTP an den Collector – dieselben Daten, die auch die eingebauten Graphen speisen, nur mit echter Aufbewahrung, Alerting und einem Dashboard für den ganzen Cluster. Der Collector und die gesamte Sammellogik laufen auf den eigenen Nodes; kombiniert mit self-hosted Prometheus und Loki verlässt die Telemetrie das eigene Netz nie – oder man zeigt auf den OTLP-Endpunkt von Grafana Cloud, wenn man das Backend nicht selbst betreiben will. So oder so: kein SaaS-Agent in der eigenen Infrastruktur, keine Lizenz pro Node.
Admins, die Proxmox VE betreiben – einen Homelab-Node, einen Drei-Node-Cluster oder ein ganzes Rack davon –, im PVE-Web-UI zu Hause sind und Historie, Alerting und eine einzige Grafana-Sicht über Nodes, Gäste, Storage und Ceph wollen. Benötigt werden Root auf den Nodes und ein Grafana-Ziel (self-hosted Grafana + Prometheus/Loki oder der kostenlose Tarif von Grafana Cloud).
Was am Ende steht
- CPU, Arbeitsspeicher (inklusive ZFS ARC), IO-Delay und Netzwerk jedes Nodes in einem Grafana-Dashboard, mit echter Aufbewahrung – statt der festen RRD-Fenster im Node-UI.
- Metriken pro Gast für jede VM und jeden Container – CPU, Speicher, Disk, Netzwerk, laufend/gestoppt – gepusht von Proxmox selbst, ohne Agent in den Gästen.
- Storage-Auslastung pro Store (local-lvm, ZFS, NFS, Ceph-Pools) mit Time-to-full-Trends, plus Ceph-Health und Clusterzustand im hyperkonvergenten Betrieb.
- Das Journal aller Nodes an einem Ort durchsuchbar –
pvedaemon,corosync, der HA-Stack und Backup-bezogene Daemon-Meldungen – statt per SSH von Node zu Node mitjournalctl. - Ein systemd-Dienst pro Node, der all das erledigt – plus ein fertiges Dashboard.
Wie es auf das Bekannte abbildet
Nichts hier ist ein neues Konzept – es ist das Proxmox-Tooling, das man kennt, auf Grafana gerichtet:
| Man kennt es als… | OpenTelemetry holt es via… | In der Config heißt es |
|---|---|---|
| Node-/Gast-Summary-Graphen | nativer OTLP-Push von Proxmox VE (ab 9.0) | otlp-Receiver |
htop, zpool status, IO-Delay |
den Host-Metrik-Collector | hostmetrics |
journalctl auf jedem Node |
den journald-Reader | journald |
Ceph-Dashboard / ceph -s |
den Metrik-Endpunkt des Ceph-Managers | prometheus-Receiver |
| Externer Metric Server (InfluxDB/Graphite) | das Ziel, an das gesendet wird | exporters |
Schritt 1 – Einen gepinnten Collector-Release auf jedem Node installieren
Proxmox VE ist Debian, der Collector installiert sich also wie jedes andere Paket.
Eine getestete Version aus den offiziellen
Releases
wählen – die Release-Assets tragen die Version im Dateinamen, eine stabile
„latest”-Download-URL gibt es nicht, und eine getestete, gepinnte Version schlägt
ohnehin jede ungetestete Neuinstallation von gestern Nacht. Das Beispiel unten nutzt
0.157.0; die gewählte Version entsprechend einsetzen:
OTEL_VERSION="0.157.0"

wget "https://github.com/open-telemetry/opentelemetry-collector-releases/releases/download/v${OTEL_VERSION}/otelcol-contrib_${OTEL_VERSION}_linux_amd64.deb"

dpkg -i "otelcol-contrib_${OTEL_VERSION}_linux_amd64.deb"
(Man braucht den contrib-Build – der journald-Reader liegt dort.)
Das Paket registriert einen systemd-Dienst (otelcol-contrib), der unter einem
eigenen, unprivilegierten Benutzer läuft – ebenfalls otelcol-contrib genannt.
Dieses Detail wird in Schritt 4 wichtig. Die Konfiguration liegt unter
/etc/otelcol-contrib/config.yaml – das ist die eine Datei, die als Nächstes
bearbeitet wird.
Schritt 2 – Backend wählen: Grafana Cloud oder self-hosted
Grafana Cloud (der kostenlose Tarif reicht für den Anfang): unter
Connections → OTLP → „Send data” die zwei angezeigten Werte kopieren – den
OTLP-Endpunkt (sieht aus wie https://otlp-gateway-<zone>.grafana.net/otlp) und
den Authorization-Header (ein Basic ...-Token, das Grafana generiert). Wichtig
zur Einordnung: Auf diesem Pfad wird die Telemetrie per TLS an Grafanas Cloud
exportiert; die Sammlung selbst läuft weiterhin vollständig auf den eigenen Nodes.
Self-hosted Prometheus + Loki – für einen Proxmox-Betrieb die naheliegende Wahl, und der Pfad, auf dem die Telemetrie das eigene Netz wirklich nie verlässt. Zwei Dinge müssen eingeschaltet sein:
- Prometheus muss mit
--web.enable-otlp-receivergestartet werden, um OTLP anzunehmen; der Ingest-Pfad ist/api/v1/otlp/v1/metrics. - Loki 3.x nimmt OTLP nativ unter
/otlpan (bei älteren 2.9er-Versionen muss zuerst Structured Metadata aktiviert werden).
Der passende Exporter-Block, der den einzelnen otlphttp/grafana-Exporter aus
Schritt 3 ersetzt:
exporters:
  otlphttp/prometheus:
    metrics_endpoint: "http://prometheus.example.net:9090/api/v1/otlp/v1/metrics"
  otlphttp/loki:
    endpoint: "http://loki.example.net:3100/otlp"

service:
  pipelines:
    metrics: { ..., exporters: [otlphttp/prometheus] }
    logs:    { ..., exporters: [otlphttp/loki] }
Beide Varianten liegen (auskommentiert) im Download unten – man kommentiert nur die jeweils passende ein.
Schritt 3 – Collector konfigurieren: Node-Metriken, Journal, Ceph
Diese Konfiguration muss niemand von Hand schreiben. Die fertige Datei
herunterladen, die Backend-Werte aus Schritt 2 eintragen und über
/etc/otelcol-contrib/config.yaml speichern:
⬇ Fertige Proxmox-VE-Konfiguration herunterladen (config.yaml)
Das steckt drin, in einfachen Worten – jeder Block entspricht etwas Bekanntem:
receivers:
  otlp:                    # empfängt den nativen Metrik-Push von Proxmox VE (Schritt 5)
    protocols:
      http:
        endpoint: 127.0.0.1:4318   # Loopback — Proxmox pusht vom selben Node

  hostmetrics:             # Node-Werte im htop-Stil: CPU, Speicher, Disks, Netzwerk
    collection_interval: 30s
    scrapers:
      cpu: {}
      memory: {}
      load: {}
      disk: {}
      filesystem: {}
      network: {}
      paging: {}

  journald:                # dasselbe Journal, das man mit journalctl liest
    units:
      - pvedaemon
      - pveproxy
      - pvestatd
      - pve-cluster
      - pve-ha-lrm
      - pve-ha-crm
      - corosync
    priority: info

processors:
  memory_limiter:          # verhindert, dass der Collector dem Hypervisor RAM wegfrisst
    check_interval: 1s
    limit_mib: 256
    spike_limit_mib: 64
  resourcedetection/system:  # stempelt host.name auf alles → host_name in Grafana
    detectors: [system]
    system:
      hostname_sources: [os]
  batch: {}

exporters:
  otlphttp/grafana:        # Grafana Cloud — oder das Self-hosted-Paar aus Schritt 2
    endpoint: "https://otlp-gateway-<zone>.grafana.net/otlp"
    headers:
      Authorization: "Basic <base64 aus instanceID:token>"

service:
  pipelines:
    metrics:
      receivers: [otlp, hostmetrics]
      processors: [memory_limiter, resourcedetection/system, batch]
      exporters: [otlphttp/grafana]
    logs:
      receivers: [journald]
      processors: [memory_limiter, resourcedetection/system, batch]
exporters: [otlphttp/grafana]otlp– die offene Tür, durch die Proxmox seine eigenen Metriken pusht (Schritt 5). Sie bindet bewusst auf Loopback: In diesem Setup betreibt jeder Node seinen eigenen Collector, im Netz muss also nichts lauschen. (Pusht ein entfernter Node an einen zentralen Collector? Dann0.0.0.0:4318binden, TCP 4318 in der Proxmox-Firewall öffnen und TLS davorlegen.)hostmetrics– die Node-Basics, mit Historie. Hier steckt auch das IO-Delay – die Zahl, auf die jeder Proxmox-Admin zuerst schaut.journald– Cluster-, HA- und Daemon-Aktivität. Beim Thema Backup erfasst dies die Backup-bezogenen Daemon-Meldungen (vzdump-Läufe, angestoßen überpvedaemon) – die vollständige Task-Ausgabe verbleibt in Proxmox’ Task-Logs unter/var/log/pve/tasksund wird von dieser Konfiguration nicht eingesammelt.resourcedetection/system– stempelthost.nameauf jede Metrik und jede Log-Zeile; daraus wird dashost_name-Label, nach dem man in Grafana filtert. Ohne diesen Processor haben die Abfragen und das Dashboard unten nichts, worauf sie gruppieren können.memory_limiter+batch– Produktionshygiene: hartes Speicherlimit und gebündelter Export, in dieser Reihenfolge, in jeder Pipeline.
Ceph – nur dort, wo ein Manager läuft
Cephs Metriken kommen vom prometheus-Modul des Managers, nicht von jedem Node.
Das Modul einmal clusterweit aktivieren:
ceph mgr module enable prometheusDann nur auf Nodes mit laufendem ceph-mgr scrapen – oder, betrieblich
einfacher, alle Manager-Adressen auf einem Collector eintragen und dem aktiven
folgen lassen (Standby-Manager antworten mit einer leeren Seite, alle zu scrapen
ist also unbedenklich):
receivers:
  prometheus/ceph:
    config:
      scrape_configs:
        - job_name: ceph
          scrape_interval: 15s     # entspricht dem Standard-Cache-Intervall des mgr-Moduls
          honor_labels: true
          static_configs:
            - targets:
                - "pve1.example.net:9283"
                - "pve2.example.net:9283"
                - "pve3.example.net:9283"
prometheus/ceph auf diesem Collector in die receivers-Liste der Metrik-Pipeline
aufnehmen. localhost:9283 nicht blind auf jeden Node kopieren – auf Nodes ohne
Manager lauscht dort schlicht nichts. Und eine Einordnung zum Umfang: Das mgr-Modul
liefert Health, Kapazität und Clusterzustand – genau das, worauf man alertet;
neuere Ceph-Releases haben die detaillierten Performance-Counter der einzelnen
Daemons in den separaten ceph-exporter ausgelagert. Es sind hier also bewusst
nicht „alle Ceph-Metriken, die es gibt”.
Schritt 4 – Dem Collector das Journal freigeben
Das DEB betreibt den Collector unter dem unprivilegierten Benutzer
otelcol-contrib – und der darf das System-Journal von Haus aus nicht lesen.
Die Mitgliedschaft in der Gruppe systemd-journal löst das:
usermod -aG systemd-journal otelcol-contrib
systemctl restart otelcol-contrib
Und der Beweis, als Service-Benutzer:
sudo -u otelcol-contrib journalctl -u pvedaemon -n 5Erscheinen fünf Journal-Zeilen, kann der Collector sie ebenfalls lesen. (Der Versuchung widerstehen, den Dienst einfach als root laufen zu lassen – die Gruppe ist alles, was er braucht.)
Schritt 5 – Den nativen OpenTelemetry-Push von Proxmox VE einschalten
Dieser Schritt macht aus generischem Linux-Monitoring Proxmox-Monitoring. Seit
Proxmox VE 9.0 liefert die Plattform ein OpenTelemetry-Metric-Server-Plugin
neben den altbekannten Optionen InfluxDB und Graphite. Es pusht die Statusdaten, die
pvestatd ohnehin sammelt – Metriken pro Node, pro Gast (VM und Container) und pro
Storage – per OTLP/HTTP an den Collector.
Im Web-UI: Datacenter → Metric Server → Add → OpenTelemetry, als Ziel der
Collector auf dem Node selbst: http://localhost:4318. Weil der Metric Server eine
Einstellung auf Datacenter-Ebene ist, konfiguriert man ihn einmal – und jeder
Node im Cluster pusht an seinen lokalen Collector.
Zwei Optionen bis zum Upgrade. Installationen mit pve-manager 8.2.5
oder neuer stellen /cluster/metrics/export für Pull-basierte Sammlung
bereit – vor dem Verlassen darauf prüfen, ob der Endpunkt auf den eigenen Nodes
antwortet. Oder man betreibt den Community-Exporter
prometheus-pve-exporter (Read-only-API-Token mit der Rolle PVEAuditor)
und scrapt ihn mit demselben prometheus-Receiver wie Ceph oben – der
Rest dieser Anleitung bleibt unverändert.
Schritt 6 – Validieren, dann verifizieren
Immer erst validieren, dann neu starten – ein Tippfehler, den der Validator findet, ist ein Tippfehler, der die Telemetrie nie unterbricht:
otelcol-contrib validate --config /etc/otelcol-contrib/config.yaml
systemctl restart otelcol-contrib
systemctl status otelcol-contrib
Dann die Daten Ende-zu-Ende prüfen:
- Grafana → Explore öffnen, die Metrik-Datenquelle wählen und auf
host_namefiltern – mit demresourcedetection-Processor aus Schritt 3 meldet sich jeder Node unter seinem Hostnamen. Host-Metriken erscheinen binnen einer Minute; die Gast- und Storage-Metriken von Proxmox folgen mit dem nächsten Push-Zyklus vonpvestatd. - Die Datenquelle auf Loki umstellen und
{host_name="pve1"}abfragen – das Journal des Nodes ist jetzt durchsuchbar. (Keinhost_name-Label? Prüfen, obresourcedetection/systemin der Logs-Pipeline steht; das Label existiert nur, weil dieser Processor es dort hineinschreibt.)
Das ist die ganze Schleife: ein Dienst pro Node, eine Datacenter-Einstellung – und der Cluster meldet sich in Grafana.
Schritt 7 – Dashboard importieren und Alerts verdrahten
Statt Panels von Hand zu bauen, das fertige Starter-Dashboard importieren und oben im Node-Dropdown den Node wählen:
⬇ Proxmox-VE-Dashboard herunterladen (Grafana-JSON)
In Grafana: Dashboards → New → Import → Upload JSON file, danach die Prometheus- und Loki-Datenquellen zuordnen. Enthalten sind Panels für CPU-Auslastung, IO-Delay, Speicher, Dateisystem-Belegung, Netzwerkdurchsatz, eine Node-Reporting-Kachel, Ceph-Health, Backup-bezogene Journal-Fehler und ein durchsuchbares Journal-Panel. Die Host-Metrik-Panels funktionieren mit der Konfiguration oben unverändert.
Ein ehrlicher Vorbehalt zu den nativen Proxmox-Metriken: Der OTLP-Push benennt sie
mit proxmox_-Präfixen (Counter erhalten in Prometheus ein _total-Suffix), die
exakten Namen können sich zwischen PVE-Releases aber weiterentwickeln – vor dem
Verdrahten von Alerts in Grafana Explore gegen die eigene Version prüfen. Die
Muster, nach denen man sucht:
# Node-CPU, wie von Proxmox selbst gemeldet
proxmox_node_cpu

# Füllgrad pro Storage — der Alert, der die meisten Proxmox-Ausfälle verhindert
proxmox_storage_used_bytes / proxmox_storage_total_bytes

# Ceph: alles außer 0 verdient einen Page
ceph_health_status
Dann die Alerts verdrahten. Mit diesen startet man – sie decken die meisten Proxmox-Vorfälle ab, die uns begegnen:
| Alert | Signal | Warum |
|---|---|---|
| Storage > 85 % belegt | Storage-Metrik pro Store | Voller Storage = Gäste pausieren oder gehen read-only. Als Trend betrachten – Time-to-full schlägt jeden Schwellenwert. |
| IO-Delay dauerhaft > 10 % | hostmetrics CPU-State wait |
Der Klassiker hinter „alles ist langsam” auf hyperkonvergenten Nodes. |
| Node-Speicher > 90 % inkl. ARC | hostmetrics Memory |
ZFS ARC + KSM machen Speicherdruck im UI leicht fehlinterpretierbar. |
| Gast down, der laufen sollte | Proxmox-Gaststatus-Metrik | Fängt abgestürzte VMs, die der HA-Stack nicht verwaltet. |
| Ceph-Health ≠ OK / OSD down | Ceph-mgr-Metriken | Degraded ist einen Ausfall vom Datenverlust entfernt. |
| Backup-bezogene Fehler im Journal | vzdump-/pvedaemon-Meldungen |
Ein Frühwarnsignal – für garantiertes Alerting auf Job-Ebene zusätzlich Proxmox’ eigenes Notification-System aktivieren; vollständige Task-Logs verbleiben in /var/log/pve/tasks. |
| Quorum verloren / corosync flattert | Journal (corosync) |
Geht Fencing-Ereignissen voraus; ein flatternder Link ist der Warnschuss. |
Optional – Eine Proxmox-Collector-Flotte mit LinkMesh verwalten
Das Setup oben ist vollständig – ab hier geht es nur noch um den Betrieb im großen Maßstab. Ein Node ist eine Datei, die man bearbeitet; drei Cluster an zwei Standorten plus Backup-Host sind eine Flotte, und YAML von Hand auf jedem Node zu pflegen ist genau die Mühsal, wegen der man die RRD-Graphen so lange ertragen hat.
OpenTelemetrys Antwort auf Flottenverwaltung ist OpAMP:
Ein kleiner Supervisor-Prozess läuft neben dem Collector und verwaltet dessen
Konfiguration – ein nacktes otelcol-contrib allein meldet sich nirgends.
LinkMesh liefert genau dieses Gespann, als self-hosted Control
Plane – was hier zählt, denn wer Proxmox on-prem betreibt, will die Telemetrie
seiner Infrastruktur nicht aus fremder Cloud verwaltet sehen. Läuft das Setup auf
einem Node, enrollt man die Collectors der übrigen Nodes per Token, und LinkMesh
verteilt und versioniert die getestete Konfiguration über die Flotte – jede
Änderung mit Vorschau, versioniert und auditiert, während die Telemetrie selbst
weiterhin direkt von jedem Node zum Backend fließt.
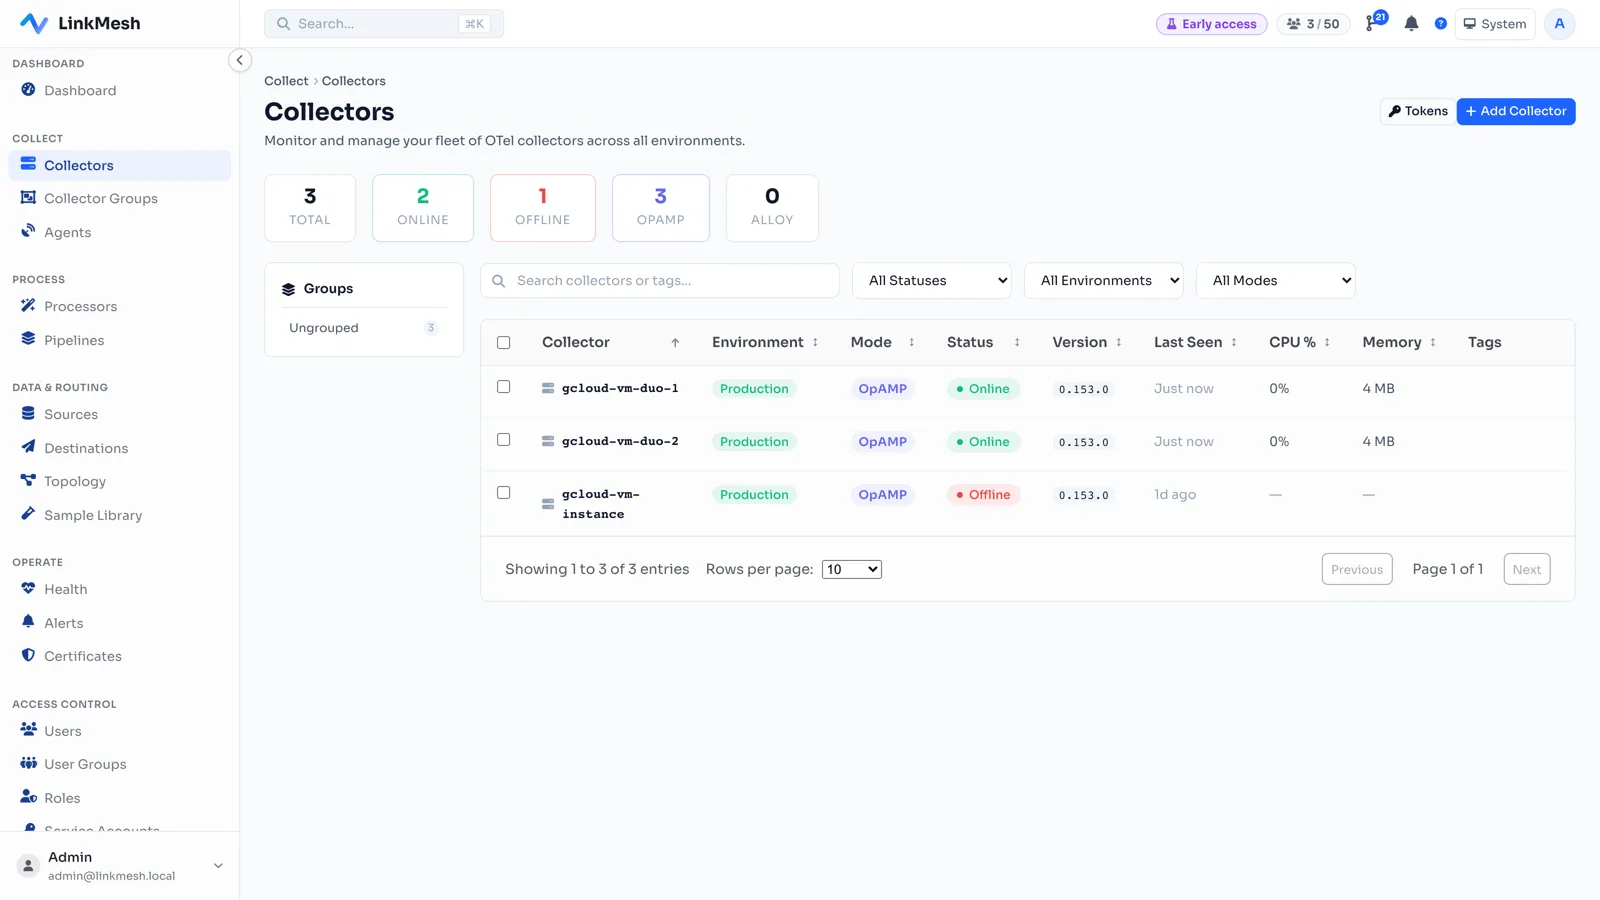
Abgerechnet wird pro verwaltetem Collector, nicht pro Gigabyte – ein gesprächiges Cluster-Journal wird so nicht zur Volumenrechnung. Und ab Flottengröße ist es auch der Ort, um die Configs vor Drift zu schützen – Stichwort 2-Uhr-nachts-Hotfix.
Troubleshooting
- Dienst bleibt nicht am Laufen –
otelcol-contrib validate --config /etc/otelcol-contrib/config.yamlausführen; der exakte YAML-Fehler steht im Klartext da. - Proxmox-Metric-Server meldet Fehler – prüfen, ob der Collector lauscht:
ss -ltnp | grep 4318. Pusht ein Node an einen entfernten Collector, muss der Receiver0.0.0.0:4318binden (nicht Loopback) und TCP 4318 in der Proxmox-Firewall offen sein – und vor dem Senden übers Netz gehört TLS davor. - Keine Journal-Einträge in Loki – der Benutzer
otelcol-contribmuss in der Gruppesystemd-journalsein (Schritt 4). Genau das prüfen, was der Dienst sieht:sudo -u otelcol-contrib journalctl -n 5. - Kein
host_name-Label – der Processorresourcedetection/systemmuss in beiden Pipelines stehen; das Label existiert nur, weil er es dort erzeugt. - Keine Ceph-Metriken – das Modul muss aktiviert sein (
ceph mgr module enable prometheus) und der Scrape muss auf einen Manager-Node zielen; mitcurl <mgr-host>:9283/metricsgegenprüfen. Standby-Manager liefern legitim eine leere Seite – alle scrapen, der aktive liefert. - Gast-Metriken fehlen, Node-Metriken da – den nativen Push gibt es seit
PVE 9.0; auf 8.x den
prometheus-pve-exporternutzen, wie in Schritt 5 beschrieben.
Proxmox VE liefert den Hypervisor – den Observability-Stack hat es nie versprochen. Ein Paket, eine Config-Datei, eine Datacenter-Einstellung – und der ganze Cluster meldet sich in Grafana. Zu den eigenen Bedingungen, im eigenen Netz.
LinkMesh verwaltet den Collector auf jedem Node aus einer self-hosted Control Plane – einmal bearbeiten, Vorschau prüfen und per OpAMP ausrollen, versioniert und auditiert, abgerechnet pro Collector statt pro Gigabyte. In wenigen Minuten aufsetzen – oder ansehen, was es kann.