
 LinkMeshObservability Data Collection Management
Observability vs. AIOps
Keine Rivalen – beide laufen auf demselben Telemetrie-Fundament.
 Philippe Braxmeier← Zurück zum Blog
„Observability” und „AIOps” werden herumgeworfen, als müsste man eines wählen, oder als sei AIOps der glänzendere Ersatz für Observability. Beides trifft nicht zu. Sie beantworten unterschiedliche Fragen, sie werden von unterschiedlichen Teams genutzt, und beide schöpfen aus denselben zugrunde liegenden Betriebsdaten.
Hier die Kurzfassung: Observability ist, wie Ingenieure Telemetrie erkunden, um Systeme zu verstehen. AIOps wendet maschinelles Lernen auf Betriebsdaten an, um zu erkennen, zu korrelieren, vorherzusagen und zu automatisieren. Sie sind nicht zwei Enden eines Spektrums – sie sind zwei Konsumenten eines geteilten Fundaments. Dieser Leitfaden zieht die Grenze klar, zeigt, welche Teams auf welcher Schicht arbeiten, und erklärt, warum die Pipeline unter beiden entscheidet, wie nützlich jede von ihnen ist.
Was Observability tatsächlich bedeutet
Observability ist die Fähigkeit, den inneren Zustand eines Systems aus der Telemetrie zu verstehen, die es aussendet – vor allem Metriken, Logs und Traces (und zunehmend Profiles) – gut genug, um Fragen zu beantworten, von denen man vorab nicht wusste, dass man sie stellen würde („unbekannte Unbekannte”). In der Praxis sind es zwei Dinge:
- Die Telemetrie – Metriken (ist es langsam?), Logs (was ist passiert?) und Traces (wo, über welche Dienste?), erfasst von jedem Host und Dienst.
- Die Werkzeuge, um sie zu erkunden – Dashboards, Abfragen und Trace-Ansichten, in denen ein Mensch untersucht: filtern, pivotieren, hinabtauchen, korrelieren.
Observability ist oft menschengetrieben und explorativ: Ingenieure nutzen Telemetrie, um unbekannte Zustände zu untersuchen und Verhalten zu verstehen. Moderne Observability-Plattformen automatisieren auch Erkennung, Korrelation und Analyse – sodass die Grenze zu AIOps nicht perfekt scharf ist. (Zur Anatomie, wie diese Telemetrie erfasst und verschickt wird, siehe Was ist eine Telemetrie-Pipeline?.)
Was AIOps tatsächlich bedeutet
AIOps – „AI for IT Operations” – wendet maschinelles Lernen und Statistik auf Betriebsdaten und Arbeitsabläufe an, um im Massstab zu tun, was ein Mensch sonst von Hand tut:
- Anomalieerkennung – lernt, wie „normal” aussieht, und markiert Abweichungen, statt dass man statische Schwellenwerte setzt.
- Ereigniskorrelation & Rauschreduktion – bündelt einen Sturm von 500 verwandten Alarmen zu einem Vorfall, damit die Bereitschaft nicht ertrinkt.
- Ursachenanalyse-Unterstützung – hebt den wahrscheinlichen Auslöser unter Tausenden von Signalen hervor.
- Vorhersage & Automatisierung – prognostiziert Kapazität oder Ausfälle und (bei höherer Reife) empfiehlt oder löst eine Behebung aus.
AIOps ist stärker automatisierungsorientiert. Je nach Reife kann es diagnostisch, prädiktiv oder präskriptiv sein – vom Markieren von Anomalien bis zum Empfehlen oder Auslösen von Handlungen. Aber es braucht Betriebsdaten, über die es schliessen kann – vieles davon kommt aus derselben Telemetrie-Pipeline, die auch die Observability-Plattform nutzt, ergänzt um Ereignisse, Vorfälle, Änderungen und Topologie.
Nebeneinander
| Observability | AIOps | |
|---|---|---|
| Frage, die sie beantwortet | Was geschieht, und warum? | Was zählt, und was ist dagegen zu tun? |
| Wie es genutzt wird | Ingenieure, die untersuchen und erkunden | Modelle, die bewerten, korrelieren und automatisieren |
| Eingabe | Telemetrie – Metriken, Logs, Traces, Profiles | Überlappende Daten – Telemetrie plus Ereignisse, Vorfälle, Änderungen, Topologie |
| Ausgabe | Dashboards, Abfrageergebnisse, Trace-Ansichten | Anomalien, korrelierte Vorfälle, Ursachenhinweise, Automatisierung |
| Fehlermodus | Zu viele Daten, zu wenig Zeit | Schlechte Modelle, Fehlalarme, „Black-Box”-Misstrauen |
| Reife | Gut etabliert, offene Standards (OpenTelemetry) | Neuer, meist proprietär, Qualität variiert stark |
Die Tabelle macht das Verhältnis klar: Observability-Plattformen und AIOps-Systeme nutzen überlappende Betriebsdaten, aber verwenden sie unterschiedlich. Observability hilft Ingenieuren, Systeme zu untersuchen und zu verstehen; AIOps nutzt KI, um zu priorisieren, zu korrelieren, vorherzusagen und Betriebsarbeit zu automatisieren. Sie sind keine Konkurrenten auf derselben Sprosse – sie sind zwei Konsumenten desselben Fundaments.
Das echte Verhältnis: ein geteiltes Fundament, zwei Konsumenten
Denken Sie in Schichten, nicht in Alternativen. Anwendungen und Infrastruktur senden Telemetrie, Ereignisse und Betriebskontext aus. Eine Telemetrie-Pipeline erfasst, bereinigt, reichert an und routet sie. Auf diesen Daten sitzen beide – Ihre Observability-Plattform (wo Menschen erkunden) und Ihr AIOps-System (wo Modelle bewerten) –, wobei AIOps typischerweise zusätzliche Quellen wie Vorfälle, Änderungen und Topologie einbezieht. Dasselbe Fundament, unterschiedliche Konsumenten.
Deshalb ist „Observability vs. AIOps” die falsche Rahmung. Man betreibt Observability, um Systeme verständlich zu machen, und fügt AIOps hinzu, wenn das Signalvolumen über das hinauswächst, was Menschen von Hand triagieren können. Beide schöpfen aus derselben regierten Telemetrie – weshalb die Pipeline darunter mehr zählt als das „Versus”.
Welche Teams arbeiten auf welcher Schicht?
Der Unterschied wird klarer, wenn man betrachtet, wer jede Schicht nutzt. Die Grenzen variieren je nach Organisation, aber das Betriebsmodell sieht meist so aus:
| Team | Primäre Schicht | Was sie tun |
|---|---|---|
| Anwendungs- & Produktteams | Observability-Plattform | Dienste instrumentieren, Dashboards bauen, Logs und Traces inspizieren, Releases fehlersuchen. |
| SRE & Production Engineering | Observability + AIOps | SLOs definieren, Vorfälle untersuchen, Abhängigkeiten analysieren, Alarmrauschen reduzieren, wiederkehrende Reaktionen automatisieren. |
| Observability / Platform Engineering | Telemetrie-Pipeline + Observability | Die Collectors betreiben, Schemas und Attribute verwalten, Routing und Sampling steuern, geteilte Werkzeuge bereitstellen. |
| IT-Betrieb & NOC | AIOps + Event-Management | Infrastruktur und Dienste überwachen, korrelierte Ereignisse konsumieren, Vorfälle priorisieren, Betriebsabläufe auslösen. |
| IT-Service-Management | AIOps + ITSM | Vorfälle mit Diensten, Änderungen, Konfigurationselementen, Verantwortlichkeit und Eskalation verbinden. |
| Security, Datenschutz & Compliance | Telemetrie-Governance | Definieren, was erfasst werden darf, wohin es gesendet werden darf, welche Felder maskiert werden müssen und wie Zugriff und Aufbewahrung gesteuert werden. |
Anwendungsteams verbringen die meiste Zeit in Observability-Tools und erkunden die Systeme, die sie bauen. Betriebsteams leben stärker in AIOps-, Event-Management- und ITSM-Plattformen, wo Signale aus vielen Technologien zu Vorfällen und Handlungen konsolidiert werden. Plattform- und Observability-Teams sitzen dazwischen: Sie betreiben das geteilte Telemetrie-Fundament – Signale erfassen, standardisieren, entrauschen, maskieren und an die richtigen Ziele routen.
Diese Rollen sind nicht exklusiv. SRE-, Platform-Engineering- und Incident-Response-Teams arbeiten häufig quer über Observability, AIOps, ITSM und Telemetrie-Management-Systeme. Der Punkt sind nicht starre Bahnen; er ist, dass der Kauf einer AIOps-Plattform nicht die Notwendigkeit von Engineering-Observability beseitigt und eine Observability-Plattform einem NOC nicht die Betriebsabläufe an die Hand gibt, die es braucht. Jede Schicht bedient unterschiedliche Nutzer auf geteilten, konsistent regierten Daten.
Eine Control Plane wie LinkMesh wird primär vom Observability- oder Platform-Engineering-Team betrieben. Anwendungsteams sollten keine einzelnen Collector-Konfigurationen verwalten müssen; das Plattform-Team stellt wiederverwendbare Richtlinien und Pipelines für Erfassung, Anreicherung, PII-Maskierung, Sampling und Routing bereit, während Anwendungs-, SRE-, Betriebs- und Security-Teams die Anforderungen definieren, die diese Pipelines erfüllen müssen.
Garbage in, garbage out – die Pipeline entscheidet über beides
Hier ist der Teil, den die meisten „AIOps löst alles”-Pitches überspringen: Ein ML-Modell ist nur so gut wie die Daten, mit denen es gefüttert wird. Richtet man AIOps auf verrauschte, inkonsistente, halb gelabelte Telemetrie aus, bekommt man selbstbewussten Unsinn – Fehlalarme, die Vertrauen schneller untergraben als gar kein AIOps. Die Schicht, die die Qualität für beide Konsumenten bestimmt, ist die Pipeline darunter:
- Saubere, konsistente Struktur. Standardisierte Resource-Attribute wie
service.name,service.namespaceunddeployment.environment.name– plus eine organisationsweite Konvention für Dinge wie Dienstverantwortung – lassen ein Modell und einen Menschen Signale zuverlässig gruppieren und korrelieren. Inkonsistentes Tagging bricht die Korrelation für alle. - Rauschen an der Quelle reduziert. Health-Check-Spam zu verwerfen und repetitive Ereignisse zu sampeln bedeutet, dass AIOps aus Signal lernt, nicht aus Geplauder – und Ihre Rechnung folgt dem Wert, nicht dem Volumen. Es ist dieselbe Kostensenkungsarbeit, die Observability erschwinglich macht.
- Sensible Daten vor dem Ausgang maskiert. Einem AIOps-/ML-Dienst rohe Logs voller Benutzernamen, E-Mail-Adressen und Tokens zu füttern, ist ein reales Risiko. Sensible Felder zu maskieren, bevor die Telemetrie die kontrollierte Umgebung verlässt, reduziert nachgelagerte Exposition und kann Compliance-Bewertungen vereinfachen – auch wenn es einen AIOps- oder KI-Dienst nicht von sich aus aus dem regulatorischen oder datenschutzrechtlichen Geltungsbereich nimmt. Siehe PII-Maskierung in Logs.
- An viele geroutet, ohne einen Agenten pro Backend. Weil die Pipeline auf OpenTelemetry und OTLP aufbaut, kann dieselbe saubere Telemetrie an Ihr Observability-Backend und eine AIOps-Engine exportiert werden, ohne für jedes einen separaten Host-Agenten auszurollen – zielspezifische Exporter oder Gateways können weiterhin nötig sein, aber Sie vermeiden Vendor-Lock-in auf beiden Seiten.
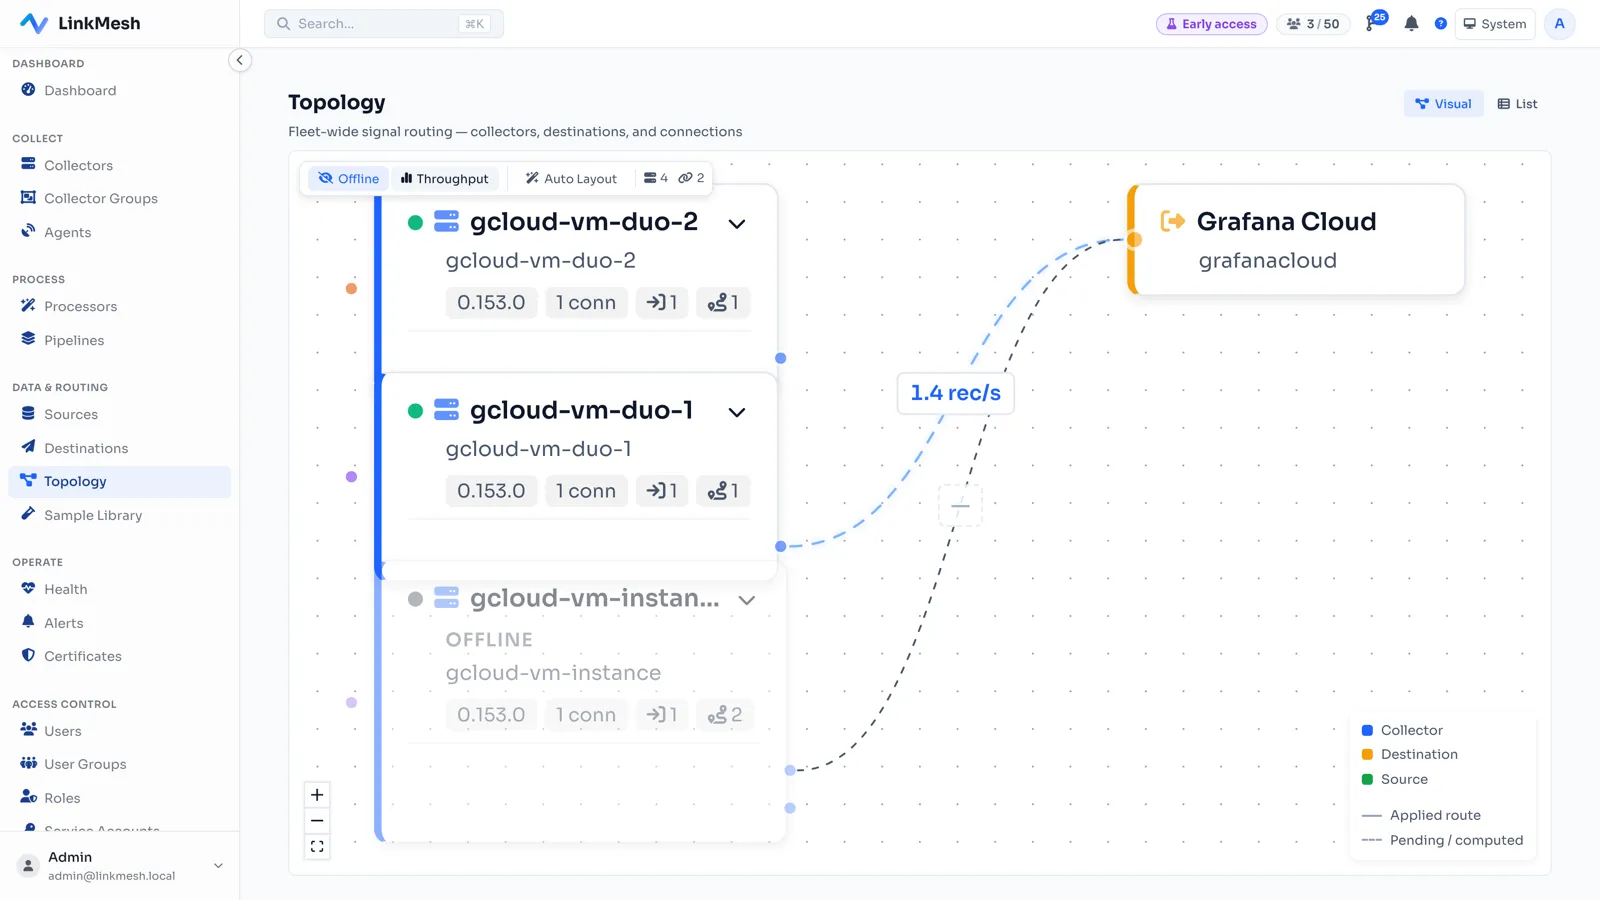
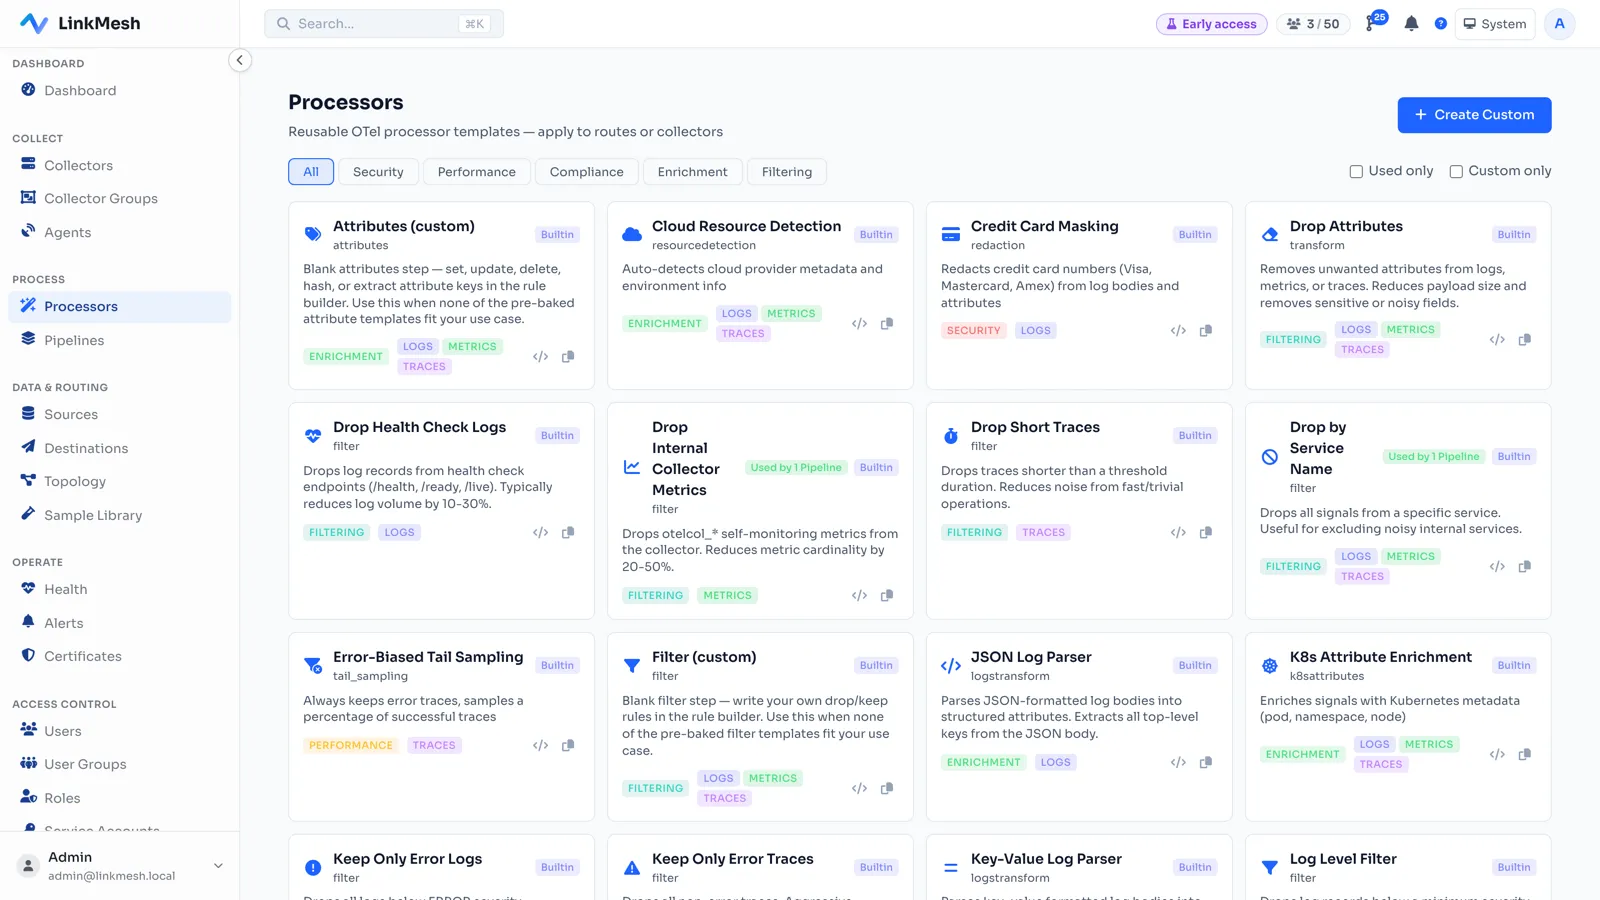
Genau hier sitzt eine Control Plane wie LinkMesh: Sie verwaltet die OpenTelemetry Collectors, die Ihre Telemetrie erfassen, anreichern, maskieren und routen – das Fundament, das Ihre Observability nutzbar und Ihr AIOps vertrauenswürdig macht. Bringen Sie diese Schicht richtig hin, und beide Konsumenten verbessern sich; bringen Sie sie falsch hin, und kein Mass an ML rettet die Daten.
Richte es am Geschäft aus, nicht nur an der Infrastruktur
Ein Telemetrie-Fundament braucht auch Geschäftsausrichtung – sonst baut man eine technisch beeindruckende Datenplattform, die enorme Volumina sammelt, ohne die Kundenergebnisse klar zu verbessern. Ausrichtung bedeutet nicht, dass Geschäftsteams Collectors oder Alarmregeln konfigurieren; sie bedeutet, dass sich die Prioritäten der Plattform aus geschäftskritischen Diensten und Risiken ableiten:
- Kritische Dienste – welche Kundenreisen, Produkte und Prozesse zählen am meisten?
- Dienstziele – welche Verfügbarkeits-, Leistungs- und Wiederherstellungsziele gelten?
- Geschäftliche Auswirkung – welche Ausfälle treffen Umsatz, Kunden, Regulierung oder Reputation?
- Kosten-Governance – ist der Wert der Telemetrie proportional zu ihrer Speicherung und Verarbeitung?
- Compliance – welche Telemetrie darf erfasst, aufbewahrt oder an externe Plattformen gesendet werden?
| Ebene | Definiert |
|---|---|
| Geschäfts- & Diensteigentümer | Kritische Dienste, Auswirkung, Prioritäten, Risikotoleranz |
| Produkt- & Anwendungsteams | Dienstindikatoren, Instrumentierung, Anwendungs-Dashboards |
| SRE & Betrieb | SLOs, Alarme, Vorfallsreaktion, Zuverlässigkeitsverbesserungen |
| Observability-Plattform-Team | Geteilte Erfassung, Governance, Pipelines, Werkzeuge, Befähigung |
| Security & Compliance | Datenklassifizierung, Maskierung, Zugriff, Aufbewahrung |
Das Plattform-Team sollte nicht allein entscheiden, was wichtig ist; es stellt die technischen Fähigkeiten bereit, während Geschäfts- und Diensteigentümer definieren, warum ein Dienst zählt und wie zuverlässig er sein muss. Das Prinzip: Geschäftsprioritäten definieren, was zuverlässig sein muss; Observability liefert die Evidenz, um es zu betreiben und zu verbessern. Ohne diese Ausrichtung messen Teams die Infrastrukturgesundheit und verfehlen den eigentlichen Dienst – jeder Server grün, während Kunden keine Zahlung abschliessen oder sich nicht anmelden können.
Wo anfangen
- Bringen Sie zuerst die Observability solide hin. Standardisieren Sie auf OpenTelemetry, erfassen Sie Metriken, Logs und Traces mit konsistenten Attributen und geben Sie Menschen gute Dashboards. Das ist das Fundament, und es liefert am ersten Tag Wert.
- Reparieren Sie die Pipeline, nicht nur das Backend. Reduzieren Sie Rauschen, maskieren Sie sensible Felder und standardisieren Sie Tags auf der Erfassungsschicht – das ist es, was die Daten erschwinglich und AIOps-tauglich macht.
- Fügen Sie AIOps hinzu, wenn das Volumen es verlangt. Wenn Alarmmüdigkeit und Signalüberlast die menschliche Triage überholen, legen Sie ML auf die regierten Daten, die Sie bereits haben. Fangen Sie eng an (Anomalieerkennung oder Alarmkorrelation) und erweitern Sie, sobald es Vertrauen verdient.
Observability vs. AIOps war nie ein echter Wettstreit. Observability macht Systeme verständlich; AIOps hilft dem Betrieb zu skalieren. Beide stehen auf derselben regierten Telemetrie – sodass die klügste frühe Investition die Pipeline ist, die diese Telemetrie darunter sauber, konform und herstellerneutral hält.
LinkMesh ist eine selbst gehostete Control Plane für OpenTelemetry Collectors – erfassen, anreichern, maskieren und regierte Telemetrie routen an jedes Backend oder jede AIOps-Engine, abgerechnet pro Collector statt pro Gigabyte. Setze eine auf in wenigen Minuten, oder sehen Sie sich an, was sie kann.