
 LinkMeshObservability Data Collection Management
Update-Monitoring für Windows & Linux
Patch-Compliance über die gesamte Flotte, in einer Grafana-Ansicht.
 Roman Hüsler← Zurück zum Blog
Auf die Frage „Welchen unserer Server fehlen Sicherheitsupdates?” dauert die Antwort in den meisten Betrieben einen ganzen Nachmittag. Der Windows-Patch-Status liegt in WSUS oder SCCM; Linux liegt in apt oder yum und einer Tabellenkalkulation; niemand hat einen einzigen Blick darauf, und „Tage seit dem letzten Patch” pro Host ist ein manuelles Audit. Es ist eine Sicherheits- und Compliance-Lücke, die im Verborgenen liegt.
Um sie zu schliessen, braucht es kein weiteres Patch-Reporting-Produkt. Der OpenTelemetry Collector, der (wahrscheinlich) ohnehin schon für Metriken und Logs läuft, kann auch den Update-Status jedes Hosts erfassen – ausstehende Updates, Sicherheitspatches, Reboot erforderlich, zuletzt gepatcht – und zwar von Windows und Linux gleichermassen, und ihn als eine einheitliche, alarmierbare Ansicht an Grafana senden.
Plattform-, Sysadmin- und Security-Teams, die eine gemischte Windows-+-Linux-Flotte betreiben und einen betriebssystemübergreifenden Blick auf die Patch-Compliance wollen – ohne ein separates Reporting-Tool aufzusetzen. Voraussetzungen: ein OpenTelemetry Collector auf den Hosts (oder ein Plan dafür) und ein Grafana-Ziel (die kostenlose Stufe von Grafana Cloud genügt, ebenso ein selbst gehostetes Prometheus + Loki).
Was „Updates überwachen” tatsächlich bedeutet
Vier Signale beantworten nahezu jede Frage zur Patch-Compliance, und man will sie auf jedem Host gleich haben, unabhängig vom Betriebssystem:
- Ausstehende Updates – wie viele Updates verfügbar sind und wie viele davon sicherheitsrelevant sind.
- Reboot erforderlich – wartet der Host auf einen Neustart, um das Patchen abzuschliessen?
- Zuletzt gepatcht – wann wurden zuletzt Updates installiert? („Tage seit” ist die Compliance-Uhr.)
- Update-Fehler – ist der letzte Patch-Lauf mit einem Fehler abgebrochen?
Der Kniff besteht darin, diese vier Signale konsistent von Windows und Linux zu erfassen und dann in einem einzigen Backend abzulegen, damit ein einziges Dashboard und eine einzige Alarmregel die gesamte Flotte abdecken. (Für die grundsätzliche Form von Quelle → Pipeline → Ziel siehe Was ist eine Telemetrie-Pipeline?.)
Der Ansatz: der Collector ist der Vereinheitlicher
Weder Windows noch Linux stellt „verfügbare Updates” von Haus aus als OTLP-Metrik bereit,
also erzeugt man dieses Signal lokal und lässt den Collector es aufnehmen und
normalisieren. Der robusteste, betriebssystemübergreifende Weg nutzt die Exporter, die
möglicherweise ohnehin schon laufen – der prometheus-Receiver des Collectors scrapt
sie, versieht jeden Stream mit os.type und host.name und exportiert einen einzigen
OTLP-Feed an Grafana.
Windows – der update-Collector von windows_exporter
windows_exporter bringt einen
update-Collector mit, der die Anzahl ausstehender Updates meldet (und wie lange die
letzte Suche her ist). Aktivieren Sie ihn und richten Sie den OTel Collector darauf aus:
receivers:
  prometheus/windows:
    config:
      scrape_configs:
        - job_name: windows-updates
          scrape_interval: 5m
          static_configs:
            - targets: ["localhost:9182"]   # windows_exporter with --collectors.enabled=...,update
processors:
  resourcedetection:
    detectors: [system]          # host.name, os.type=windows
  batch:
exporters:
  otlphttp/grafana:
    endpoint: "https://otlp-gateway-<zone>.grafana.net/otlp"
    headers: { Authorization: "Basic <base64 instanceID:token>" }
service:
  pipelines:
    metrics:
      receivers: [prometheus/windows]
      processors: [resourcedetection, batch]
      exporters: [otlphttp/grafana]
Linux – der Textfile-Collector von node_exporter
Unter Linux ist das kanonische Muster der Textfile-Collector von
node_exporter: Ein Cron-Job führt ein
kleines Skript aus, das den Update-Status in eine .prom-Datei schreibt, und node_exporter
liefert sie aus. Die bekannten apt/yum-Skripte geben Metriken wie
apt_upgrades_pending, apt_security_upgrades_pending und node_reboot_required aus:
# /etc/cron.hourly/update-metrics  (Debian/Ubuntu example)
OUT=/var/lib/node_exporter/textfile/updates.prom
pending=$(apt-get -s upgrade | grep -c '^Inst')
security=$(apt-get -s upgrade | grep -ci security)
reboot=$([ -f /var/run/reboot-required ] && echo 1 || echo 0)
cat > "$OUT.tmp" <<EOF
updates_pending $pending
updates_security_pending $security
node_reboot_required $reboot
EOF
mv "$OUT.tmp" "$OUT"
Anschliessend scrapt der OTel Collector node_exporter (localhost:9100) genau wie den
Windows-Job oben – dieselbe resourcedetection + otlphttp/grafana, nur mit
os.type=linux.
Wer keine Prometheus-Exporter betreiben möchte, lässt die geplante Aufgabe (Windows) oder
den Cron-Job (Linux) eine einzeilige JSON-Statusdatei schreiben und liest sie mit dem
filelog-Receiver des Collectors in Loki ein. Man verliert die saubere numerische
Zeitreihe, behält aber einen betriebssystemübergreifenden Datensatz pro Host, den man
abfragen und auf den man alarmieren kann – ganz ohne zusätzliche Daemons.
Ein Dashboard, ein Alarm, beide Betriebssysteme
Weil jeder Host dieselben vier Signale in einem Backend ablegt – versehen mit host.name
und os.type – ist die Grafana-Seite tatsächlich betriebssystemunabhängig:
- Eine Flottentabelle: Hostname, Betriebssystem, ausstehende Updates, ausstehende Sicherheitsupdates, Reboot erforderlich, Tage seit dem letzten Patch – sortierbar, sodass die schlimmsten Fälle nach oben rücken.
- Eine Compliance-Kennzahl: Prozentsatz der Flotte ohne ausstehende Sicherheitsupdates.
- Eine Alarmregel, die auslöst, wenn irgendein Host seit mehr als N Tagen Sicherheitsupdates ausstehen hat oder ein Produktionshost auf einen Reboot wartet – Windows und Linux abgedeckt vom selben Ausdruck.
Das ist der Gewinn, den der Ansatz mit verstreuten Werkzeugen nicht liefern kann: „Welche Server sind im Rückstand, über den gesamten Bestand hinweg” wird zu einer gespeicherten Abfrage statt zu einem Nachmittag.
Der flottenweite Rollout
Die Krux im Massstab ist, dass die Konfiguration je nach Betriebssystem unterschiedlich ist – Windows-Collectors scrapen windows_exporter, Linux-Collectors scrapen node_exporter – und das händische Editieren von YAML auf jeder Box per RDP oder SSH ist genau die Fleissarbeit, die das Ganze verhindert.
Hier verdient sich eine Control Plane ihren Platz. Der Collector spricht OpAMP, sodass LinkMesh die Windows-Update-Monitoring-Konfiguration auf die Windows-Collectors und die Linux-Variante auf die Linux-Collectors von einer Stelle aus verteilen kann – jeden Host mit einem Token registrieren, die Betriebssystemvariante wählen, Vorschau ansehen und ausrollen, wobei jede Änderung versioniert und auditiert wird. Es ist dieselbe Flottenverwaltung wie beim Rest der Telemetrie, jetzt auch für den Patch-Status. (Passt natürlich gut zum Monitoring von Windows Server selbst in Grafana.)
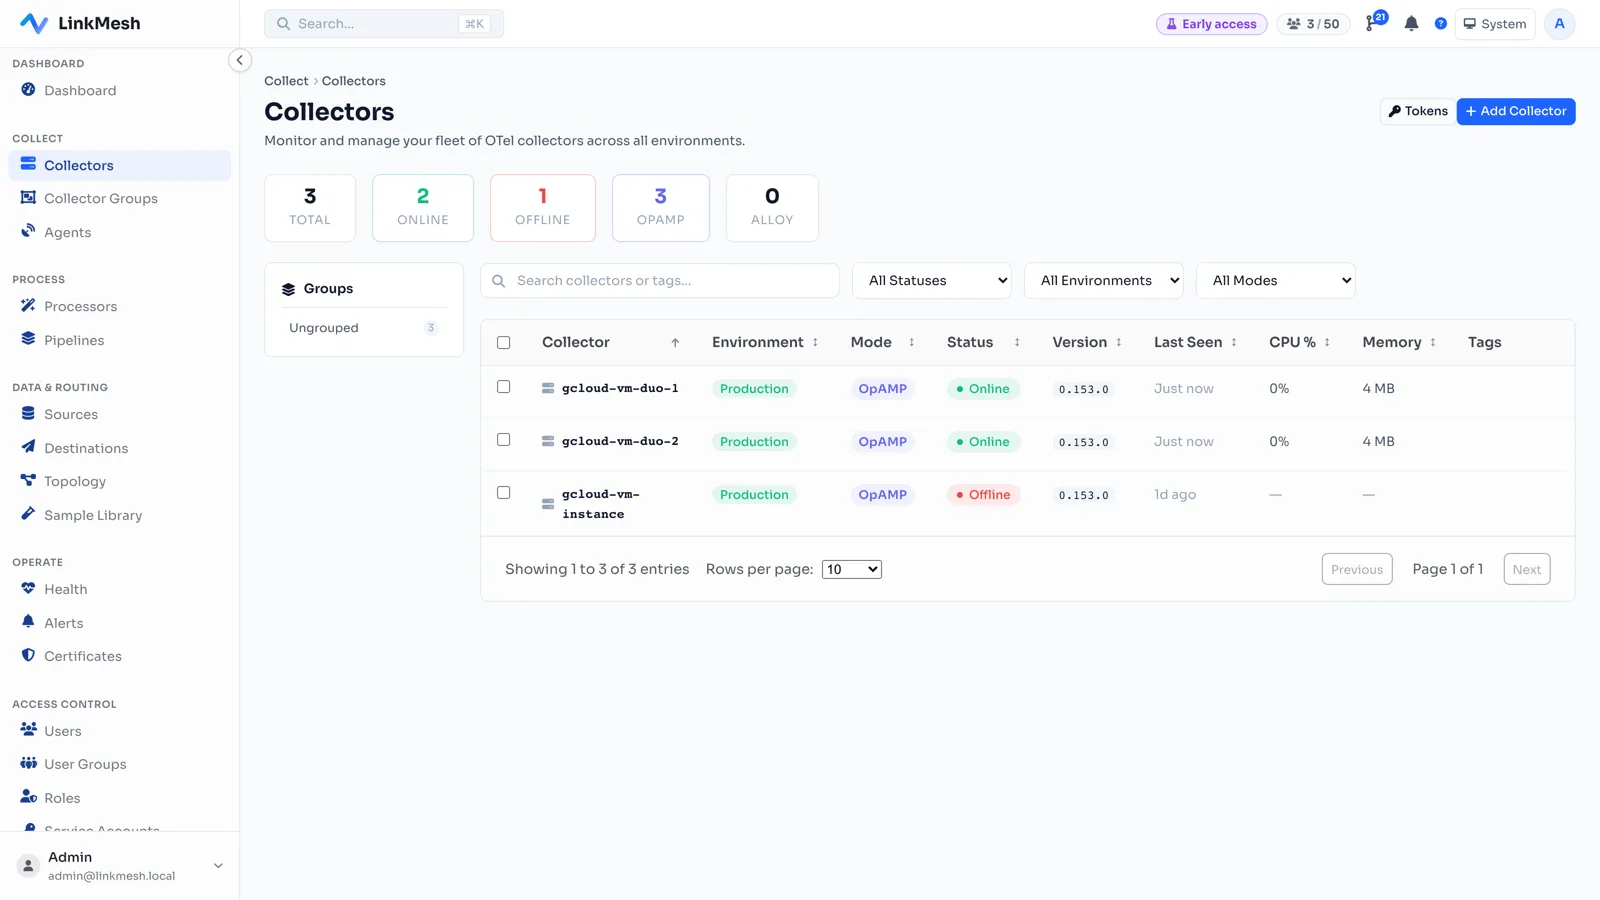
Die Telemetrie fliesst direkt von jedem Host zu Grafana und bleibt in Ihrem Netzwerk; LinkMesh verwaltet nur die Konfiguration, und es ist pro verwaltetem Collector abgerechnet, nicht pro Gigabyte – sodass eine grosse gemischte Flotte nicht zur Volumenrechnung wird.
Wo anfangen
- Die Signalquelle wählen – windows_exporter
update+ node_exporter textfile für saubere Metriken, oder ein Skript +filelog, wenn man keine Exporter betreiben möchte. - Vom lokalen Collector scrapen und mit
resourcedetectiontaggen, damitos.typeundhost.namemitkommen. - Die Flottentabelle und einen Alarm bauen in Grafana über beide Betriebssysteme.
- Die betriebssystemspezifische Konfiguration ausrollen über OpAMP, damit jeder neue Host automatisch meldet.
Patch-Compliance braucht kein eigenes Silo. Die Pipeline, die ohnehin schon für Observability läuft, kann auch den Update-Status tragen – und sobald sie das tut, ist „Sind wir gepatcht?” ein Dashboard, für Windows und Linux gleichermassen.
LinkMesh verteilt betriebssystemspezifische Collector-Konfiguration an jeden Windows- und Linux-Host von einer einzigen selbst gehosteten Control Plane – registrieren, Variante wählen, Vorschau ansehen und über OpAMP ausrollen, abgerechnet pro Collector statt pro Gigabyte. Stellen Sie eine auf in wenigen Minuten, oder sehen Sie sich an, was sie kann.