
 LinkMeshObservability Data Collection Management
OTel-Collector-Onboarding
Daten hereinzuholen ist die andere Hälfte der Flottenverwaltung — alles, bevor die Config-Datei existiert.
 Philippe Braxmeier← Zurück zum Blog
Jedes Gespräch über die Verwaltung einer OpenTelemetry-Collector-Flotte ist ein Gespräch darüber, Konfiguration hinauszuschieben: ein Control Plane, viele Collectors, die Konfiguration an einer Stelle ändern und zusehen, wie sie überall ankommt. Dieses Problem ist gut verstanden und 2026 gut abgedeckt — von uns und von einigen anderen.
Es ist aber nur die halbe Arbeit. Die andere Hälfte ist das Onboarding von OTel Collectors: herausfinden, was ein Host tatsächlich zu bieten hat, wie diese Log-Zeilen aussehen, was eine Pipeline mit ihnen macht und ob überhaupt etwas angekommen ist. Diese Hälfte taucht selten in einer Funktionsmatrix auf, und genau dort gehen die Stunden hin.
TL;DR — Config-raus und Daten-rein sind zwei verschiedene Achsen, und die meisten Werkzeuge zur Flottenverwaltung adressieren nur die erste. Auf der Config-raus-Achse tun Grafana Fleet Management und LinkMesh im Wesentlichen dasselbe. Auf der Daten-rein-Achse arbeiten sie unterschiedlich: Das Modell von Grafana erwartet eine Konfiguration, die Sie bereits geschrieben haben, und weist sie über Attribut-Matching zu. LinkMesh untersucht zuerst den Host, liest Proben aus der echten Datei, zeigt die Wirkung der Pipeline auf diese Proben als Vorschau und erzeugt die Konfiguration aus dem, was Sie ausgewählt haben. Wenn Sie bereits genau wissen, was auf jedem Host liegt, ist der Unterschied klein. Wenn nicht, ist es der grösste Teil der Arbeit.
Flottenverwaltung löst die zweite Hälfte zuerst
So sieht das Problem aus, in der Reihenfolge, in der Sie ihm tatsächlich begegnen:
- Ein Host existiert, und etwas darauf erzeugt Telemetrie.
- Sie finden heraus, was und wo.
- Sie klären, wie die Daten aussehen und was mit ihnen geschehen soll.
- Sie schreiben eine Collector-Konfiguration, die genau das ausdrückt.
- Sie bringen diese Konfiguration auf jeden Collector, der sie braucht, und halten sie aktuell.
Flottenverwaltung — unsere eingeschlossen — ist sehr gut in Schritt 5. Zentrale Konfigurationsverteilung, Versionshistorie, attributbasierte Zuweisung, Zustands- und Durchsatzüberwachung: Das ist eine gelöste Kategorie, und wir haben beschrieben, warum die interessante Frage dort lautet, wo der Control Plane läuft, und nicht, was er tut.
Die Schritte 2 bis 4 sind ein anderes Problem, und sie werden nicht einfacher, weil Schritt 5 gelöst ist. Sie werden sichtbarer: Sobald der Rollout sofort passiert, ist die Woche, in der Sie herausgefunden haben, was ausgerollt werden soll, die ganze verbleibende Arbeit.
Was OTel-Collector-Onboarding tatsächlich kostet
Einen Host zu onboarden, den Sie gestern aufgesetzt haben, ist trivial. Vierhundert Hosts zu onboarden, von denen ein Drittel älter ist als alle, die heute im Team arbeiten, ist es nicht — und der Aufwand steckt nicht im YAML. Er steckt in den Fragen, deren Antworten das YAML voraussetzt:
- Welche Dateien auf dieser Maschine sind Logs, im Gegensatz zu dem, was sie rotiert, dem Archiv des letzten Quartals und der 4-GB-Datei, die seit 2023 niemand gelesen hat?
- Ist das Log dieser Anwendung ein Ereignis pro Zeile oder ein Ereignis pro Stacktrace, verteilt über dreissig Zeilen?
- Wenn ich das durch dieselbe Parsing-Pipeline schicke wie die anderen
Java-Services, kommt es richtig heraus — oder als vierhunderttausend Datensätze
mit leerem
body? - Wenn ich es einschalte, kommt überhaupt etwas an?
Die traditionelle Antwort auf alle vier lautet: raten, ausrollen, die eigenen Logs des Collectors lesen, anpassen, erneut ausrollen. Diese Schleife ist langsam, auf eine Weise, die in keinem Architekturdiagramm auftaucht, und sie wird umso langsamer, je weniger Sie über die Umgebung wissen — genau in dem Fall also, in dem Onboarding am meisten zählt.
Zwei Modelle: selbst geschriebene Config oder ein Onboarding-Workflow
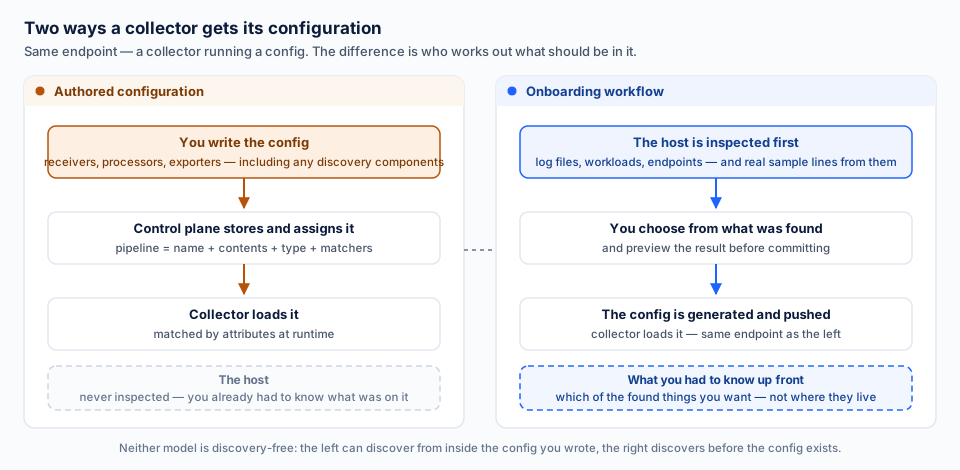
Die lohnende Unterscheidung ist nicht «hat Discovery» gegenüber «hat keine Discovery». Diese Einordnung ist falsch, und es lohnt sich, genau zu sagen, warum.
Das Modell von Grafana. Alloy bringt echte Discovery-Komponenten mit —
discovery.kubernetes, discovery.docker, discovery.relabel und weitere —, und
sie leisten zur Laufzeit echte Arbeit. Aber sie sind Komponenten innerhalb einer
Konfiguration, die Sie geschrieben haben. Die Arbeitseinheit von Fleet
Management ist die Konfigurations-Pipeline, und laut Grafanas eigener
Architektur-Dokumentation
bestehen Pipelines aus «a unique name, the components for the collector to load
and run, a configuration type, and a list of matchers that match collectors with
the pipeline». Das Terraform-Beispiel in der
Dokumentation
macht die Form deutlich: contents = file("config.alloy"). Die Arbeit des
Control Plane beginnt, sobald diese Datei existiert, und sein cleverer Teil ist
das Matching — die Entscheidung, welche Collectors welche Pipeline erhalten,
nach Attributen.
Das ist ein gutes Design, und für eine Flotte gut verstandener, homogener Hosts ist es vermutlich das richtige. Discovery in der Config ist ausdrucksstärker als jede Oberfläche und wird zur Laufzeit laufend neu ausgewertet, was ein einmaliger Onboarding-Schritt nicht tut.
Das Onboarding-Workflow-Modell. Der andere Ansatz dreht die Reihenfolge um: Der Control Plane sieht sich den Host an, bevor die Konfiguration existiert, zeigt Ihnen, was er gefunden hat, lässt Sie eine Pipeline gegen echte Daten von dort testen und schreibt dann die Konfiguration für Ihre Auswahl. Discovery geschieht als Workflow im Control Plane statt als Laufzeitkomponente, und das Ergebnis ist eine Config-Datei, die Sie nicht selbst entwerfen mussten.
Keines der beiden Modelle kommt ohne Discovery aus. Der Unterschied ist, wann Discovery läuft und wer die Antwort bereits kennen muss.
Wie das in LinkMesh aussieht
Vier Schritte, und die Konfigurationsdatei ist der letzte.
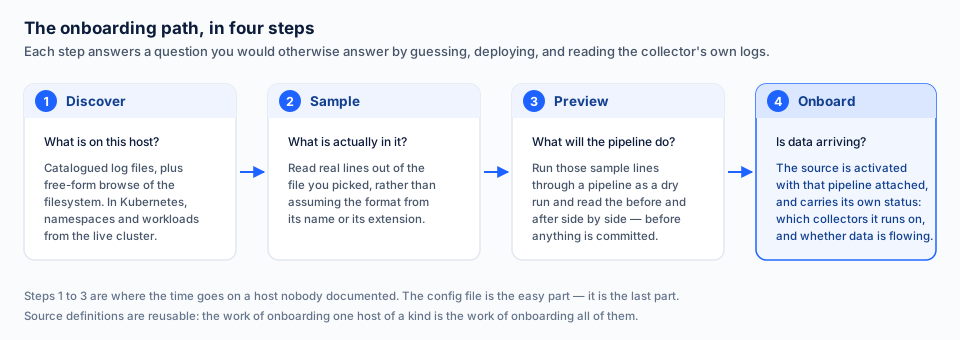
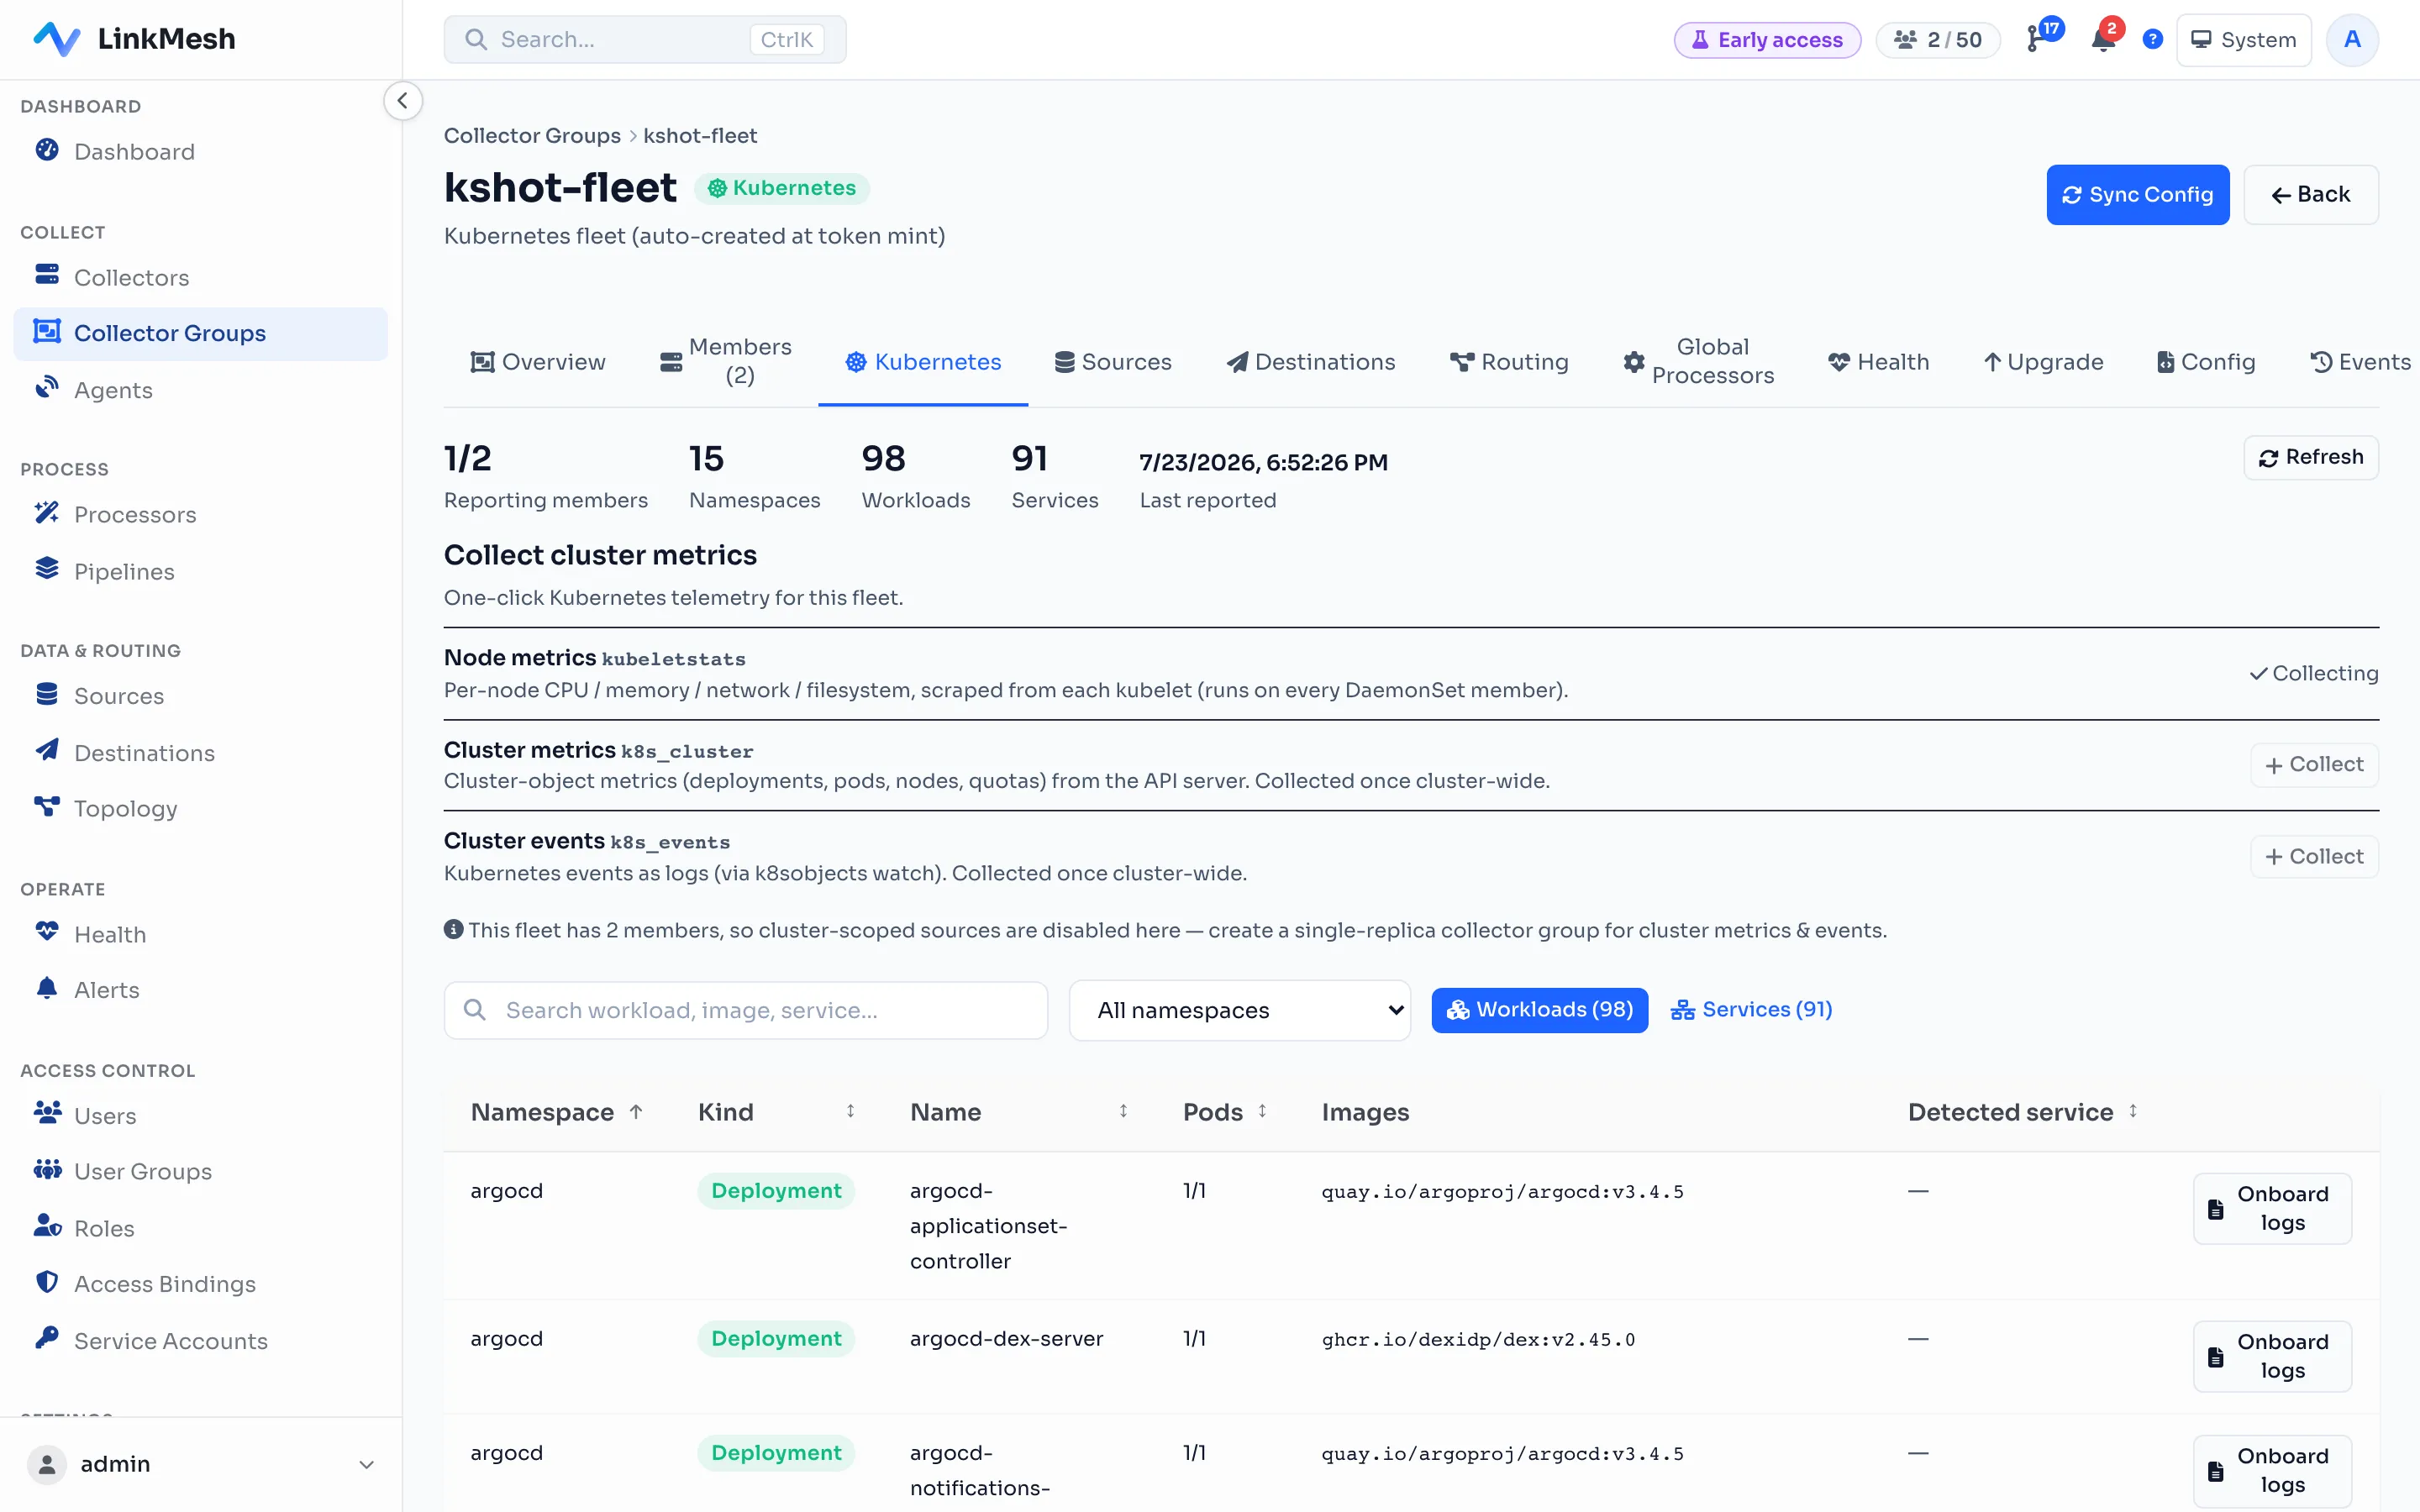
Entdecken. Durchsuchen Sie die Log-Dateien eines Hosts — sowohl die katalogisierten als auch frei durch das Dateisystem, denn die Datei, die Sie suchen, ist regelmässig nicht die, die jemand katalogisiert hat. Auf Kubernetes listet derselbe Schritt den laufenden Cluster auf: Namespaces, dann Workloads, dann Onboarding von Pod-Logs und Cluster-Metriken mit einem Klick.
Proben lesen. Lesen Sie echte Zeilen aus der gewählten Datei. Das ist eine kleine Funktion, die eine grosse Klasse von Fehlern beseitigt, denn das Format einer Log-Datei ist eine Eigenschaft der Datei, nicht ihres Namens.
Vorschau. Nehmen Sie diese Probezeilen, schicken Sie sie als Probelauf durch eine Pipeline, und lesen Sie Vorher und Nachher nebeneinander. Sie sehen Ihre eigenen Daten, transformiert durch genau die Prozessoren, die in Produktion laufen werden, bevor irgendetwas davon übernommen wird — damit beantworten Sie die Frage «kommt es richtig heraus» dann, wenn die Antwort billig ist, und nicht erst nach einem Deployment. (Sobald Daten fliessen, steht dieselbe Prüfung auch für Live-Traffic statt für Proben zur Verfügung.)
Onboarden. Aktivieren Sie die Quelle mit bereits angehängter Pipeline. Die Quelle selbst ist eine wiederverwendbare Definition — File-Tail, Syslog, TCP, OTLP, Windows Event Log, Prometheus-Endpunkte — mit Parameter-Überschreibungen pro Host. Die Arbeit, einen Host einer Art zu onboarden, ist damit der grösste Teil der Arbeit, alle zu onboarden. Jede Quelle trägt anschliessend ihren eigenen Status: auf welchen Collectors sie aktiv ist und ob kürzlich Daten angekommen sind. Diese letzte Spalte beantwortet Frage vier, und sie ist der Grund, warum das Titelbild dieses Beitrags eine langweilige Tabelle ist.
Das unordentliche Ergebnis zu parsen, ist ein eigenes Handwerk, das wir separat beschrieben haben: mehrzeilige Stacktraces zu einzelnen Ereignissen zusammenfassen und gerade genug parsen, um sie abfragen zu können.
Wo dieses Modell an seine Grenze kommt
Der ehrliche Umfang, denn einem Control Plane, der seine Grenzen benennt, lässt sich leichter vertrauen als einem, der es nicht tut:
- Discovery sagt Ihnen, was da ist, nicht was es bedeutet. Es findet die Datei und zeigt Ihnen ihre Zeilen. Zu entscheiden, dass diese Zeilen das Audit-Log des Zahlungsdienstes sind und wichtiger als die anderen, bleibt Ihr Urteil.
- Proben lesen einen begrenzten Ausschnitt, nicht die ganze Datei. Ein Format, das nur in den 0,1 % der Zeilen vorkommt, die niemand gelesen hat, wird Sie trotzdem überraschen.
- Es sagt Ihnen nicht, was eine Quelle kosten wird. Es gibt keine Volumenschätzung, bevor Sie etwas einschalten; Sie schalten es ein und beobachten dann den Durchsatz.
- Onboarding ist ein Workflow zu einem Zeitpunkt, kein fortlaufender. Ein Host, der nächsten Monat eine neue Log-Datei bekommt, onboardet sich nicht selbst — genau in diesem Fall hat eine Discovery-Komponente zur Laufzeit in einer Config den Vorteil.
Was wir nicht behaupten
- Nicht, dass Grafana Fleet Management keine Discovery hat. Die Discovery-Komponenten von Alloy sind echt und gut, und insbesondere für Kubernetes werden sie zur Laufzeit neu ausgewertet, was ein Onboarding-Workflow nicht tut.
- Nicht, dass diese Achse jede Evaluation entscheidet. Wenn Ihre Hosts einheitlich und gut dokumentiert sind, ist selbst geschriebene Konfiguration weniger Aufwand, und Sie sollten sie bevorzugen.
- Keine Aussage über die Roadmap von irgendwem. Alles oben Beschriebene ist heute im Produkt; alles nicht Beschriebene wird nicht versprochen.
- Kein Preisargument. Grafana Fleet Management ist in einem kostenlosen Grafana-Cloud-Tarif verfügbar, und wir konkurrieren nicht über den Preis damit.
Wählen Sie danach, welche Hälfte schmerzt
Zwei Fragen, und meist wissen Sie es nach der ersten:
- Wissen Sie bereits, was auf Ihren Hosts liegt? Wenn ja — eine dokumentierte, einheitliche Umgebung —, ist die Onboarding-Achse für Sie wenig wert, und Sie sollten auf der Config-raus-Achse entscheiden, wo die entscheidende Frage lautet, wo Ihr Control Plane läuft.
- Ist der grösste Teil Ihrer Umgebung älter als Ihre Observability-Praxis? Wenn ja, ist die Schleife aus Entdecken, Proben lesen und Vorschau keine Komfortfunktion. Sie ist der Unterschied, ob Sie einen unbekannten Host an einem Nachmittag onboarden oder in vierzehn Tagen.
Die erste Achse betrifft, wo Ihre Flotten-Metadaten liegen. Diese betrifft, wie viel Sie bereits wissen müssen, bevor das Werkzeug nützlich wird. Die beiden sind unabhängig, und ein Werkzeug zur Flottenverwaltung kann auf der einen stark und auf der anderen gleichgültig sein.
Wenn die zweite Frage Ihre ist, können Sie LinkMesh noch heute Nachmittag auf einen Host richten und sehen, was es findet — herunterladen und ausprobieren, kostenlos für die ersten 25 Collectors nach einer Registrierung ohne Kreditkarte im OpenSight Customer Portal (5 ohne), ohne Termin. Für die erste Achse lesen Sie Grafana Fleet Management vs LinkMesh; für das grössere Bild, wofür ein Flotten-Control-Plane da ist, lesen Sie Verwaltung von OpenTelemetry-Collector-Flotten.
Die Angaben zu Mitbewerbern in diesem Beitrag wurden am 13.09.2026 anhand der öffentlichen Dokumentation von Grafana geprüft.