
 LinkMeshObservability Data Collection Management
New Relic → OpenTelemetry
Die Agents ersetzen. Das Backend auf OTLP behalten. Die Ingestion-Rechnung senken.
 Roman Hüsler← Zurück zum Blog
New Relic ist eine leistungsfähige All-in-one-Observability-Plattform, und für viele Teams erledigt sie die Aufgabe gut. Zwei Dinge treiben Teams trotzdem dazu, sich den Ausgang anzusehen: die nutzungsbasierte Rechnung – bepreist nach Datenaufnahme pro GB plus abrechenbaren Nutzern –, die mit der Coverage steigt, und der Agent-Bestand, eine Flotte von Sprach-APM-Agents und dem Infrastructure-Agent, die New Relics Protokoll sprechen und New Relic und nichts anderes füttern.
Hier ist der Teil, der eine New-Relic-Migration ungewöhnlich sanft macht: OpenTelemetry ist kein Ausbruch, den Sie abschliessen müssen, bevor Sie irgendeinen Wert bekommen, und New Relic nimmt OTLP nativ auf. Das bedeutet, Sie können eine herstellerneutrale Collection-Ebene unter Ihre bestehende Pipeline legen, New Relic als eines von mehreren Backends über seinen eigenen OTLP-Endpoint weiterlaufen lassen und das Volumen kürzen, für dessen Aufnahme Sie zahlen – alles, bevor Sie irgendetwas über das Backend entscheiden. Die umfassendere Argumentation finden Sie in Vendor-Lock-in mit OpenTelemetry reduzieren; dieser Beitrag ist das New-Relic-spezifische Playbook.
Plattform-, SRE- und Architektur-Teams, die die New-Relic-APM- und -Infrastructure-Agents betreiben und die Kosten pro GB Aufnahme und pro Nutzer kontrollieren sowie nicht länger an New-Relic-only-Agents gebunden sein wollen. Voraussetzungen: Sie können einen Collector auf Ihren Hosts/Ihrem Cluster bereitstellen, und Sie haben einen New-Relic-Lizenz-(Ingest-)Key, um New Relic während des Parallelbetriebs weiter zu füttern, plus ein Kandidaten-OTLP-Backend zum Vergleich.
Was zu OpenTelemetry migriert – und was nicht
OTel ersetzt die Agents und das Wire-Format von New Relic. Es ersetzt nicht das Backend von New Relic, dessen Query-Sprache oder die darauf aufsetzenden Analytics – die werden beibehalten, anderswo neu aufgebaut oder bewusst aufgegeben:
| New-Relic-Fähigkeit | Zu OTel migrieren? | Anmerkungen |
|---|---|---|
| Infrastructure-Metriken | Ja | hostmetrics (+ kubeletstats) ersetzen die Core-Collection des Infrastructure-Agents. |
| APM (Sprach-Agents: Java, .NET, Node, Python, Go, Ruby) | Meist | OTel-SDKs / Auto-Instrumentierung ersetzen die Sprach-Agents; Span- und Service-Benennung validieren. |
| Logs | Ja | filelog- / journald-Receiver ersetzen die Log-Forwarder; Parsing als Processors nachbauen. |
| On-Host-Integrationen (nri-*) | Oft | Viele bilden sich auf den prometheus-Receiver oder native OTel-Receiver ab; einige sind New-Relic-spezifisch. |
| Distributed Tracing | Meist | OTLP von Ende zu Ende; Trace-Context-Propagation und Entity-Mapping prüfen. |
| Custom Attributes / Entity-Tags | Ja | Abbildung auf service.name, deployment.environment.name und Resource-Attribute. |
| NRQL-Queries & gespeicherte Views | Nein | Die Query-Sprache ist backend-spezifisch; neu aufbauen, wenn Sie New Relic verlassen. |
| Dashboards | Nein | Im neuen Backend neu aufbauen, oder New Relic dafür behalten. |
| Alerts / NRQL-Bedingungen | Nein | Separat zum Alerting des neuen Backends migrieren. |
| Applied Intelligence / Anomalieerkennung | Nein | Hersteller-Analytics; das Backend, zu dem Sie wechseln, liefert – falls überhaupt – eigene. |
| Backend-Speicherung & -Query (NRDB) | Nein | OTel ist kein Backend – hier lebt das verbleibende Lock-in. |
Die Faustregel: OTel bewältigt Collection (Metriken, Traces, Logs) und Resource-Attribution sauber. New-Relic-spezifische Produkte – NRQL, die Dashboards, Alert-Bedingungen, Applied Intelligence – sind nichts, was Sie „migrieren”; Sie behalten sie, ersetzen sie oder legen sie still. (Für die allgemeine Version siehe was OpenTelemetry ersetzen kann und was nicht.)
Die New-Relic-Bausteine auf ihre OTel-Äquivalente abbilden
Die Migration ist grösstenteils ein Komponente-für-Komponente-Austausch. Alles, was die New-Relic-Agents tun, hat ein Äquivalent nach offenem Standard:
| New Relic | OpenTelemetry-Äquivalent |
|---|---|
| Infrastructure-Agent (Host-Metriken) | OTel Collector mit hostmetrics- + kubeletstats-Receivern |
| APM-Sprach-Agents (Java, .NET, Node, Python, …) | OTel-SDKs / Auto-Instrumentierung, die OTLP emittieren |
| Log-Forwarding (Fluent-Bit-Plugin, Agent-Logs) | filelog- / journald-Receiver |
On-Host-Integrationen (nri-*) |
prometheus-Receiver (Scrape) + OTel-Receiver |
| Custom Attributes / Entity-Tags | resource- / attributes-Processors → service.name, deployment.environment.name |
| New-Relic-Backend (NRDB) | New Relic OTLP-Endpoint (otlphttp) – oder ein beliebiges OTLP-Backend |
Beachten Sie die letzte Zeile – sie ist das Schlupfloch, und bei New Relic ist es sauberer als
bei den meisten. Weil New Relic OTLP nativ aufnimmt, brauchen Sie überhaupt keinen
herstellerspezifischen Exporter: Der standardmässige otlphttp-Exporter des Collectors, auf
New Relics OTLP-Endpoint mit Ihrem Lizenz-Key gerichtet, schreibt direkt in NRDB. Sie müssen
New Relic nicht verlassen, um OpenTelemetry einzuführen – Sie stellen OTel zuerst davor,
lassen New Relic genau wie zuvor weiterlaufen und entscheiden über das Backend später.
Zwei New-Relic-spezifische Details werden Ihnen schaden, wenn Sie sie überspringen. Entity
Synthesis: New Relic baut Entities und Service-Maps aus bestimmten Attributen; stellen Sie
sicher, dass service.name, service.instance.id und Host-Identifier auf dem OTLP-Stream
vorhanden sind, sonst richten sich Ihre APM- und Infrastructure-Entities nicht so aus, wie sie
es unter den Agents taten. Metrik-Form: Die Sprach-Agents emittieren New Relics
dimensionale Metriken; OTel-SDKs emittieren Metriken nach OTel-Semantic-Conventions. Namen und
Einheiten unterscheiden sich, sodass jedes Dashboard oder jeder NRQL-Alert, der auf exakte
Metriknamen aufsetzt, eventuell angepasst werden muss – auditieren Sie Ihre wichtigsten Alerts
vor dem Cutover, nicht danach.
Schritt 1 – Die Agents durch einen Collector ersetzen, weiterhin New Relic füttern
Stellen Sie einen OTel Collector neben (oder anstelle) des Infrastructure-Agents bereit und
richten Sie Ihren OTLP-Export auf New Relic. Nutzer bemerken keinen Unterschied; die
Collection-Ebene ist jetzt offen. New Relics OTLP-Endpoint nimmt den standardmässigen
otlphttp-Exporter an – kein proprietärer Exporter erforderlich.
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318
  hostmetrics:
    collection_interval: 30s
    scrapers: { cpu: , memory: , disk: , network: , load: }

exporters:
  otlphttp/newrelic:
    endpoint: "https://otlp.nr-data.net"
    headers:
      api-key: "${NEW_RELIC_LICENSE_KEY}"

service:
  pipelines:
    metrics:
      receivers: [otlp, hostmetrics]
      exporters: [otlphttp/newrelic]
    traces:
      receivers: [otlp]
      exporters: [otlphttp/newrelic]
An diesem Punkt hat sich für Ihre Nutzer nichts geändert – Daten landen weiterhin in New Relic, im selben Account – aber die Collection-Ebene ist jetzt offen. Jede Verbesserung von hier an ist eine, die Sie aus einem proprietären Agent heraus nicht machen konnten.
Schritt 2 – Dual-Shipping zu New Relic und einem Kandidaten
Fügen Sie einen zweiten Exporter hinzu und senden Sie dieselbe Telemetrie an ein Kandidaten-OTLP-Backend. Jetzt können Sie Dashboards, Alert-Coverage und APM-Traces auf Live-Produktionsdaten vergleichen, wobei New Relic weiterhin das System of Record ist. Das ist der Parallelbetrieb, der die Migration sicher macht.
exporters:
  otlphttp/newrelic:
    endpoint: "https://otlp.nr-data.net"
    headers:
      api-key: "${NEW_RELIC_LICENSE_KEY}"
  otlphttp/candidate:
    endpoint: "https://backend.internal:4318"

service:
  pipelines:
    metrics:
      receivers: [otlp, hostmetrics]
      exporters: [otlphttp/newrelic, otlphttp/candidate]
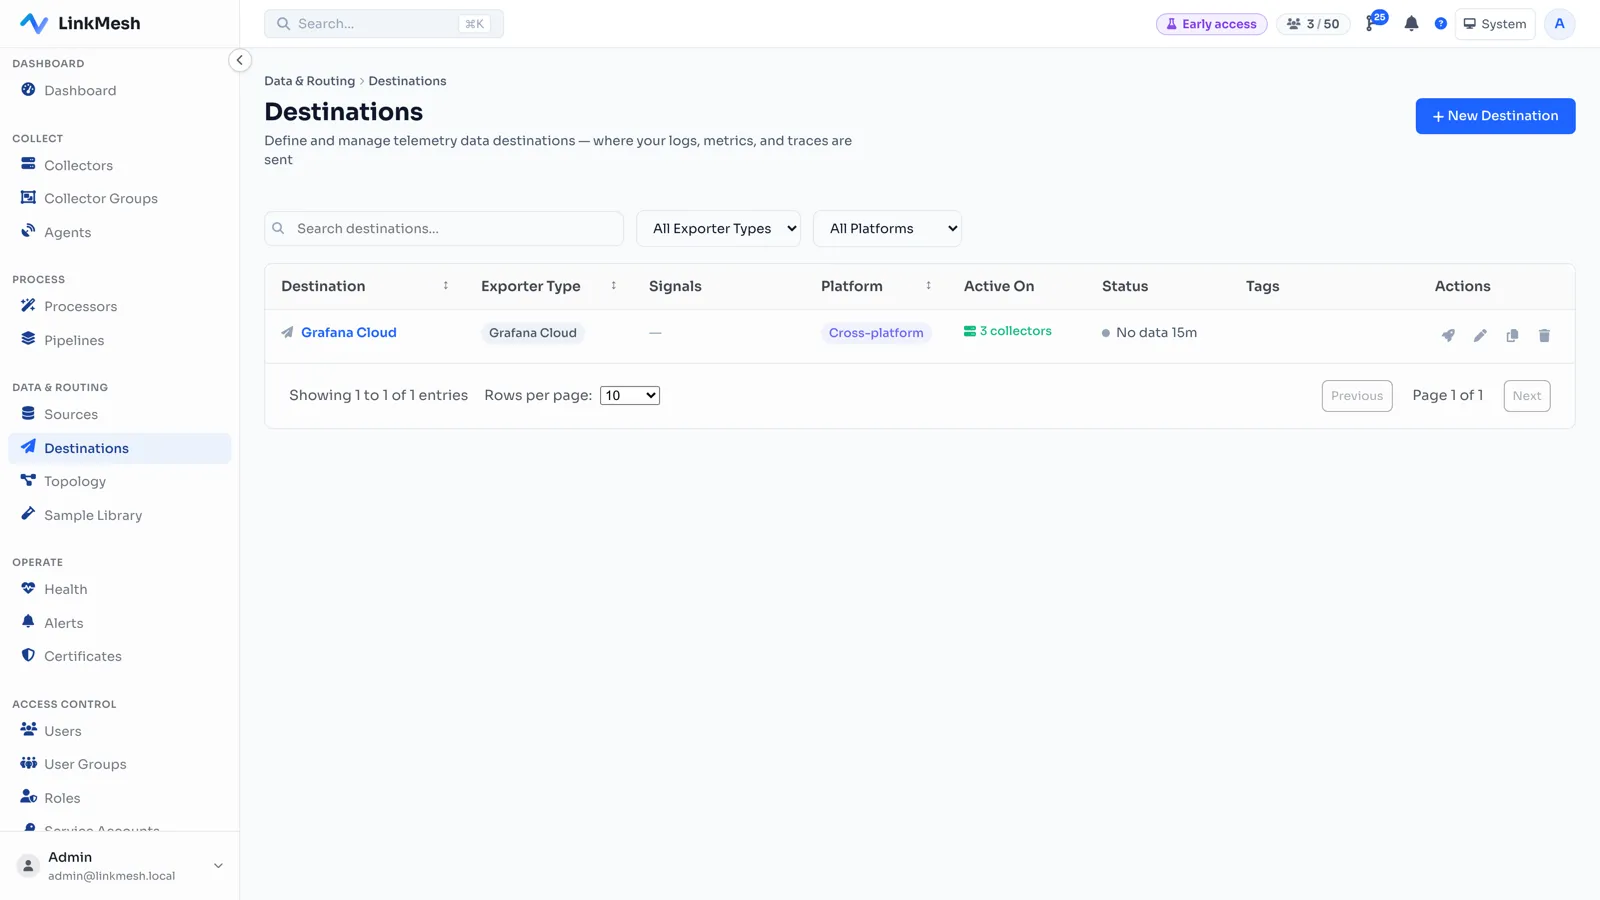
Das ist der Schritt, den ein proprietärer Agent schlicht nicht machen kann: einen Stream an zwei Backends zugleich senden. Er verwandelt eine New-Relic-Migration in einen graduellen, umkehrbaren Prozess statt eines Stichtags. So sieht ein konfiguriertes Ziel in LinkMesh aus:
Schritt 3 – Das Volumen kürzen, für dessen Aufnahme Sie zahlten
Hier zahlt sich die Migration aus. New Relic rechnet nach Datenaufnahme pro GB ab, ein grosser Anteil dessen, was Sie senden, ist also Rauschen, das Sie nie abfragen, für dessen Speicherung Sie aber zahlen. In einem proprietären Agent konnten Sie ein wenig tunen; in einem OTel Collector können Sie viel tun, an einem Ort, den Sie kontrollieren.
- Aufnahme pro GB. Filtern Sie Debug-Logs, Health-Check-Spam und geschwätzige Erfolgs-Events am Collector, bevor sie aufgenommen werden. Das ist der grösste, sicherste Schnitt – oft mehr als die Hälfte des Log-Volumens.
- Metriken mit hoher Kardinalität. Jede eindeutige Attribut-Kombination ist eine eigene Zeitreihe; ein einziges ausuferndes Label (eine User-ID, eine Request-ID, eine rohe URL) bläht das Volumen auf. Verwerfen oder aggregieren Sie es am Collector, bevor es sich vervielfacht.
- Redundante Traces. Samplen Sie hochvolumige Spans mit geringem Wert auf einen repräsentativen Anteil herunter, während Sie 100 % der Fehler behalten.
processors:
  # Drop sub-INFO logs before they're ingested
  filter/drop_debug:
    logs:
      log_record:
        - 'severity_number < SEVERITY_NUMBER_INFO'
  # Strip a high-cardinality attribute that inflates metric volume
  attributes/drop_cardinality:
    actions:
      - key: request_id
        action: delete
  # Sample a high-volume, low-value stream
  probabilistic_sampler:
    sampling_percentage: 20
Jeder am Collector verworfene Record ist ein Gigabyte, dessen Aufnahme New Relic Ihnen nie in Rechnung stellt. Die vollständige Methode – messen, filtern, samplen, routen – finden Sie in wie Sie Observability-Kosten senken. Sie können ausserdem PII vor dem Egress maskieren, was Payloads verkleinert und sensible Felder gleichzeitig aus einem Drittanbieter-Backend heraushält.
Schritt 4 – Die Flotte verwalten, nicht YAML von Hand bearbeiten
Hier ist der Haken, den niemand erwähnt: New Relics Agents kommen mit zentraler Konfiguration und Fleet Control. Rohe OTel Collectors nicht – von Haus aus synchronisieren Sie YAML von Hand über jeden Node, was ein Schritt rückwärts in der Verwaltbarkeit gegenüber New Relics Flotten-Tooling ist.
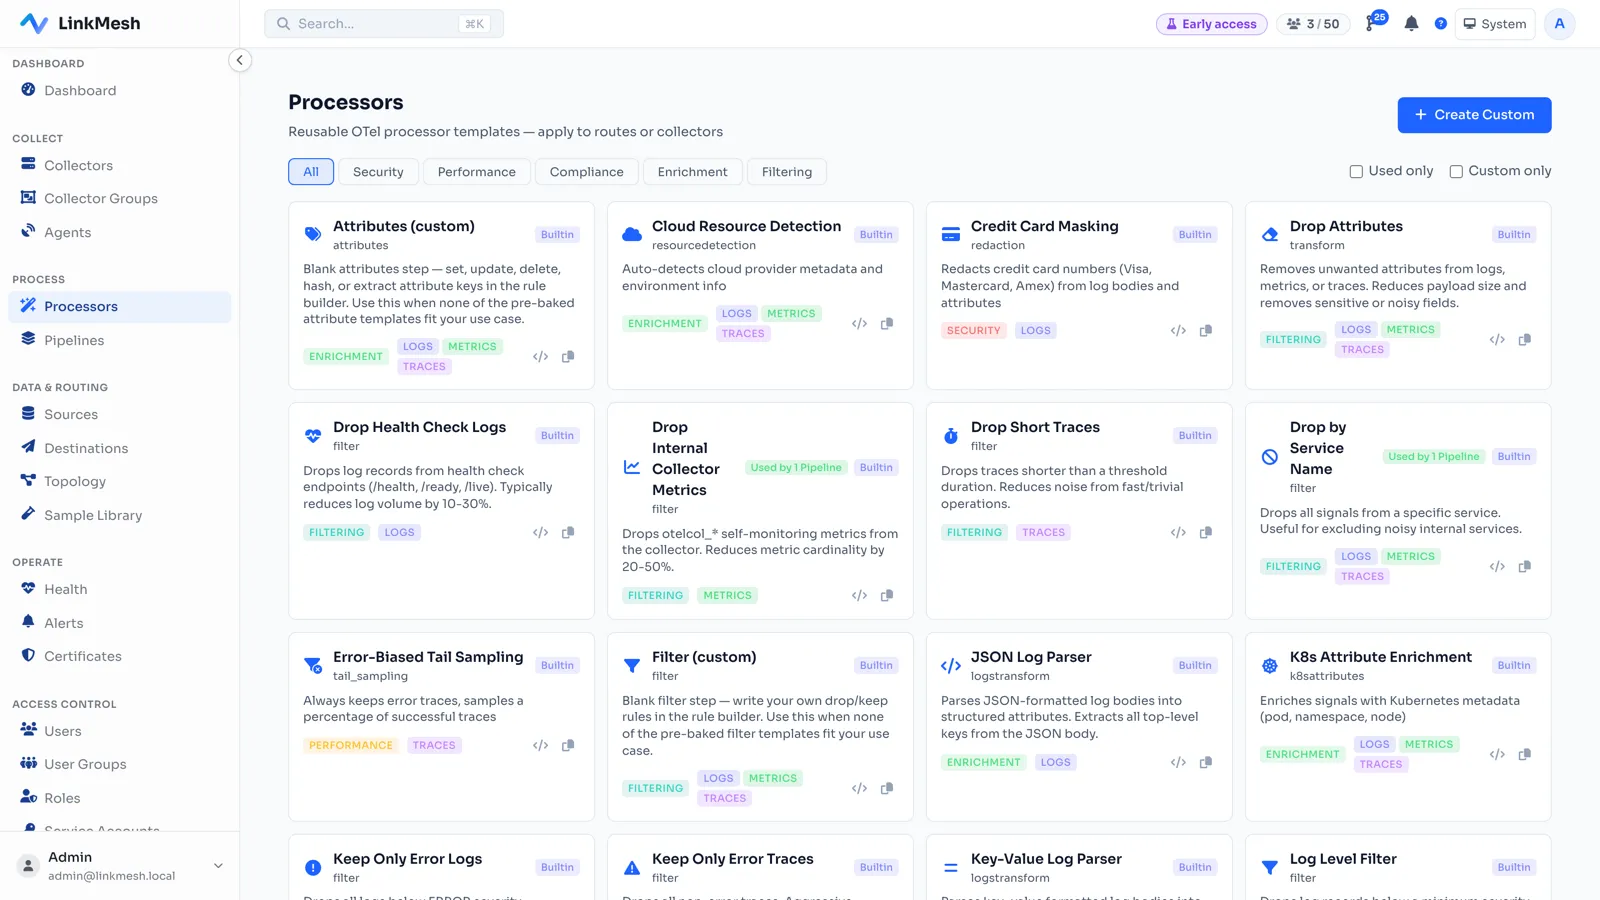
Akzeptieren Sie diesen Handel nicht. Verwalten Sie die Collector-Flotte von einer Control Plane aus, die OpAMP spricht. LinkMesh ist eine selbstgehostete: Richten Sie jeden Collector mit einem Token darauf, dann bauen Sie Sources, Processors und Routes in einer visuellen UI auf. Sie rendert und validiert die Config und rollt sie an die richtigen Nodes aus – mit Durchsatz pro Kante, sodass das gerade eingesparte Volumen eine Zahl ist, auf die Sie zeigen können, keine Hoffnung. Weil sie pro Collector abgerechnet wird, nicht pro GB, ist das Tool, das Ihren Ausbruch aus der Volumen-Preisgestaltung verwaltet, nicht selbst nach Volumen bemessen. Die Telemetrie fliesst direkt von Ihren Collectors zu Ihrem Backend und bleibt auf Ihrer Infrastruktur; die Control Plane verwaltet nur die Config, versioniert und auditiert im GitOps-Stil – siehe GitOps für Collector-Config.
Parität validieren, bevor Sie umsteigen
Dual-Shipping zu New Relic und einem Kandidaten bedeutet, dass Sie während der Überlappung in beide aufnehmen – validieren Sie also zügig und halten Sie das Fenster kurz. Die Checkliste:
- Metriken – vergleichen Sie Schlüsselmetriken und Zeitreihen-Zählungen zwischen den Agents und dem OTel-Stream über dasselbe Fenster; ein Kardinalitätsunterschied verändert, was Sie aufnehmen.
- Traces – bestätigen Sie, dass Service-Namen, Span-/Operation-Namen und Trace-Context-Propagation dem entsprechen, worauf Ihre APM-Views und Alerts aufsetzen (hier treten die Benennungsunterschiede zwischen Sprach-Agent und OTel-SDK zutage).
- Logs – prüfen Sie, dass Parsing,
service-/environment-Attribute und Log-zu-Trace-Korrelation den Umzug vom New-Relic-Log-Forwarding zu Collector-Processors überstanden haben. - Entity- & Resource-Metadaten – kontrollieren Sie, dass die Attribute
service.name,service.instance.id, Host und Environment vorhanden sind, damit Entity Synthesis und Filtern sich wie zuvor verhalten. - Timestamps – stichprobenartig prüfen, dass Event- und Span-Timestamps korrekt landen und nicht auf die Empfangszeit umgeschrieben werden.
- Alerts – richten Sie Ihre höchstpriorisierten NRQL-Bedingungen auf die OTel-gespeisten Daten neu aus und bestätigen Sie, dass sie weiterhin feuern; achten Sie auf Alerts, die exakte Metriknamen referenzieren.
- Verworfene Telemetrie – prüfen Sie die internen Metriken des Collectors auf abgelehnte/verworfene Daten, damit ein Filter nicht stillschweigend Signal verschluckt.
- Fehlerverhalten – starten Sie einen Collector neu und kappen Sie eine Backend-Verbindung; bestätigen Sie, dass der Collector puffert und ohne Datenverlust oder Verklemmen fortsetzt.
Einen Rollback-Plan haben
Weil Sie Dual-Shipping betrieben haben, ist Rollback eingebaut – aber machen Sie ihn explizit, bevor Sie irgendetwas umlegen:
- Behalten Sie die New-Relic-Agents (oder den
otlphttp/newrelic-Pfad) aktiv, bis der Kandidat die Validierung für einen vereinbarten Zeitraum besteht. Deinstallieren Sie nicht am ersten Tag. - Unabhängige Exporter – New Relic und der Kandidat sind separate Blöcke; verwerfen oder stellen Sie einen wieder her, ohne den anderen anzufassen.
- Definieren Sie Erfolgsschwellen – Metrik-/Trace-Parität, auslösende Prioritäts-Alerts, Volumen um den erwarteten Betrag gesenkt – bevor Sie irgendetwas entfernen.
- Behalten Sie die Fähigkeit umzuleiten. Falls der Kandidat sich fehlverhält, ist der New-Relic-OTLP-Exporter noch in der Pipeline (oder einen Config-Push entfernt), und Sie sind vollständig zurück.
- Stilllegen nach einem Beobachtungszeitraum, typischerweise ein bis zwei volle Geschäftszyklen nach dem Cutover, nicht in dem Moment, in dem Parität zum ersten Mal richtig aussieht.
Schritt 5 – Über New Relic zu Ihren Bedingungen entscheiden
Hier ist der wichtige Teil: Sobald Sie auf OTel sind, müssen Sie New Relic überhaupt nicht verlassen. Weil New Relic OTLP nativ aufnimmt, behalten viele Teams es für APM oder eine Teilmenge kritischer Services und routen den Rest – günstig zu speichernde Logs, archivierte Telemetrie – an ein zweites OTLP-Backend oder Object Storage. Der Sinn der Migration ist nicht zwingend „New Relic aufgeben”; es geht darum, Bleiben oder Gehen zu einer Wahl statt einer Gefangenschaft zu machen.
Wenn Sie doch umsteigen, ist es eine Exporter-Änderung, kein Re-Instrumentierungsprojekt. Ihre Daten sind OTLP, Ihre Flotte läuft auf OpAMP, und die nächste Backend-Entscheidung ist einen Config-Block entfernt.
Die Migration in fünf Schritten
- Die Agents ersetzen – OTel Collectors und SDKs bereitstellen, die über New Relics nativen OTLP-Endpoint nach New Relic exportieren. Für Nutzer ändert sich nichts.
- Dual-Shipping – ein Kandidaten-OTLP-Backend hinzufügen und auf Live-Daten vergleichen.
- Volumen kürzen – Logs filtern, Metriken mit hoher Kardinalität beschneiden und am Collector samplen, um die Aufnahme pro GB direkt anzugreifen.
- Validieren & Rollback behalten – die Checkliste abarbeiten, die Agents als Sicherheitsnetz behalten.
- Entscheiden – New Relic für das behalten, was es Ihnen wert ist, den Rest anderswohin routen oder vollständig umsteigen. Auf OTLP ist es Ihre Entscheidung.
Die New-Relic-Agents waren das Lock-in auf der Collection-Ebene und die Aufnahme-Rechnung war das Symptom. Verlagern Sie die Collection zu OpenTelemetry, und beides wird zu etwas, das Sie kontrollieren – während Sie in New Relic alles behalten, was analytisch noch seinen Platz verdient.
Der schwierige Teil ist, die Flotte durch den Cutover zu führen, ohne Config-Drift, während Sie Dual-Shipping zu New Relic und einem Kandidaten betreiben. LinkMesh ist eine selbstgehostete OpAMP-Control-Plane, die Collector-Config aufbaut, validiert, in der Vorschau zeigt und auditiert – mit Durchsatz pro Kante, sodass Sie das eingesparte Volumen (und die Kosten) belegen können. Abgerechnet pro Collector, nicht pro GB. Stellen Sie eine auf in wenigen Minuten, oder sehen Sie, was sie kann.