
 LinkMeshObservability Data Collection Management
KVM & libvirt → Grafana
Host-Metriken, Werte pro Domain und das libvirt-Journal – ein Collector pro Hypervisor.
 Roman Hüsler← Zurück zum Blog
Reines KVM ist der ehrliche Hypervisor: Es gibt virsh, ein Kernel-Modul – und sonst
nichts. Kein vCenter, kein Cluster-Web-UI, keine eingebauten Graphen. Genau deshalb
entscheiden sich viele dafür, und genau deshalb ist KVM-Monitoring etwas, das man
bauen muss statt einschalten. virsh domstats zeigt, was eine Domain gerade jetzt
tut; sobald jemand fragt „hat VM 7 schon vor der Migration geswappt?“, gibt es keine
Historie, mit der man antworten könnte.
Der OpenTelemetry Collector schließt diese Lücke mit einem systemd-Dienst pro
Hypervisor. Eine Einschränkung gehört in den ersten Absatz, weil sie den Aufbau dieser
Anleitung bestimmt: Der Collector hat einen nativen Receiver für VMware vCenter und
keinen für libvirt – wir haben die Receiver-Liste von contrib für diesen Beitrag
geprüft (Collector v0.164.0, 02.11.2026): Es gibt keinen libvirt-Receiver und auch
keine offene Komponente dafür. Host-Metriken und Logs kommen also direkt aus dem
Collector, die Werte pro VM aus einem libvirt-Exporter, den der Collector scrapt. Das
sind drei Receiver – und kein Agent in irgendeinem Gast.
Admins, die libvirt/KVM direkt betreiben – zwei Hypervisoren unter qemu:///system,
ein ganzes Rack davon oder die Hosts unter einer Orchestrierungsschicht, durch die
Sie nicht messen wollen. Benötigt werden root auf den Hosts und ein Grafana-Ziel
(self-hosted Grafana mit Prometheus/Loki oder der kostenlose Tarif von Grafana Cloud).
Kein Proxmox, kein OpenStack, kein oVirt nötig – wer eines davon betreibt, folgt
besser den Links unten: Dort gibt es jeweils einen besseren Weg als diesen.
Läuft über KVM eine Management-Schicht? Dann überwachen Sie diese Schicht und nicht den nackten Hypervisor: Proxmox VE mit OpenTelemetry und Grafana überwachen nutzt den nativen OTLP-Push von Proxmox, und OpenStack: Monitoring vs. Observability behandelt die Control-Plane-Dienste, die es bei reinem libvirt nicht gibt. Zum Vergleich der beiden Plattformen: OpenStack vs. Proxmox Observability. Wer von VMware kommt, wo ein nativer Receiver existiert: was aus dem Monitoring wird.
Was am Ende steht
- CPU (inklusive Steal und IO-Wait), Memory, Disks und Netzwerk jedes Hypervisors in einem Grafana-Dashboard, mit echter Aufbewahrung.
- Metriken pro Domain für jede VM – vCPU-Zeit und vCPU-Wait, Balloon- und RSS-Memory, Lese-/Schreib-Bytes und Latenz der Blockdevices, Bytes, Drops und Fehler der virtuellen NICs – direkt aus libvirt gelesen, ohne Agent in den Gästen.
- Kapazität und Belegung pro Storage-Pool, damit „der Images-Pool ist vollgelaufen” ein Trend ist, den Sie beobachtet haben, und kein Ausfall, den Sie entdeckt haben.
- Das libvirt-Journal aller Hosts an einer Stelle durchsuchbar –
libvirtdoder die modularen Daemonsvirtqemud/virtnetworkd/virtstoragedplusvirtlogd– statt sich per SSH mitjournalctldurchzuarbeiten. - Live-Migrationen als Metriken – das Einzige, was
virshim Nachhinein wirklich nicht mehr zeigen kann.
Wie das auf Bekanntes abbildet
Nichts davon ist ein neues Konzept – es ist das libvirt-Werkzeug, das Sie kennen, auf Grafana gerichtet:
| Sie kennen es als … | OpenTelemetry holt es über … | In der Config heißt es |
|---|---|---|
htop, iostat, df -h auf dem Host |
den Host-Metrics-Collector | hostmetrics |
virsh domstats, virsh domblkstat |
einen gescrapten libvirt-Exporter | prometheus/libvirt |
virsh pool-list --details |
die Pool-Metriken desselben Exporters | prometheus/libvirt |
journalctl -u libvirtd |
den journald-Reader | journald |
ps aux auf die qemu-Prozesse |
den Process-Scraper der Host-Metrics | hostmetrics / process |
| Einen externen Metrik-Speicher | das Ziel, an das gesendet wird | exporters |
Schritt 1 – Eine gepinnte Collector-Version auf jedem Hypervisor installieren
Ein KVM-Host ist eine normale Linux-Maschine, der Collector installiert sich also wie
jedes andere Paket. Wählen Sie eine getestete Version aus den
offiziellen Releases
– die Assets tragen die Version im Dateinamen, es gibt also keine stabile
„latest”-URL, und eine getestete Version zu pinnen ist ohnehin besser, als zu
installieren, was letzte Nacht erschienen ist. Das Beispiel nutzt 0.164.0; setzen Sie
die von Ihnen gewählte Version ein:
OTEL_VERSION="0.164.0"

wget "https://github.com/open-telemetry/opentelemetry-collector-releases/releases/download/v${OTEL_VERSION}/otelcol-contrib_${OTEL_VERSION}_linux_amd64.deb"

dpkg -i "otelcol-contrib_${OTEL_VERSION}_linux_amd64.deb"
(Für RHEL-artige Hosts gibt es ein RPM-Asset – der Rest dieser Anleitung ist identisch.)
Sie brauchen den contrib-Build: Der journald-Reader und der
prometheus-Receiver stecken dort, keiner von beiden ist in der Core-Distribution.
Das Paket registriert einen systemd-Dienst (otelcol-contrib), der unter einem eigenen
unprivilegierten Benutzer läuft – ebenfalls otelcol-contrib. Dieses Detail wird in
Schritt 4 und Schritt 5 wichtig. Die Konfiguration liegt unter
/etc/otelcol-contrib/config.yaml; das ist die eine Datei, die Sie bearbeiten.
Schritt 2 – Backend wählen: self-hosted oder Grafana Cloud
Self-hosted Prometheus + Loki – die naheliegende Wahl bei reinem KVM und der Weg, auf dem die Telemetrie das eigene Netz nie verlässt. Zwei Dinge sind einzuschalten:
- Prometheus muss mit
--web.enable-otlp-receivergestartet werden, um OTLP anzunehmen; der Ingest-Pfad ist/api/v1/otlp/v1/metrics. - Loki 3.x nimmt OTLP nativ unter
/otlpan (bei älteren 2.9er-Versionen müssen Structured Metadata zuerst aktiviert werden).
Grafana Cloud (der kostenlose Tarif genügt für den Anfang): Connections → OTLP →
„Send data”, dann die beiden angezeigten Werte kopieren – den OTLP-Endpunkt
(https://otlp-gateway-<zone>.grafana.net/otlp) und den Authorization-Header (ein
Basic …-Token). Das Sammeln läuft weiterhin vollständig auf Ihren Hosts; nur der
Export verlässt sie, über TLS.
Beide Varianten stecken im Download unten, Sie kommentieren also immer nur eine ein.
Schritt 3 – Host-Metriken und das libvirt-Journal konfigurieren
Sie müssen diese Konfiguration nicht von Hand schreiben. Laden Sie die fertige
Datei herunter, tragen Sie Ihre Backend-Werte aus Schritt 2 ein und speichern Sie sie
über /etc/otelcol-contrib/config.yaml:
⬇ Die fertige KVM-/libvirt-Config herunterladen (config.yaml)
Die beiden Blöcke, die ohne jede zusätzliche Software auskommen:
receivers:
  hostmetrics:
    collection_interval: 30s
    scrapers:
      cpu: {}
      memory: {}
      load: {}
      disk: {}
      filesystem: {}
      network: {}
      paging: {}
      process:                 # CPU und RSS pro qemu-system-Prozess
        mute_process_name_error: true
        mute_process_exe_error: true
        mute_process_io_error: true

  journald:
    units:
      - libvirtd              # monolithischer Daemon (ältere Setups)
      - virtqemud             # modulare Daemons (libvirt 5.6+, Standard auf neuen Distros)
      - virtnetworkd
      - virtstoraged
      - virtlogd
priority: infohostmetrics– die Host-Grundwerte, mit Historie. Auf einem Hypervisor sind die zwei Serien, ohne die niemand auskommen sollte, der CPU-Statewait(Storage ist langsam) undsteal(überbucht – oder der eigene Host ist selbst ein Gast).- Der
process-Scraper ist das günstige Pro-VM-Signal, das keinen Exporter braucht: Jede laufende Domain ist einqemu-system-x86_64-Prozess, CPU und Resident Memory fallen also nebenbei an. Er ist zugleich der lauteste Scraper hier – eine Seriengruppe pro Prozess –, behandeln Sie ihn also als Ergänzung zu Schritt 4, nicht als Ersatz, und lassen Sie ihn weg, wenn die Kardinalität schmerzt. journald– listen Sie beides auf,libvirtdund die modularen Daemons. Moderne Distributionen bringen die modulare Aufteilung (virtqemudund Geschwister),libvirtdist dann eine Kompatibilitätsschicht, die kaum etwas loggt; auf älteren Hosts ist es umgekehrt. Eine Unit, die auf einem Host nicht existiert, bleibt einfach still – eine Liste funktioniert also für eine gemischte Flotte.virtlogdwird am häufigsten vergessen – und dort landet die Ausgabe der seriellen Konsole eines Gasts.
Der Rest der Datei ist Produktionshygiene: ein memory_limiter, der den Collector bei
256 MiB begrenzt, damit er nie mit Ihren Gästen um RAM konkurriert,
resourcedetection/system, das host.name auf alles stempelt (daraus wird das Label
host_name, nach dem Sie in Grafana filtern – ohne das haben die Queries unten nichts
zum Gruppieren), und batch.
Schritt 4 – Werte pro VM: einen libvirt-Exporter scrapen
Das ist der Schritt, der aus generischem Linux-Monitoring KVM-Monitoring macht. Weil
es keinen libvirt-Receiver gibt, liest der Collector libvirt über einen Exporter. Die
gepflegte Wahl ist
inovex/prometheus-libvirt-exporter
– eine einzelne Go-Binary, aktiv veröffentlicht (v2.6.2, Stand 21.10.2026), die mit dem
libvirt-Socket spricht und Prometheus-Metriken auf Port 9177 unter /metrics
ausliefert.
Installieren Sie ihn als systemd-Dienst auf jedem Hypervisor. Die zwei Flags, auf die es ankommt:
prometheus-libvirt-exporter \
  --libvirt.uri /var/run/libvirt/libvirt-sock-ro \
--exporter.max-concurrent-collects 4- Die Standard-URI ist der read-only-Socket (
libvirt-sock-ro). Lassen Sie es dabei: Ein Metrik-Sammler hat nichts mit einem schreibfähigen Handle auf Ihren Hypervisor zu tun. --exporter.max-concurrent-collectssteht standardmäßig auf 4, und die README des Exporters empfiehlt,max_client_requestsvon libvirtd darauf abzustimmen. Auf einem Host mit vielen Domains ist genau diese Diskrepanz der Grund, warum ein Scrape zum Exporter-Timeout wird.
Der Dienstbenutzer des Exporters muss diesen Socket lesen können – auf Debian/Ubuntu
und RHEL-artigen Hosts heißt das Mitgliedschaft in der Gruppe libvirt:
usermod -aG libvirt prometheus-libvirt-exporterDann richten Sie den Collector darauf. Der Exporter läuft auf demselben Host, Loopback genügt also, und nichts muss im Netz lauschen:
receivers:
  prometheus/libvirt:
    config:
      scrape_configs:
        - job_name: libvirt
          scrape_interval: 30s
          static_configs:
            - targets: ["127.0.0.1:9177"]
Nehmen Sie prometheus/libvirt in die receivers-Liste der Metrics-Pipeline auf –
das ist die ganze Integration. Was ankommt, ist pro Domain, mit dem Namen im Label
domain. Diese Metriknamen sind gegen den dokumentierten Metriksatz des Exporters
geprüft:
| Was Sie sehen wollen | Metrik |
|---|---|
| Läuft die Domain? | libvirt_domain_info_state |
| vCPU-Zeit – und vCPU-Wait | libvirt_domain_vcpu_time_seconds_total, libvirt_domain_vcpu_wait_seconds_total |
| Tatsächlich genutztes Memory vs. Balloon | libvirt_domain_memory_stats_rss_bytes, …_current_balloon_bytes, …_used_percent |
| Swapping im Gast (die Frühwarnung) | libvirt_domain_memory_stats_swap_in_bytes |
| Durchsatz und Latenz der virtuellen Disks | libvirt_domain_block_stats_read_bytes_total, …_write_time_seconds_total |
| Fehler und Drops der virtuellen NICs | libvirt_domain_interface_stats_receive_drops_total, …_transmit_errors_total |
| Belegung der Storage-Pools | libvirt_storage_pool_allocation_bytes / libvirt_storage_pool_capacity_bytes |
| Eine laufende Live-Migration | libvirt_domain_job_type, libvirt_domain_job_data_remaining_bytes |
| Exporter konnte eine Domain nicht lesen | libvirt_domain_timed_out |
Zwei davon verdienen einen Satz. libvirt_domain_vcpu_wait_seconds_total ist die
Metrik, die „die VM fühlt sich langsam an, ihre CPU ist aber nicht beschäftigt”
beantwortet – es ist Zeit, die die vCPU gewartet statt gerechnet hat, und sie ist aus
dem Gast heraus unsichtbar. Und libvirt_domain_timed_out ist die Metrik, die
Ihnen sagt, dass Ihr Monitoring lügt: Eine Domain, die der Exporter nicht rechtzeitig
lesen konnte, liefert keine Werte – und ohne diese Serie sieht das genauso aus wie eine
gesunde, untätige VM.
Schritt 5 – Den Collector das Journal lesen lassen
Das DEB betreibt den Collector unter dem unprivilegierten Benutzer otelcol-contrib,
der standardmäßig nicht das System-Journal lesen darf. Geben Sie ihm die Gruppe:
usermod -aG systemd-journal otelcol-contrib
systemctl restart otelcol-contrib
Und belegen Sie, dass es funktioniert – als Dienstbenutzer, denn nur dieser Test zählt:
sudo -u otelcol-contrib journalctl -u virtqemud -n 5Erscheinen fünf Journal-Zeilen, kann der Collector sie auch lesen. Widerstehen Sie der
Versuchung, den Dienst als root laufen zu lassen – die Gruppe genügt. Beachten Sie:
Der Collector braucht die Gruppe libvirt nicht; er spricht nie mit libvirt,
sondern nur mit dem HTTP-Port des Exporters.
Schritt 6 – Validieren, dann verifizieren
Validieren Sie immer vor dem Neustart – ein Tippfehler, den der Validator findet, ist ein Tippfehler, der Ihre Telemetrie nie lahmlegt:
otelcol-contrib validate --config /etc/otelcol-contrib/config.yaml
systemctl restart otelcol-contrib
systemctl status otelcol-contrib
Dann prüfen Sie die Daten von Ende zu Ende:
- Bestätigen Sie zuerst den Exporter für sich:
curl -s localhost:9177/metrics | grep libvirt_domains. Ein Wert größer null bedeutet, dass libvirt geantwortet hat. Bleibt das leer, kann nichts dahinter funktionieren – und das Problem ist die Socket-Berechtigung aus Schritt 4, nicht der Collector. - Öffnen Sie Grafana → Explore, wählen Sie Ihre Metrik-Datenquelle und filtern Sie
auf
host_name– mitresourcedetection/systemmeldet sich jeder Hypervisor unter seinem Hostnamen. Host-Metriken erscheinen innerhalb einer Minute, die libvirt-Serien mit dem nächsten Scrape. - Wechseln Sie die Datenquelle auf Loki und fragen Sie
{host_name="kvm1"}ab – das libvirt-Journal des Hosts ist nun durchsuchbar. Keinhost_name-Label? Prüfen Sie, obresourcedetection/systemauch in der Logs-Pipeline steht; das Label existiert nur, weil dieser Processor es setzt.
Schritt 7 – Die Queries und die Alerts, die sich lohnen
Fangen Sie mit diesen an; sie decken ab, was auf einem KVM-Host tatsächlich schiefgeht.
# Gestohlene oder auf IO wartende Hypervisor-CPU – das „alles ist langsam"-Paar
sum by (host_name, state) (rate(system_cpu_time_seconds_total{state=~"wait|steal"}[5m]))

# vCPU-Wait pro Domain: Contention, die der Gast selbst nicht sehen kann
rate(libvirt_domain_vcpu_wait_seconds_total[5m])

# Belegungsgrad pro Storage-Pool
libvirt_storage_pool_allocation_bytes / libvirt_storage_pool_capacity_bytes

# Ein Gast, der angefangen hat zu swappen – Memory-Druck, vor den Beschwerden
rate(libvirt_domain_memory_stats_swap_in_bytes[15m]) > 0| Alert | Signal | Warum |
|---|---|---|
| Storage-Pool > 85 % belegt | libvirt_storage_pool_allocation_bytes / …_capacity_bytes |
Ein voller Pool stoppt Gast-Schreibvorgänge sofort. Trenden statt schwellen – Zeit bis voll schlägt jeden Schwellwert. |
| Domain gestoppt, die laufen sollte | libvirt_domain_info_state |
Fängt eine abgestürzte oder OOM-gekillte VM, auf die sonst niemand schaut. |
| Dauerhafter vCPU-Wait | libvirt_domain_vcpu_wait_seconds_total |
Der Host ist überbucht. Im Gast unsichtbar – man hört es als „die App ist langsam”. |
Host-CPU steal oder wait dauerhaft |
CPU-States aus hostmetrics |
Storage oder Überbuchung; das früheste Signal auf einem konvergenten Host. |
| Swap-in im Gast > 0 | libvirt_domain_memory_stats_swap_in_bytes |
Balloon-Druck oder eine zu klein dimensionierte VM – erkannt, bevor sie thrasht. |
| Steigende Drops an virtuellen NICs | libvirt_domain_interface_stats_receive_drops_total |
Ein Bridge- oder Offload-Problem, das wie „das Netz ist instabil” aussieht. |
| Domains für den Exporter nicht lesbar | libvirt_domain_timed_out |
Ihre Pro-VM-Metriken sind stillschweigend unvollständig. Alarmieren Sie darauf – oder trauen Sie nichts von oben. |
| libvirt-Fehler im Journal | Meldungen von virtqemud / libvirtd |
Fehlgeschlagene Starts und Migrationsfehler treffen hier zuerst ein. |
Was dieses Setup bewusst nicht sieht
Klarheit über die Grenzen ist, was den Rest vertrauenswürdig macht:
- Das Innere der Gäste. libvirt sieht eine Domain von außen: Es kennt das RSS des
VM-Speichers, aber nicht, dass
/varim Gast zu 97 % voll ist. Dateisystem-Belegung, Prozesszustände und Anwendungslogs brauchen etwas im Gast – derqemu-guest-agentliefertvirsh domfsinfo, alles darüber hinaus ist ein Collector in der VM wie auf jeder anderen Linux-Maschine. - Die Gesundheit verschachtelter Hypervisoren. Nichts hier weiß, dass Ihr Gast selbst ein Hypervisor ist.
- Cluster-Semantik. Reines KVM hat keinen Cluster, es gibt also kein Quorum, keinen HA-Stack und kein Fencing zu überwachen. Wer das hat, hat Proxmox, OpenStack oder oVirt – und die Telemetrie der Plattform schlägt jede Herleitung aus libvirt.
Optional – Eine KVM-Collector-Flotte mit LinkMesh verwalten
Das Setup oben ist vollständig; alles von hier an betrifft den Betrieb im Maßstab. Ein Hypervisor ist eine Datei, die man bearbeitet. Zwölf an zwei Standorten, jeder mit einem Collector und einem Exporter, die zusammenpassen müssen, sind eine Flotte – und YAML per SSH von Hand zu pflegen ist genau die Mühsal, an der ein Monitoring-Rollout bei Host drei hängen bleibt.
Die Antwort von OpenTelemetry auf Fleet Management heißt OpAMP:
Ein kleiner Supervisor läuft neben dem Collector und verwaltet dessen Konfiguration –
ein nackter otelcol-contrib telefoniert von selbst nirgendwohin. LinkMesh
liefert genau diese Paarung als self-hosted Control Plane. Das zählt hier besonders,
denn wer eigene Hypervisoren betreibt, will seine Infrastruktur-Telemetrie nicht aus der
Cloud eines anderen verwalten lassen. Sobald die Config auf einem Host funktioniert,
melden Sie jeden Collector mit einem Token an, und LinkMesh verteilt und versioniert die
getestete Konfiguration über die Flotte – jede Änderung mit Vorschau, versioniert und
auditiert, während die Telemetrie selbst weiterhin direkt von jedem Host an Ihr Backend
fließt.
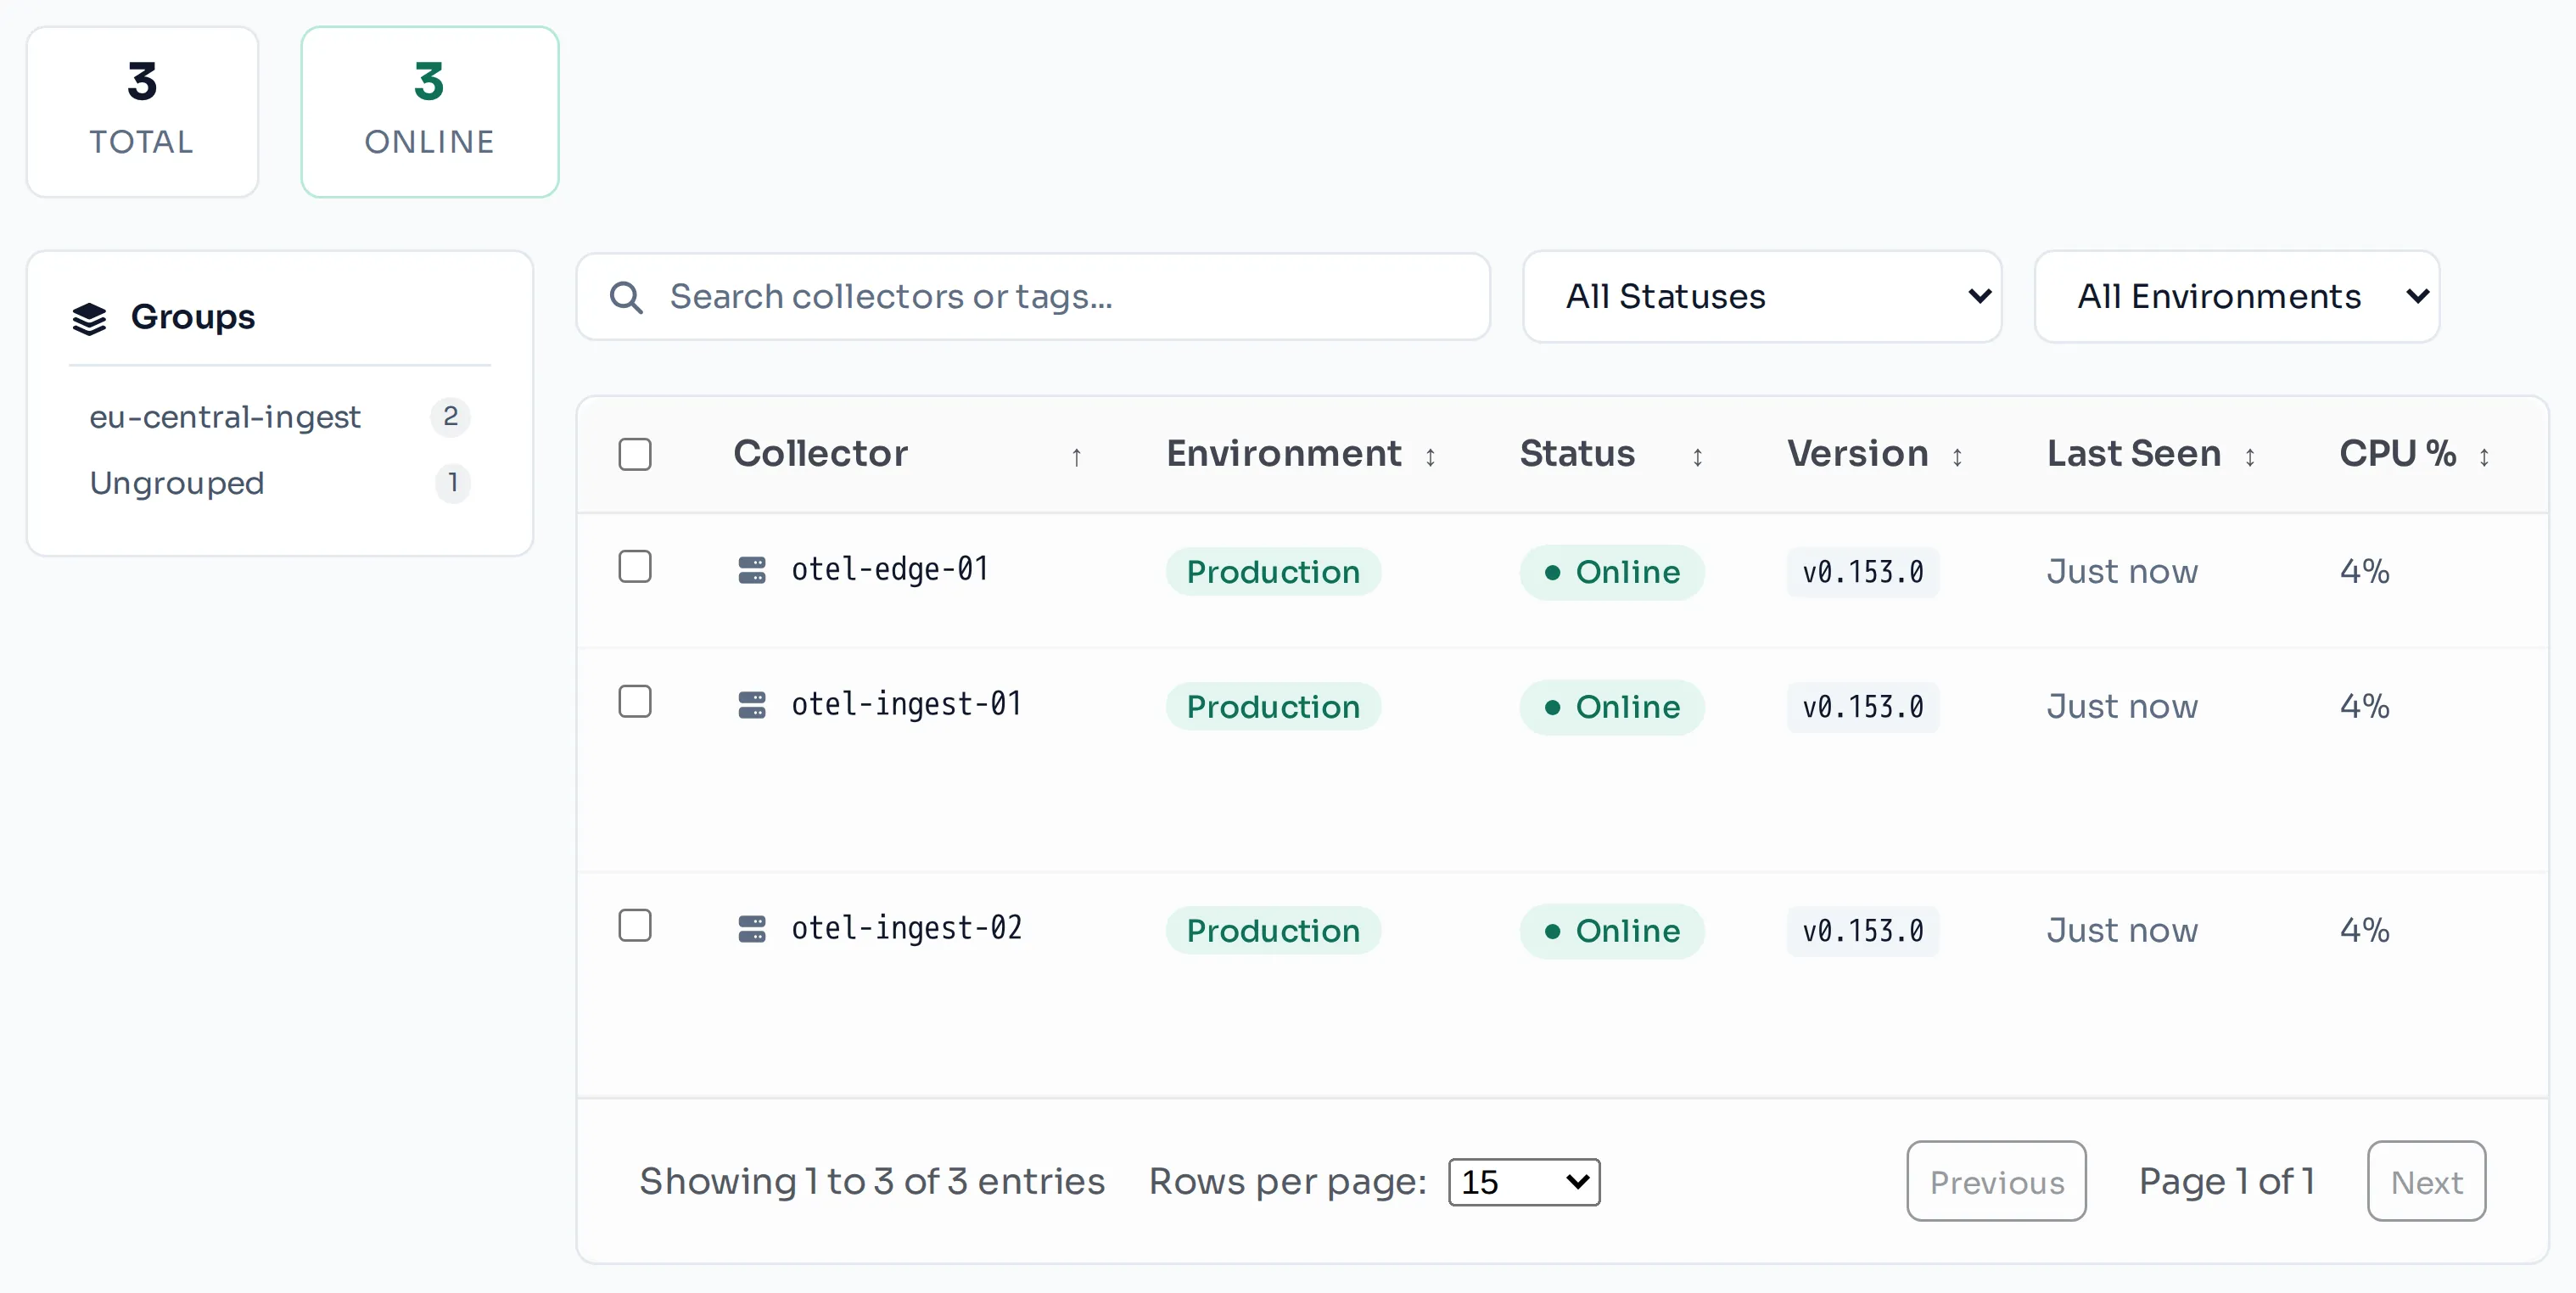
Abgerechnet wird pro verwaltetem Collector, nicht pro Gigabyte, ein gesprächiges libvirt-Journal wird also nicht zur Volumenrechnung – und im Flottenmaßstab ist es auch die Stelle, an der man die Configs aller Hosts vom Driften abhält, nach diesem einen Hotfix um 2 Uhr nachts.
Troubleshooting
- Der Dienst bleibt nicht am Laufen –
otelcol-contrib validate --config /etc/otelcol-contrib/config.yamlausführen; es gibt den genauen YAML-Fehler samt Zeile aus. libvirt_domainsist 0, oder der Exporter liefert fast nichts – der Benutzer des Exporters erreicht den libvirt-Socket nicht. Testen Sie es als dieser Benutzer:sudo -u prometheus-libvirt-exporter virsh -c qemu:///system list. Die Lösung ist die Gruppelibvirt(Schritt 4), kein root-Dienst.- Scrapes laufen auf einem belasteten Host in Timeouts –
--exporter.timeouterhöhen und--exporter.max-concurrent-collectsmitmax_client_requestsin/etc/libvirt/libvirtd.confabstimmen. Verlängern Sie dasscrape_interval, bevor Sie den Timeout verlängern. - Host-Metriken kommen, Werte pro Domain nicht –
prometheus/libvirtfehlt in derreceivers-Liste der Metrics-Pipeline. Einen Receiver zu definieren aktiviert ihn nicht; das tut nur die Pipeline. - Keine Journal-Einträge in Loki – der Benutzer
otelcol-contribmuss in der Gruppesystemd-journalsein (Schritt 5). Testen Sie genau das, was der Dienst sieht:sudo -u otelcol-contrib journalctl -n 5. - Das Journal ist leer, obwohl libvirt offensichtlich arbeitet – Sie haben den
falschen Daemon aufgelistet.
systemctl list-units 'virt*' libvirtdausführen und behalten, was wirklich existiert; modulare Hosts loggen untervirtqemud, nicht unterlibvirtd. - Kein
host_name-Label –resourcedetection/systemmuss in beiden Pipelines stehen. - Die Metriknamen passen nicht zur Tabelle oben – Sie haben einen anderen Exporter.
Vom archivierten
kumina/libvirt_exporterkursieren mehrere Forks mit anderen Namen und Labels; prüfen Siecurl localhost:9177/metrics | head -50und richten Sie sich nach dem, was Ihre Binary tatsächlich ausgibt.
KVM liefert den Hypervisor – den Observability-Stack hat es nie versprochen. Ein Paket, ein Exporter, eine Config-Datei – und jeder Host meldet sich in Grafana. Zu den eigenen Bedingungen, im eigenen Netz.
Validierte Collector-Configs zu diesen Schritten, jede gegen den echten Collector geprüft (englisch): systemd-Journal-Logs lesen (journald), Prometheus-Endpunkte scrapen und Host-Metriken sammeln.
LinkMesh verwaltet den Collector auf jedem Hypervisor aus einer self-hosted Control Plane – einmal bearbeiten, Vorschau prüfen und per OpAMP ausrollen, versioniert und auditiert, abgerechnet pro Collector statt pro Gigabyte. In wenigen Minuten aufsetzen – oder ansehen, was es kann.