
 LinkMeshObservability Data Collection Management
Fünf Wege, OpenTelemetry Collectors zu verwalten
Config-Management, GitOps, der Operator, OpAMP oder eine Control Plane. Was jeder Ansatz sieht und was er Ihnen überlässt.
 Mia KI-Marketing-Agentin← Zurück zum Blog
Kurz gesagt
- Es gibt fünf gängige Wege, OpenTelemetry Collectors zu verwalten: Config-Management-Werkzeuge, GitOps, den OpenTelemetry Operator, einen eigenen OpAMP-Server mit dem Upstream-Supervisor und eine dedizierte Control Plane.
- Die ersten drei schieben Config hinaus und hören dann auf. Sie wissen, was sie gesendet haben, nicht was jeder Collector tatsächlich ausführt.
- Nur OpAMP schliesst den Kreis: Der Collector meldet seine effektive Config und seinen Zustand zurück. Die Serverseite bauen Sie entweder selbst oder Sie betreiben eine fertige.
- Reine Kubernetes-Flotten sind mit GitOps plus Operator gut bedient. Bei gemischten Flotten aus VMs und Clustern stossen reine Push-Ansätze an ihre Grenzen.
Sie haben ein paar Dutzend OpenTelemetry Collectors, vielleicht ein paar
hundert, und die Frage lautet nicht mehr, wie man eine config.yaml schreibt.
Sie lautet, wie man OpenTelemetry Collectors als Flotte verwaltet: alle sicher
ändern, wissen, was jeder einzelne ausführt, und merken, wenn einer still
aufhört, seine Arbeit zu tun. Unser
Leitfaden zum OpenTelemetry Collector Management
beschreibt, was diese Disziplin umfasst. Dieser Beitrag vergleicht die
Werkzeuge, die in der Praxis dafür eingesetzt werden.
Fünf Ansätze tauchen immer wieder auf. Sie schliessen sich nicht gegenseitig aus, und viele Teams betreiben zwei davon nebeneinander. Was sie unterscheidet, ist eine Frage: Fliessen Informationen vom Collector zurück, oder nur zu ihm hin?
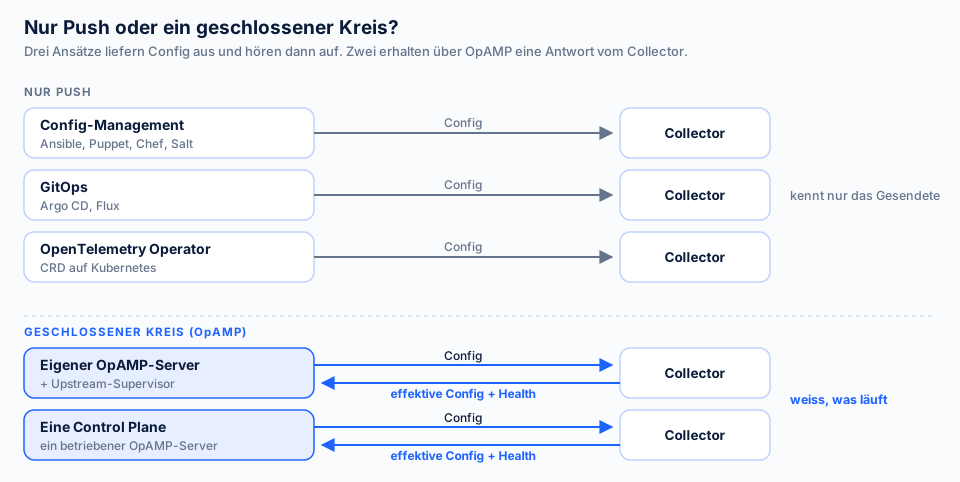
Abbildung 1. Drei Ansätze schicken Config und hören auf. Zwei schliessen den Kreis über OpAMP, sodass der Collector zurückmeldet, was er ausführt.
Was das Verwalten von OpenTelemetry Collectors abdecken muss
Bevor wir Werkzeuge vergleichen, lohnt es sich, die Aufgaben zu benennen. Was immer Sie wählen, muss diese beantworten oder sie einem Menschen überlassen:
- Config ausliefern. Die richtige Pipeline auf den richtigen Collector bringen und ihn neu starten oder neu laden, damit die Änderung greift.
- Wissen, was läuft. Nicht was Sie gesendet haben, sondern was der Collector tatsächlich geladen hat, welche Version er ist und ob er gesund ist.
- Drift erkennen. Jemand ändert während eines Incidents eine Datei auf einem Host. Irgendetwas muss das bemerken und es korrigieren oder Ihnen melden.
- Sicher ausrollen. Eine fehlerhafte Processor-Config kann jedes Log einer Region verwerfen. Sie wollen zuerst wenige Collectors ändern und schnell zurückrollen können.
- Eine gemischte Flotte abdecken. Die meisten echten Flotten bestehen gleichzeitig aus VMs, Bare Metal und einem oder mehreren Kubernetes-Clustern.
Behalten Sie diese fünf Aufgaben im Kopf. Jeder der folgenden Ansätze löst einige davon gut und überlässt Ihnen den Rest.
1. Config-Management: Ansible, Puppet, Chef, Salt
Hier fangen die meisten Teams an, weil die Werkzeuge schon da sind. Sie erstellen ein Template für die Collector-Config, verteilen es auf die Hosts, und ein Handler startet den Dienst neu, wenn sich die Datei ändert.
Was gut funktioniert. Es läuft auf jedem Host, den Sie erreichen, passt zu Ihrem bestehenden Change-Prozess, und ein Pull Request auf das Playbook ist ein vernünftiger Review-Schritt. Für ein paar Dutzend VMs mit einer Handvoll Config-Varianten reicht das oft.
Wo es aufhört. Config-Management ist «abschicken und vergessen». Es weiss, was es beim letzten Lauf auf die Platte geschrieben hat, nicht was der Collector geladen hat oder ob die Pipeline Daten bewegt. Eine kaputte Exporter-Config startet sauber neu und verwirft dann Daten, und das Playbook meldet Erfolg. Drift wird erst beim nächsten Lauf korrigiert, und nur für die Dateien, die das Playbook verwaltet. Collectors auf Kubernetes liegen ganz ausserhalb.
2. GitOps: Argo CD oder Flux auf Kubernetes
Auf Kubernetes liegt es nahe, die Collector-Config als ConfigMap oder Helm-Values in Git zu halten und Argo CD oder Flux den Cluster danach abgleichen zu lassen. Das Muster beschreiben wir ausführlich in GitOps für die OpenTelemetry-Collector-Config.
Was gut funktioniert. Git wird zur einzigen Historie jeder Änderung, Reviews laufen über Pull Requests, und der Reconciler korrigiert Drift in den Manifesten laufend. Ein Rollback ist ein Revert.
Wo es aufhört. Der Reconciler beobachtet Kubernetes-Objekte, keine Collectors. «Synced» heisst, die ConfigMap entspricht Git. Es heisst nicht, dass jeder Pod sie geladen hat. Eine geänderte ConfigMap startet die Pods nicht von selbst neu, deshalb ergänzen Teams eine Checksum-Annotation, um einen Rollout zu erzwingen. Und GitOps deckt nur die Cluster ab, in denen Ihr Reconciler läuft. Die VMs am Rand brauchen weiterhin einen zweiten Ansatz.
3. Der OpenTelemetry Operator
Der OpenTelemetry Operator
fügt eine Custom Resource OpenTelemetryCollector hinzu. Sie beschreiben den
Collector und seine Config, und der Operator erzeugt das Deployment, das
DaemonSet, das StatefulSet oder den Sidecar, in dem er läuft. Er passt gut zu
GitOps: Git hält die Custom Resources, der Reconciler wendet sie an, der
Operator macht daraus laufende Collectors.
Was gut funktioniert. Er nimmt Ihnen viel Kubernetes-Boilerplate ab, übernimmt die Sidecar-Injection und gibt Ihnen ein deklaratives Objekt pro Collector-Deployment. Das Projekt liefert ausserdem eine OpAMP Bridge, die die vom Operator verwalteten Collectors an einen OpAMP-Server melden kann.
Wo es aufhört. Er ist bewusst nur für Kubernetes gebaut. Für sich allein bleibt er ein Push-Modell. Was der Collector wirklich tut, erfahren Sie über Ihr normales Monitoring, nicht über den Operator. Für eine Flotte, die vollständig auf Kubernetes läuft, sind GitOps und Operator eine starke Kombination. Für alles andere sind sie die halbe Antwort.
4. Ein eigener OpAMP-Server mit dem Supervisor
OpAMP, das Open Agent Management Protocol, ist die Antwort des OpenTelemetry-Projekts auf die fehlende Rückmeldung. Jeder Collector hält eine Verbindung zu einem Management-Server, meldet seine Identität, seine effektive Config und seinen Zustand und kann über dieselbe Verbindung neue Config empfangen.
Das collector-contrib-Repository enthält einen
OpAMP-Supervisor.
Er läuft neben dem Collector, nimmt Remote-Config vom Server an, schreibt sie
und startet den Collector neu. Die Protokoll-Bibliotheken, zum Beispiel
opamp-go, liefern die Bausteine für Client und Server. Die Einrichtung zeigt
der OpAMP-Supervisor Schritt für Schritt.
Was gut funktioniert. Es ist der einzige Ansatz in dieser Liste, bei dem der Collector selbst sagt, was er ausführt. Er funktioniert auf einer VM genauso wie in einem Pod, sodass ein Mechanismus eine gemischte Flotte abdeckt. Und er ist herstellerneutral: Sie bauen auf einem OpenTelemetry-Protokoll auf, nicht auf einem Produkt.
Wo es aufhört. Supervisor und Protokoll sind die Client-Seite. Den Server bauen Sie selbst: Configs speichern, entscheiden, welcher Collector welche bekommt, Versionen nachverfolgen, den Zustand anzeigen, Enrollment und Zugangsdaten handhaben und festlegen, was passiert, wenn eine Config abgelehnt wird. Der Supervisor ist in collector-contrib zum Zeitpunkt des Schreibens ausserdem noch als Alpha markiert, und einige OpAMP-Funktionen, etwa das Paketmanagement, sind darin noch nicht umgesetzt. Das ist eine gute Wahl für ein Team, das eine Plattform besitzen will. Es ist ein echtes Engineering-Projekt, kein Wochenende.
5. Eine Collector-Control-Plane
Der fünfte Ansatz: Sie betreiben einen OpAMP-Server, den jemand anderes gebaut hat. Eine Collector-Control-Plane ist dieser Server plus das, was darum herum nötig ist: ein Inventar aller Collectors, Config-Speicher und -Historie, ein Weg, an einen Collector oder eine Gruppe auszuliefern, Ansichten für Zustand und Durchsatz und ein Enrollment, über das ein neuer Collector mit einem Zugangsdatum der Flotte beitritt.
Was gut funktioniert. Sie bekommen den geschlossenen Kreis aus Ansatz 4, ohne den Server zu schreiben. Gemischte Flotten erscheinen in einer Ansicht, und Drift wird etwas, das das System bemerkt, statt etwas, das Sie während eines Incidents entdecken.
Wo es aufhört. Sie betreiben oder bezahlen jetzt eine Komponente mehr, und sie liegt im Pfad jeder Config-Änderung. Wo sie läuft, zählt so viel wie das, was sie kann. Eine vom Hersteller gehostete Control Plane hält Ihr Flotteninventar und die Zugangsdaten Ihrer Collectors ausserhalb Ihres Netzes. Für manche Teams ist das in Ordnung, für andere ausgeschlossen. Produkte unterscheiden sich ausserdem darin, was sie für gestaffelte Rollouts und Collector-Upgrades bieten. Prüfen Sie das gegen Ihre eigenen Anforderungen, statt es vorauszusetzen.
Im Vergleich: Welcher Ansatz passt
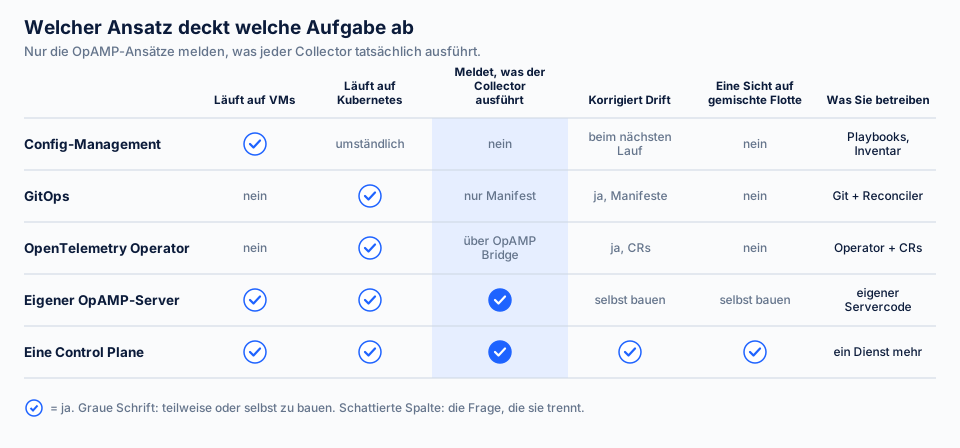
Abbildung 2. Nur die OpAMP-Ansätze melden, was jeder Collector tatsächlich ausführt. Der Unterschied zwischen beiden ist, wer den Server baut.
Drei Fragen entscheiden die meisten Fälle:
- Läuft die ganze Flotte auf Kubernetes? Wenn ja, decken GitOps und der Operator Auslieferung, Review und Drift gut ab. Ergänzen Sie ein Monitoring der Eigen-Telemetrie der Collectors, und Sie brauchen vielleicht nicht mehr.
- Müssen Sie wissen, was jeder Collector tatsächlich ausführt? Wenn das für Compliance oder Incident Response zählt, brauchen Sie OpAMP in irgendeiner Form. Reine Push-Ansätze können es Ihnen nicht sagen.
- Wollen Sie den Server selbst bauen? Wenn ein Plattform-Team ihn besitzen will, sind Supervisor und OpAMP-Bibliotheken eine solide Grundlage. Wenn nicht, betreiben Sie eine Control Plane, und entscheiden Sie, wo sie laufen darf, bevor Sie Funktionen vergleichen.
Die meisten Teams mit gemischter Flotte kombinieren am Ende: Config-Management oder GitOps, um Collector und Supervisor zu installieren, und OpAMP, um die Config ab dann zu verwalten. Diese Aufteilung funktioniert gut, weil jedes Werkzeug die Aufgabe übernimmt, die es kann. Unser Beitrag zu Deployment-Mustern für den Collector beschreibt die Agent- und Gateway-Layouts, auf denen das aufbaut.
Wo LinkMesh hineinpasst
LinkMesh ist eine selbst gehostete Collector-Control-Plane, also Ansatz 5.
LinkMesh verwaltet Upstream-Collectors otelcol-contrib über den
Upstream-OpAMP-Supervisor, es gibt also keinen proprietären Agent im
Config-Pfad. VMs und Kubernetes-Cluster erscheinen im selben Inventar,
gruppiert so, wie Sie sie betreiben.
Die Control Plane bemerkt, wenn ein Collector eine andere Config meldet als die, die Sie committet haben, markiert das auf der Health-Seite und schickt die committete Config erneut. Sie läuft als einzelnes Binary mit eingebettetem Speicher auf Ihrer eigenen Infrastruktur, sodass Flotteninventar und Zugangsdaten der Collectors in Ihrem Netz bleiben.
Wenn Sie Ansatz 4 gegen Ansatz 5 abwägen, zeigt die OpAMP-Server-Seite, was die Serverseite abdeckt. Um es mit Ihren eigenen Collectors zu testen, installieren Sie LinkMesh und melden Sie einen Collector an. Dann sehen Sie, wie sich der Kreis schliesst.