
 LinkMeshObservability Data Collection Management
PII vs CID
Erkennung allein findet nicht, was nur Ihre eigenen Kundendaten definieren.
 Philippe Braxmeier← Zurück zum Blog
Der Name einer Mitarbeiterin ist ein Personendatum. Der Name eines Firmenkunden ist es nicht — und ein Scanner, der auf das eine abgestimmt ist, läuft am anderen einfach vorbei.
Das ist keine Spitzfindigkeit. PII und CID liegen in verschiedenen rechtlichen Kategorien, sie werden durch verschiedene Tatsachen ausgelöst, und ein Live-Scanner — Regex, Allow-List, selbst ein LLM — kann die zweite Kategorie nicht vollständig abdecken. Nicht, weil die Technik unausgereift wäre, sondern weil das, womit er vergleichen müsste, kein Muster ist. Dieser Beitrag zeigt, warum diese Lücke existiert, was die veröffentlichten Erkennungszahlen tatsächlich darüber sagen und welcher eine Architekturschritt dafür sorgt, dass die Lücke keine Rolle mehr spielt.
Zwei rechtliche Kategorien, ein Scanner
PII — Personendaten nach DSGVO oder dem revidierten Schweizer Datenschutzgesetz (revDSG) — werden dadurch ausgelöst, wessen Daten es sind: die einer natürlichen Person. Der Name eines Mitarbeiters, die E-Mail-Adresse einer Privatkundin, eine Wohnadresse. CID — kundenidentifizierende Daten (Client Identifying Data) unter dem Schweizer Bankgeheimnis (Art. 47 BankG) und dem FINMA-Rundschreiben 2023/1 — werden dadurch ausgelöst, wessen Beziehung es ist: die eines Kunden einer Bank oder Versicherung, ob dieser Kunde eine natürliche Person oder ein Unternehmen ist.
Die beiden Kategorien überschneiden sich stellenweise und weichen dort ab, wo es darauf ankommt. Der Name eines Firmenkunden ist CID, nicht PII — keine natürliche Person, kein DSGVO-Auslöser, volle Exposition unter dem Bankgeheimnis. Der Name einer Mitarbeiterin ist PII, nicht CID — keine Kundenbeziehung, aber jede Datenschutzpflicht gilt. Setzen Sie einen auf PII abgestimmten Scanner ein, schützen Sie Ihr eigenes Personal, während jeder Datensatz eines Firmenkunden unmarkiert durchrutscht. Setzen Sie einen auf CID abgestimmten ein, passiert das Umgekehrte. Eine Kategorie abzuhaken und anzunehmen, sie decke die andere mit ab, ist die häufigste Lücke in diesem Bereich, und sie bleibt unsichtbar, bis jemand fragt, in welche Kategorie ein bestimmtes Feld fällt.
Auch das FINMA-Rundschreiben behandelt CID nicht als eine flache Kategorie. Wie BigID es zusammenfasst, gruppiert es Identifikatoren in drei Stufen danach, wie direkt sie einen Kunden identifizieren: direkte Identifikatoren wie Name, Adresse oder Unterschrift; indirekte Identifikatoren wie Konto-, Vertrags- oder Policennummer, die jemanden erst in Verbindung mit der ausgebenden Stelle identifizieren; und Daten, die nur in Kombination identifizierend sind — eine Postleitzahl, ein Geburtsjahr, eine Art der Beziehung —, einzeln nicht sensibel, zusammen sehr wohl. Bei dieser dritten Stufe hören die meisten Erkennungsstrategien still auf zu funktionieren, denn es gibt kein einzelnes Feld, das man markieren könnte.
Warum Mustererkennung CID nicht findet
Eine Regex oder eine Allow-List kann eine Schweizer AHV-Nummer oder eine IBAN erkennen — beide haben ein festes Format und eine Prüfziffer. Kundennummern, Kontonummern, Policennummern, Vertragsnummern, Schadennummern, Benutzer-IDs von Endkunden — der eigentliche Grossteil der CID in einer Telemetrie-Pipeline — haben weder das eine noch das andere. Jede Organisation hat ihr eigenes Nummernschema. Eine generische Regel für «6- bis 12-stellige Ziffernfolge» findet Kundennummern nicht präziser als Ticketnummern, Fehlercodes und Portnummern, und ein breiteres Muster tauscht nur falsch-negative gegen eine Flut falsch-positiver Treffer.
Die Standardantwort der DLP-Branche darauf ist Exact Data Match (EDM): die echten Kundenstammdaten in die Filterschicht laden und direkt damit vergleichen, statt ein Muster zu erraten. Das funktioniert — und es scheitert vollständig für alle, die gemeinsame Infrastruktur für mehrere Kunden bauen. Um exakt zu vergleichen, braucht eine EDM-Engine den zu schützenden Raum der Kundenidentifikatoren im filternden System selbst. Für einen Plattform- oder Pipeline-Anbieter heisst das, genau die Daten zu zentralisieren, die das ganze Vorhaben dezentral halten soll. Die Lösung würde die Exposition erzeugen, die sie verhindern soll.
Was die Erkennungszahlen tatsächlich sagen
Es ist verlockend anzunehmen, dass ein grosses Sprachmodell diese Lücke schliesst, wo Regex scheitert. Die veröffentlichten Benchmarks sagen: teilweise, aber nicht genug. Eine Evaluation von 2026 zu hybrider mehrsprachiger PII-Erkennung über 13 Sprachräume mass für ein klassisches, feinabgestimmtes NER-Modell einen gewichteten F1 von 0,36, für ein Zero-Shot-LLM ohne aufgabenspezifische Vorbereitung 0,56 und für eine Kombination aus deterministischen Regeln und kontextsensitivem LLM 0,66 — das beste Ergebnis der Studie, und noch immer ist ein Drittel der Treffer in irgendeiner Form falsch. In einem engeren, günstigeren Setting — englischsprachige Finanzdokumente, strukturiert genug, dass sowohl eine Regex-Schicht als auch ein trainiertes Modell gut abschneiden — erreichte ein hybrider Ansatz aus regelbasiertem NLP und ML auf einem synthetischen Benchmark 94,7 % Precision und 89,4 % Recall und fiel bei echten Prüfberichten und Lieferantenrechnungen auf rund 93 % Genauigkeit. Für einen kuratierten Dokumenttyp ist das ein wirklich starkes Ergebnis — und es bedeutet trotzdem, dass etwa jeder zehnte echte Treffer unmarkiert bleibt, bei Milliarden Log-Zeilen pro Tag statt bei einem Stapel Dokumente.
Unter den Genauigkeitszahlen liegt ein zweites Problem, das in keinem F1-Wert auftaucht: Ein externer KI-Dienst zur PII-Erkennung ist selbst eine Offenlegung. Log-Inhalte an ein fremdes Modell zu schicken, um zu prüfen, ob sie Daten enthalten, die Ihre Infrastruktur nie verlassen dürfen, heisst, dass sie sie bereits verlassen haben — in Richtung des Detektors. Das Werkzeug, das die Exposition verhindern soll, erzeugt genau die Exposition, die es erkennen soll, es sei denn, das Modell läuft vollständig innerhalb der Grenze, die Sie schützen wollen. Welche Precision ein Anbieter auch nennt: Prüfen Sie, wo die Inferenz tatsächlich stattfindet, bevor die Zahl irgendetwas an Ihrer Entscheidung ändert.
Der blinde Fleck der Observability
Alles oben Gesagte gilt für jede Log-Pipeline. Observability-Daten haben eine
strukturelle Besonderheit, die die meisten Texte über PII in Logs nicht erwähnen:
Die häufigsten Träger von CID stehen gar nicht im Log-Body — sie stehen in den
Resource-Metadaten. Ein Hostname mit einem Kundenkürzel (edge-acme-01), ein
Kubernetes-Namespace, der nach einem Mandanten benannt ist, der Common Name eines
Zertifikats — nichts davon sieht nach «sensiblen Daten» im üblichen Sinn aus, denn
Werkzeuge zur Inhaltsprüfung sind dafür gebaut, Nachrichteninhalte zu
untersuchen, und das hier sind Metadaten über die Nachricht. PII in Logs
maskieren behandelt die Maskierungsmuster, die bei
strukturierten, benannten Feldern gut funktionieren; hier geht es um die Schicht
darüber, in der schon die Feldnamen das Leck sind.
Freitext-Container verschärfen das Problem in die andere Richtung: Stacktraces,
ein rohes SQL-Statement mit literalen Werten in der WHERE-Klausel, ein
vollständiger Request- oder Response-Body. Nichts an ihrer Form sagt einem
Parser, wo der sensible Teil beginnt oder endet, also landet jede inhaltsbasierte
Methode wieder bei brüchigen Regex über unstrukturiertem Text. Und
base64-kodierte Payloads — immer häufiger, weil Dienste strukturierte Blobs durch
generische Transportfelder schicken — sind für jede inhaltsbasierte Methode
gleichzeitig undurchsichtig, ob musterbasiert oder modellbasiert. Es gibt nichts
zu vergleichen; bis zur Dekodierung sind es Binärdaten, und nichts in einer
Telemetrie-Pipeline dekodiert sie, bevor es sie weiterschickt.
Nichts davon ist grundsätzlich neu. Latanya Sweeneys grundlegende Studie zur Re-Identifikation zeigte, dass Postleitzahl, Geschlecht und Geburtsdatum allein 87 % der US-Bevölkerung eindeutig identifizieren — drei Felder, keines davon für sich sensibel, in Kombination vollständig identifizierend. Dieselbe Logik gilt für Resource-Attribute: Eine Region, ein Umgebungs-Tag und ein gekürztes Hostname-Fragment können gemeinsam einen einzelnen Mandanten isolieren, auch wenn jedes einzeln wie gewöhnliche Infrastruktur-Metadaten aussieht. Eine Erkennung, die auf Werte abgestimmt ist, verpasst eine Identifikation, die nur als Kombination existiert.
Die Lösung, die es im OpenTelemetry-Ökosystem bereits gibt, sind Trace- und Korrelations-IDs. Ein auf die Anfrage beschränkter, undurchsichtiger Identifikator erlaubt es, Telemetrie über Dienste hinweg zu korrelieren — nach Session gruppieren, eine Anfrage durchgängig verfolgen —, ohne dafür je eine Kundennummer mitzuführen. Das ist keine Notlösung; es ist der richtige Ersatz dafür, einen echten Identifikator in eine Log-Zeile zu schreiben, und in den meisten instrumentierten Systemen bereits gängige Praxis. Die Lücke ist nicht die Technik. Es sind die Resource-Labels und Freitextfelder, die nie durch sie hindurchgegangen sind.
Die Standards sagen das bereits
Keiner der Standards, die in diesem Bereich üblicherweise zitiert werden, behauptet, ein Scanner könne alles erkennen, und zusammen gelesen kommen sie zur selben Antwort: Schreiben Sie den rohen Identifikator gar nicht erst dorthin. Das OWASP Logging Cheat Sheet empfiehlt, einen gesalzenen Hash einer Session-ID zu loggen statt der ID selbst, genau damit die Korrelation erhalten bleibt, ohne dass der rohe Wert je in einem Log landet. PCI DSS Anforderung 3.4 verlangt, dass eine Kartennummer überall, wo sie gespeichert ist, unlesbar ist, Logs eingeschlossen — Kürzung, Hashing oder Tokenisierung, nie der Wert im Klartext. Und NIST SP 800-122 zieht unabhängig eine eigene Version der FINMA-Stufen: verknüpfte Informationen sind einer Person bereits zugeordnet, verknüpfbare Informationen könnten es sein, in der richtigen Kombination. Drei verschiedene Stellen, drei verschiedene Bereiche, dieselbe Schlussfolgerung — behandeln Sie die Grenze als Kontrolle, nicht die Prüfung.
Was das für die Pipeline bedeutet
Wenn Erkennung strukturell unvollständig ist — und ein gewichteter F1 von 0,66 unter grosszügigen, gut finanzierten Evaluationsbedingungen sagt genau das —, dann scheitert eine Compliance-Strategie, die darauf angewiesen ist, jeden Verstoss am Rand abzufangen, leise. Niemand bemerkt einen verpassten Regex-Treffer. Jemand bemerkt ihn bei einem Audit oder bei einem Vorfall, und dann haben die Daten die Grenze längst überquert.
Die Alternative ist nicht ein besserer Scanner. Sie besteht darin, nicht darauf angewiesen zu sein, dass der Scanner recht hat, weil die Entscheidung bereits vorher gefallen ist. Das heisst: festlegen, was ein Datenstrom tragen darf, wenn ein Collector onboardet wird, statt es bei jeder durchlaufenden Nachricht neu zu entscheiden — und die Routing-Entscheidung vor der Netzgrenze treffen, nicht danach.
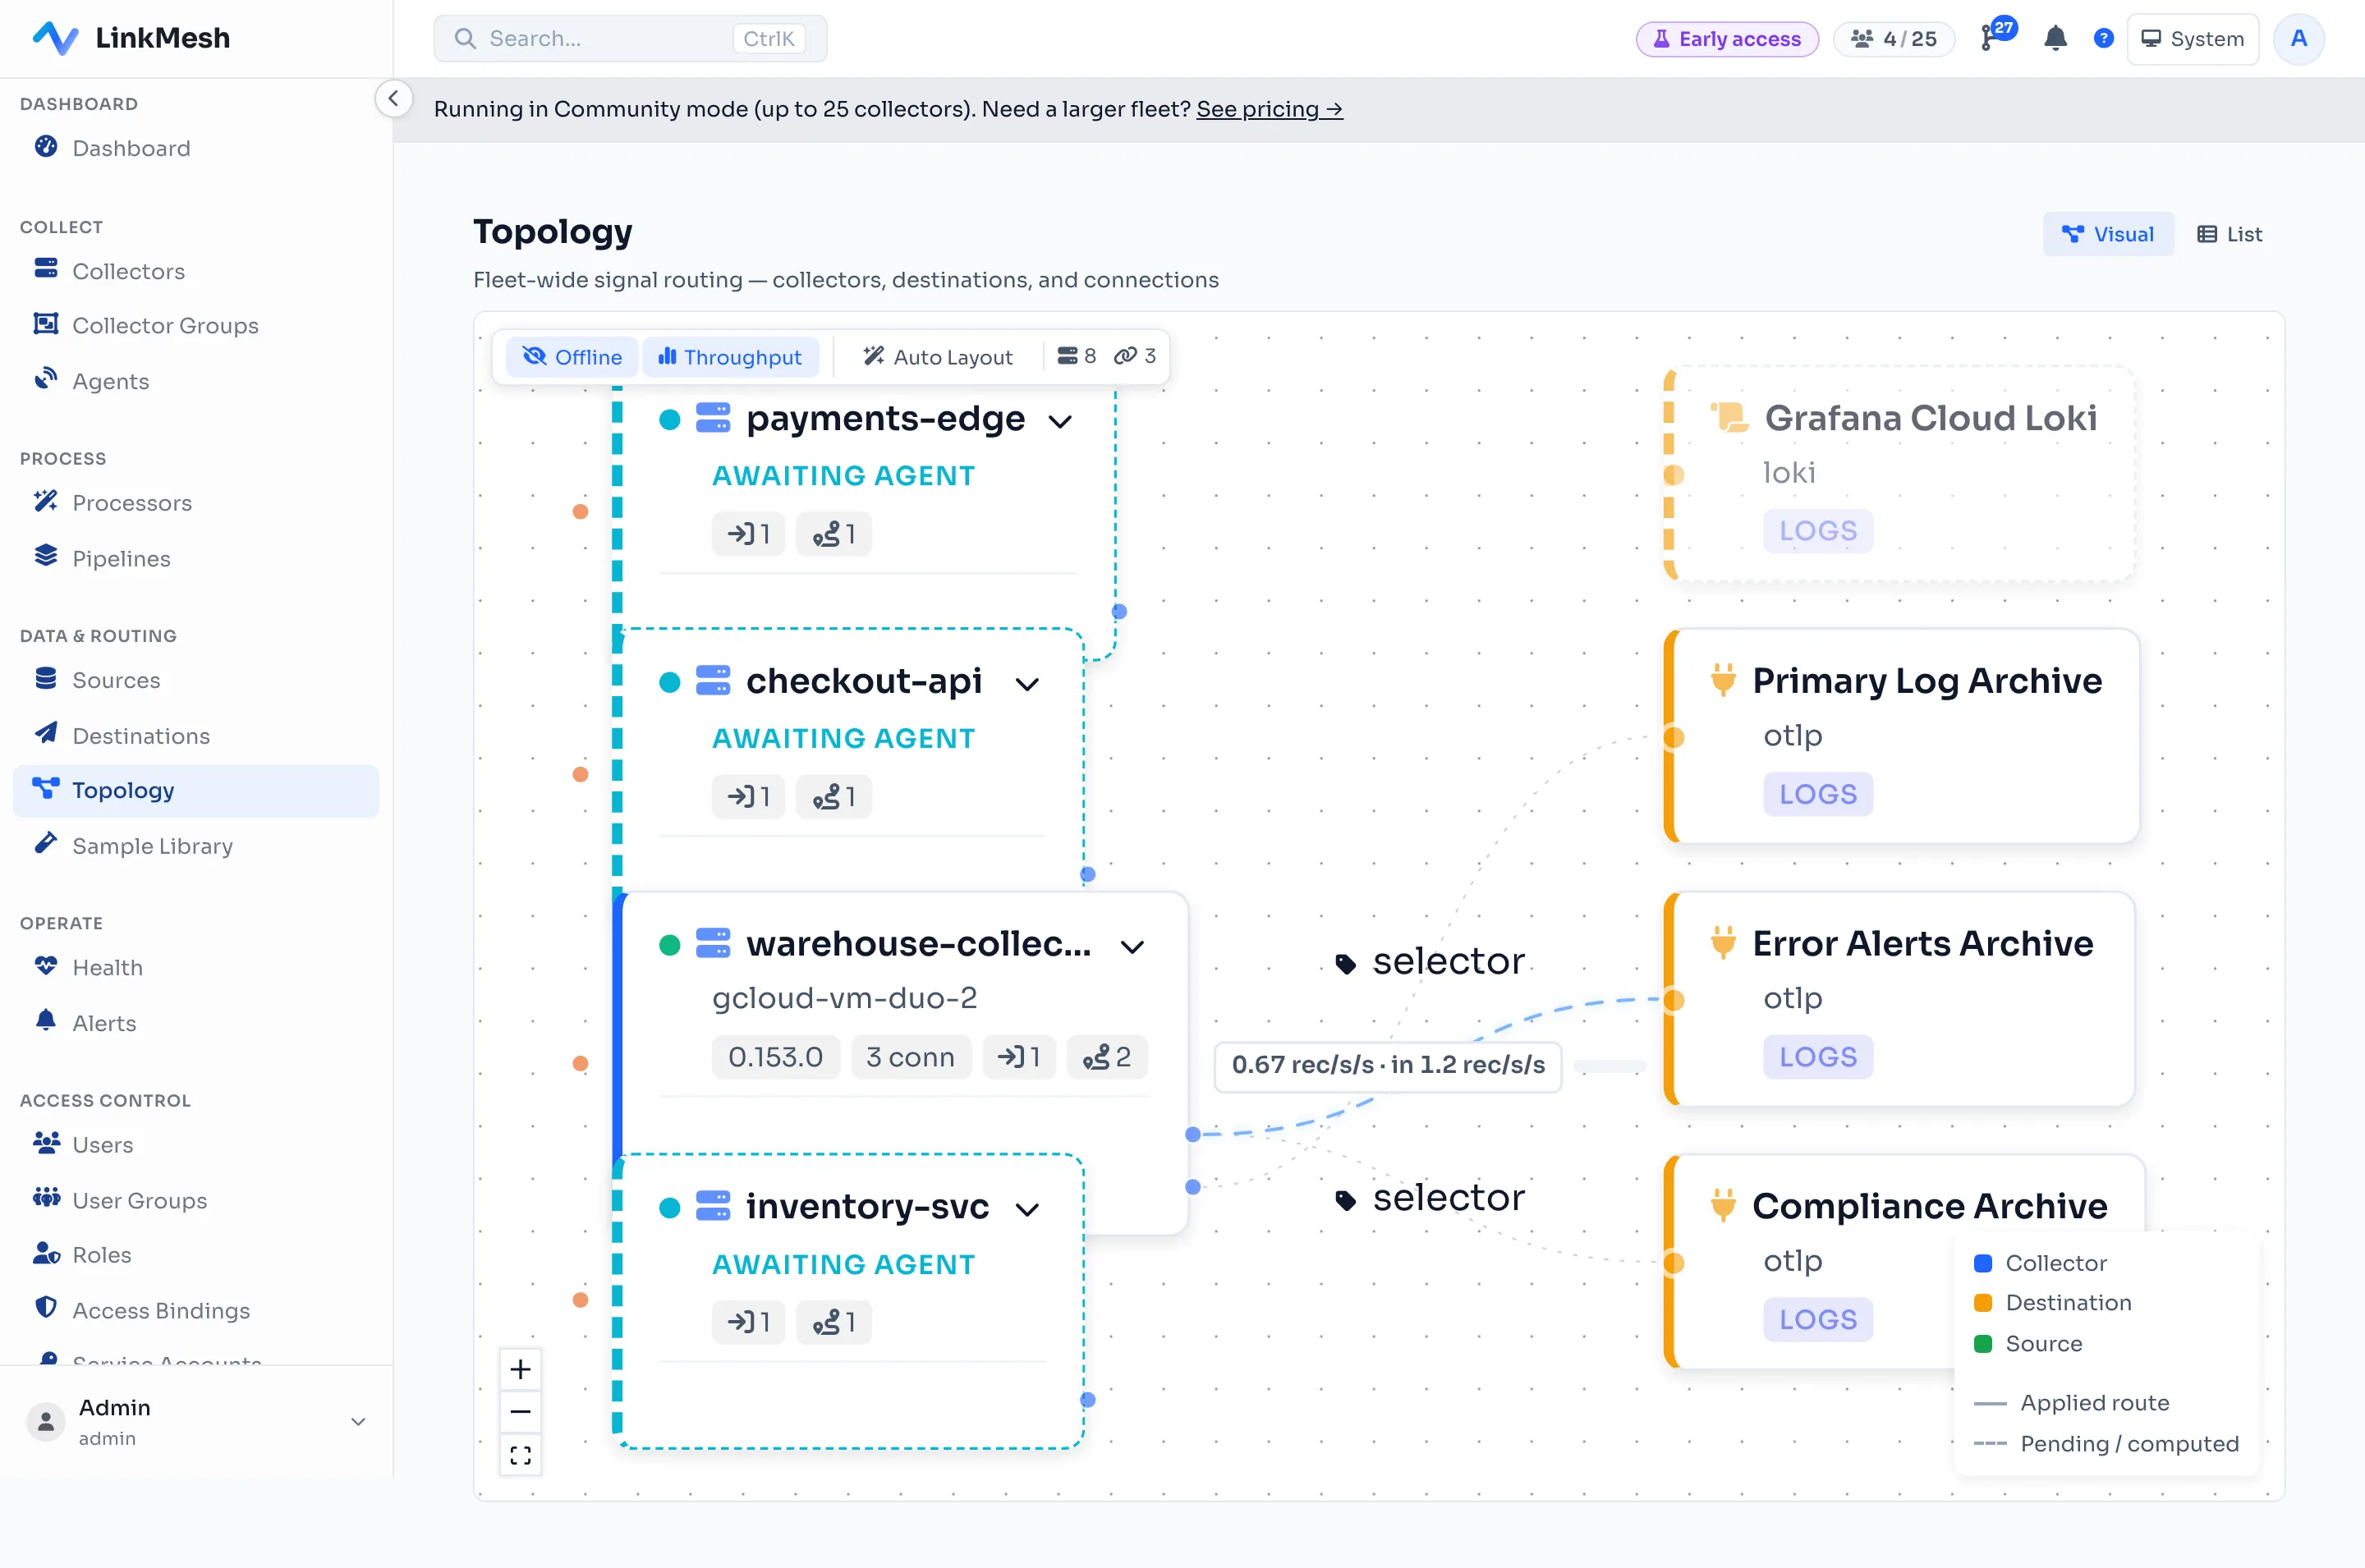
Dafür ist die Routing-Schicht von LinkMesh da, und es lohnt sich, genau zu sagen,
was sie heute tatsächlich tut, statt was schön wäre. Jede Route trägt einen
Matcher auf Resource-Attribute — gebaut über ein geführtes Formular mit Feld,
Operator und Wert, mit rohem OTTL als erweiterter Rückfalloption für Ausdrücke,
die der Builder nicht abdeckt — und eine labelbasierte Zielauswahl: Wer ein Ziel
mit einem Label versieht, hängt es automatisch an passende Routen. Markieren Sie
die Herkunft eines Datenstroms einmal beim Onboarding (welcher Collector, welcher
Namespace, zu welcher Kundengrenze er gehört), und jeder Datensatz daraus wird
gegen diese Klassifizierung ausgewertet, bevor er ein Ziel erreicht, ob selbst
gehostet oder nicht. Die Grenze gehört ehrlich benannt, denn ein Beitrag, der
Architektur über Erkennung stellt, sollte sich an denselben Massstab halten: Der
Ziel-Selektor kennt heute nur Gleichheit — keine Operatoren In, NotIn oder
Existenzprüfungen —, ein Selektor, der mehr als einen exakten Vergleich braucht,
ist also ein eigener, über die API geschriebener und nichts, was man auf dem
Canvas zeichnet. Das ist eine echte Grenze, keine versteckte.
Routing zählt nur, wenn der Control Plane, der die Entscheidung trifft, an einem Ort läuft, dem Sie vertrauen. Das ist die andere Hälfte: LinkMesh läuft als einzelnes Binary ohne Abhängigkeiten und mit eingebettetem Speicher, also läuft auch der Klassifizierungs- und Routing-Schritt selbst auf Infrastruktur, die Sie kontrollieren, nicht über einen Umweg durch die Cloud eines anderen. Das benachbarte Problem — Zugangsdaten statt Kundendaten — wird gleich behandelt: Secrets liegen in einem eingebauten Vault und werden erst bei der Auslieferung eingesetzt, nie in eine gespeicherte Config geschrieben oder in Git committet. Andere Daten, dasselbe Prinzip: Bauen Sie keine Kontrolle, die darauf angewiesen ist, dass zuerst etwas hinausgeht.
Nichts davon ersetzt das Maskieren auf Feldebene — es gehört weiterhin auf alles, was die Grenze absichtlich verlässt, und PII in Logs maskieren behandelt die Maskierungsmuster für diese Schicht. Der Unterschied liegt darin, was man jeder Schicht zutraut. Maskieren ist das richtige Werkzeug für Daten, bei denen Sie bereits entschieden haben, dass sie hinausdürfen. Es sollte nie das Werkzeug sein, das diese Entscheidung für Sie trifft — kein Scanner ist das, und jetzt gibt es veröffentlichte Zahlen, die das belegen. Klassifizieren Sie an der Quelle, routen Sie vor der Grenze, und die Frage, an der ein Detektor immer wieder scheitert, muss am Rand nicht mehr gestellt werden.
Das vollständige Modell der Datenverarbeitung finden Sie unter Vertrauen und Sicherheit, oder richten Sie eine Route auf Ihrer eigenen Infrastruktur ein: LinkMesh installieren.